10 Keşifçi veri analizi
10.1 Giriş
Bu bölümde, verilerinizi sistematik biçimde keşfetmek için görselleştirme ve dönüştürme araçlarını nasıl kullanacağınızı öğreneceksiniz. İstatistikçiler bu sürece keşifçi veri analizi (exploratory data analysis; EDA) adını verir. EDA yinelemeli bir döngüdür. Şunları yaparsınız:
Veriniz hakkında sorular üretirsiniz.
Verinizi görselleştirerek, dönüştürerek ve modelleyerek yanıtlar ararsınız.
Öğrendiklerinizi, sorularınızı iyileştirmek ve/veya yeni sorular üretmek için kullanırsınız.
EDA, katı kuralları olan resmi bir süreç değildir. Her şeyden çok, EDA bir zihniyettir. EDA’nın ilk aşamalarında, aklınıza gelen her fikri araştırmakta özgür hissetmelisiniz. Bu fikirlerin bazıları yararlı sonuçlar verecek, bazılarıysa çıkmaza girecektir. Keşfiniz ilerledikçe, sonunda yazıya döküp başkalarına aktaracağınız özellikle verimli birkaç içgörüye odaklanacaksınız.
Temel araştırma soruları size hazır verilmiş olsa bile EDA, her veri analizinin önemli bir parçasıdır; çünkü verilerinizin kalitesini her zaman incelemeniz gerekir. Veri temizleme, EDA’nın yalnızca bir uygulamasıdır: verinizin beklentilerinizi karşılayıp karşılamadığına dair sorular sorarsınız. Veri temizlemeyi yapmak için, EDA’nın tüm araçlarını kullanmanız gerekecektir: görselleştirme, dönüştürme ve modelleme.
10.1.1 Ön koşullar
Bu bölümde, sorular sormak, onları veriyle yanıtlamak ve ardından yeni sorular sormak için dplyr ve ggplot2 hakkında öğrendiklerinizi etkileşimli bir şekilde birleştireceğiz.
10.2 Sorular
“Rutin istatistiksel sorular yoktur, yalnızca sorgulanabilir istatistiksel rutinler vardır.” — Sir David Cox
“Genellikle belirsiz olan doğru soruya yaklaşık bir yanıt, her zaman kesinleştirilebilen yanlış soruya kesin bir yanıttan çok daha iyidir.” — John Tukey
EDA sırasındaki amacınız, veriniz hakkında bir anlayış geliştirmektir. Bunu yapmanın en kolay yolu, soruları araştırmanıza rehberlik edecek araçlar olarak kullanmaktır. Bir soru sorduğunuzda, o soru dikkatinizi veri kümenizin belirli bir bölümüne odaklar ve hangi grafikleri, modelleri veya dönüşümleri yapacağınıza karar vermenize yardımcı olur.
EDA, temelde yaratıcı bir süreçtir. Çoğu yaratıcı süreçte olduğu gibi, nitelikli sorular sormanın anahtarı çok sayıda soru üretmektir. Analizinizin başında açığa çıkarıcı sorular sormak zordur; çünkü veri kümenizden hangi içgörülerin elde edilebileceğini bilmiyorsunuzdur. Öte yandan, sorduğunuz her yeni soru sizi verinizin yeni bir yönüyle karşı karşıya bırakacak ve bir keşif yapma şansınızı artıracaktır. Bulduklarınıza dayanarak her soruyu yeni bir soruyla takip ederseniz, verinizin en ilginç kısımlarına hızla inebilir — ve düşündürücü bir dizi soru geliştirebilirsiniz.
Araştırmanıza rehberlik etmek için hangi soruları sormanız gerektiğine dair bir kural yoktur. Ancak, iki tür soru, veriniz içinde keşifler yapmak için her zaman kullanışlı olacaktır. Bu soruları gevşek bir şekilde şöyle ifade edebilirsiniz:
Değişkenlerim içinde ne tür bir varyasyon oluşuyor?
Değişkenlerim arasında ne tür bir kovaryasyon oluşuyor?
Bu bölümün geri kalanında bu iki soruyu ele alacağız. Varyasyon ve kovaryasyonun ne olduğunu açıklayacak, her soruyu yanıtlamanın çeşitli yollarını göstereceğiz.
10.3 Varyasyon
Varyasyon, bir değişkenin değerlerinin ölçümden ölçüme değişme eğilimidir. Varyasyonu gerçek yaşamda kolayca görebilirsiniz: herhangi bir sürekli değişkeni iki kez ölçerseniz iki farklı sonuç elde edersiniz. Bu, ışık hızı gibi sabit olan büyüklükleri ölçseniz bile doğrudur. Ölçümlerinizin her biri, ölçümden ölçüme değişen küçük miktarda bir hata içerecektir. Değişkenler ayrıca farklı özneler arasında ölçüm yaparsanız (örneğin, farklı insanların göz renkleri) veya farklı zamanlarda ölçüm yaparsanız (örneğin, bir elektronun farklı anlardaki enerji seviyeleri) da değişebilir. Her değişkenin kendi varyasyon örüntüsü vardır; bu da aynı gözlem üzerindeki ölçümler arasında olduğu kadar gözlemler arasında da nasıl değiştiği hakkında ilginç bilgiler ortaya çıkarabilir. Bu örüntüyü anlamanın en iyi yolu, Bölüm 1 içinde öğrendiğiniz gibi, değişkenin değerlerinin dağılımını görselleştirmektir.
Keşfimize, diamonds veri kümesindeki ~54.000 elmasın ağırlıklarının (carat) dağılımını görselleştirerek başlayacağız. carat sayısal bir değişken olduğundan, bir histogram kullanabiliriz:
ggplot(diamonds, aes(x = carat)) +
  geom_histogram(binwidth = 0.5)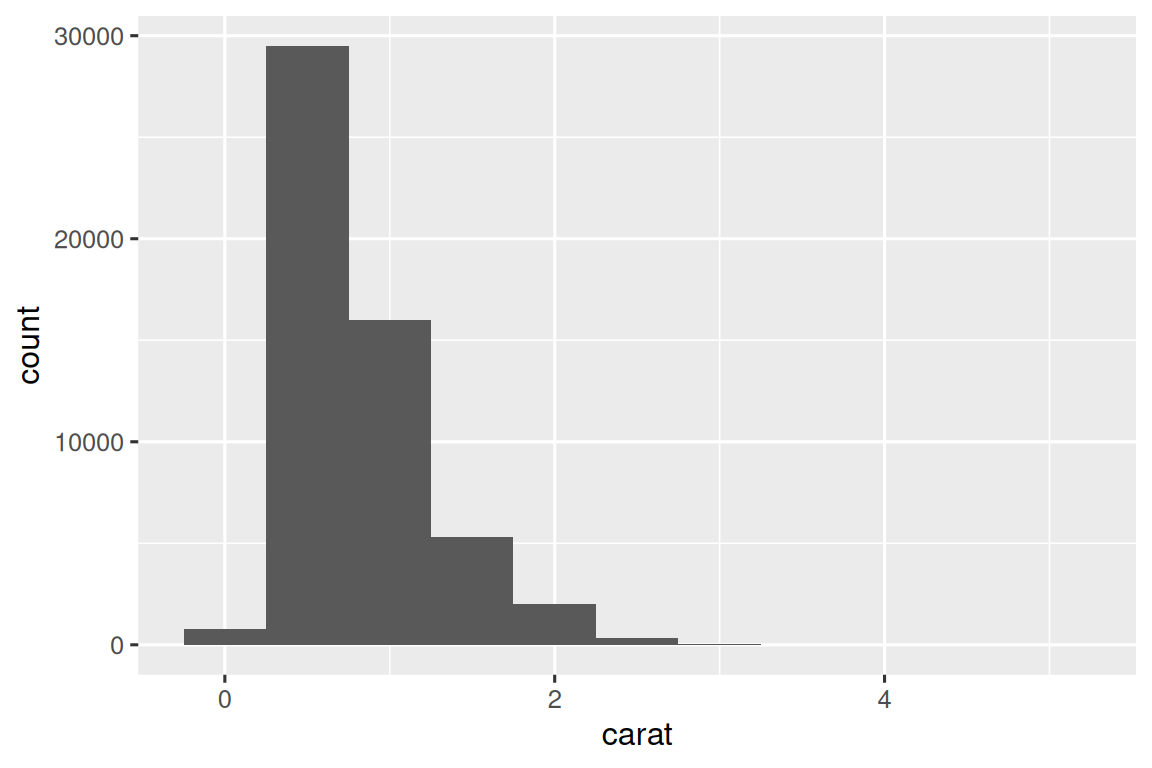
Artık varyasyonu görselleştirebildiğinize göre, grafiklerinizde neye bakmalısınız? Ve ne tür takip soruları sormalısınız? Aşağıda, grafiklerinizde bulacağınız en kullanışlı bilgi türlerinin bir listesini, her bilgi türü için bazı takip sorularıyla birlikte bir araya getirdik. İyi takip soruları sormanın anahtarı, merakınıza (Başka ne öğrenmek istiyorsunuz?) olduğu kadar kuşkuculuğunuza da (Bu nasıl yanıltıcı olabilir?) güvenmektir.
10.3.1 Tipik değerler
Hem çubuk grafiklerde hem de histogramlarda, uzun çubuklar bir değişkenin yaygın değerlerini, kısa çubuklar ise daha az yaygın değerleri gösterir. Çubuk bulunmayan yerler, verinizde görülmeyen değerleri ortaya çıkarır. Bu bilgiyi kullanışlı sorulara dönüştürmek için, beklenmedik herhangi bir şey arayın:
Hangi değerler en yaygın? Neden?
Hangi değerler nadir? Neden? Bu, beklentilerinizle örtüşüyor mu?
Herhangi bir olağandışı örüntü görüyor musunuz? Bunları ne açıklayabilir?
Daha küçük elmaslar için carat’ın dağılımına bir bakalım.
smaller <- diamonds |>
  filter(carat < 3)

ggplot(smaller, aes(x = carat)) +
  geom_histogram(binwidth = 0.01)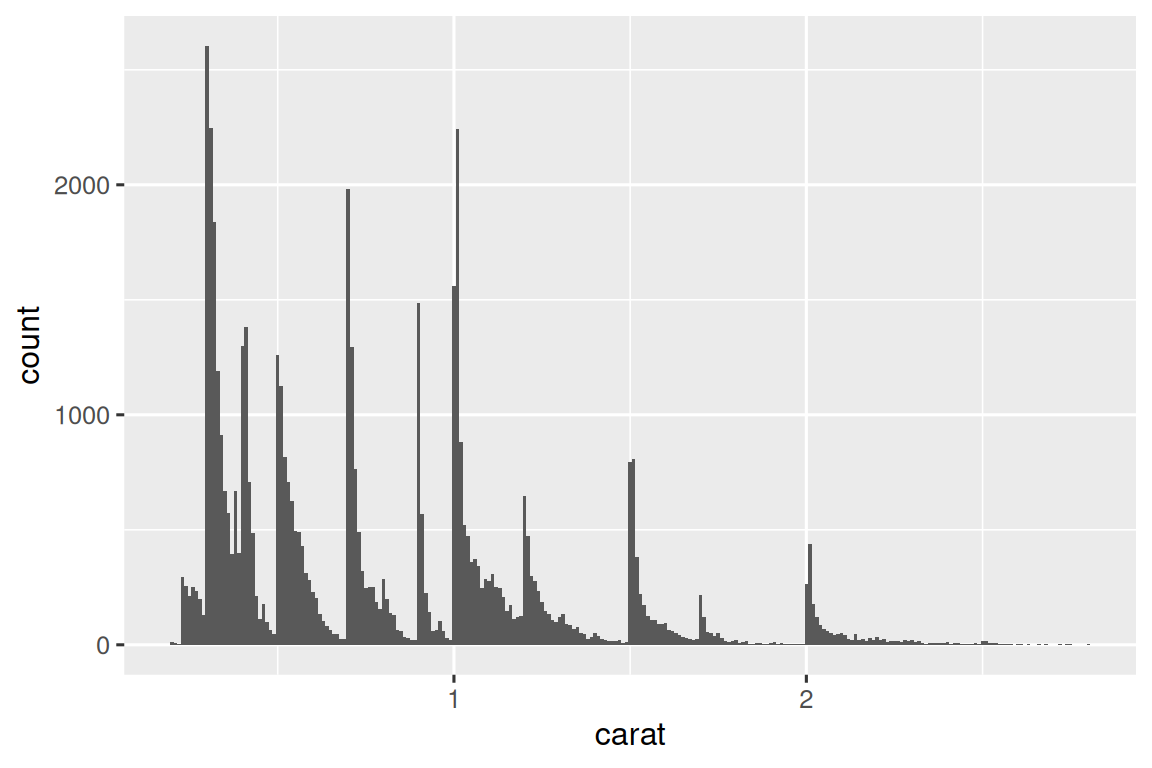
Bu histogram birkaç ilginç soru öneriyor:
Neden tam karat değerlerinde ve yaygın karat kesirlerinde daha fazla elmas var?
Neden her tepe noktasının hemen sağında, hemen solundan daha fazla elmas var?
Görselleştirmeler ayrıca, verinizde alt grupların var olduğunu öne süren kümeleri de ortaya çıkarabilir. Alt grupları anlamak için şunu sorun:
Her alt grup içindeki gözlemler birbirlerine nasıl benziyor?
Ayrı kümelerdeki gözlemler birbirlerinden nasıl farklı?
Kümeleri nasıl açıklayabilir veya tanımlayabilirsiniz?
Kümelerin görünümü neden yanıltıcı olabilir?
Bu soruların bazıları veriyle yanıtlanabilirken, bazıları veri hakkında alan uzmanlığı gerektirecektir. Bunların çoğu, örneğin bir değişkenin değerlerinin başka bir değişkenin davranışını açıklayıp açıklayamayacağını görmek için, değişkenler arasındaki bir ilişkiyi keşfetmenizi isteyecektir. Bu konuya kısa süre sonra geleceğiz.
10.3.2 Olağandışı değerler
Aykırı değerler (outliers), olağandışı olan gözlemlerdir; örüntüye uymuyor gibi görünen veri noktaları. Bazen aykırı değerler veri girişi hatalarıdır, bazen bu veri toplamada gözlemlenmiş uç değerlerdir, bazen de önemli yeni keşifler önerirler. Çok fazla veriniz olduğunda, aykırı değerleri bir histogramda görmek bazen zordur. Örneğin, diamonds veri kümesindeki y değişkeninin dağılımını ele alın. Aykırı değerlerin tek kanıtı, x ekseni üzerindeki olağandışı geniş sınırlardır.
ggplot(diamonds, aes(x = y)) +
  geom_histogram(binwidth = 0.5)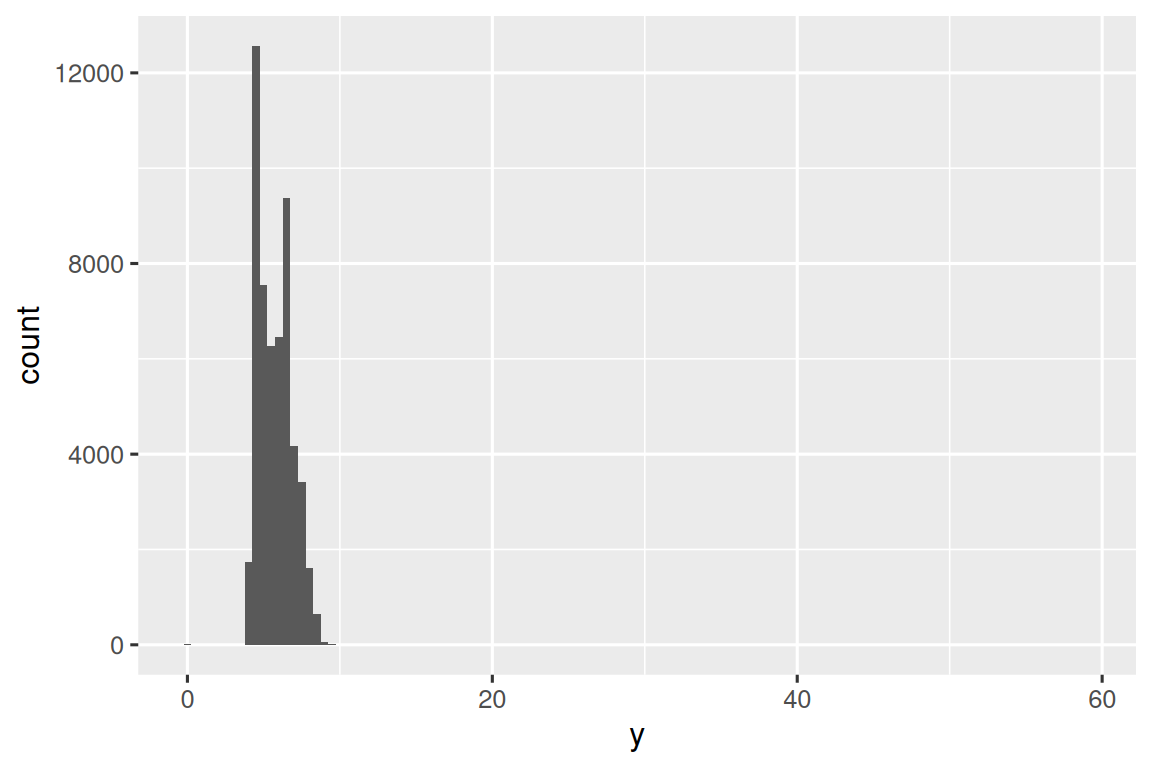
Yaygın aralıklarda o kadar çok gözlem var ki nadir aralıklar çok kısa kalıyor ve görülmeleri zorlaşıyor (yine de 0’a dikkatlice bakarsanız bir şey fark edebilirsiniz). Olağandışı değerleri görmeyi kolaylaştırmak için, coord_cartesian() ile y ekseninin küçük değerlerine yakınlaşmamız gerekir:
ggplot(diamonds, aes(x = y)) +
  geom_histogram(binwidth = 0.5) +
  coord_cartesian(ylim = c(0, 50))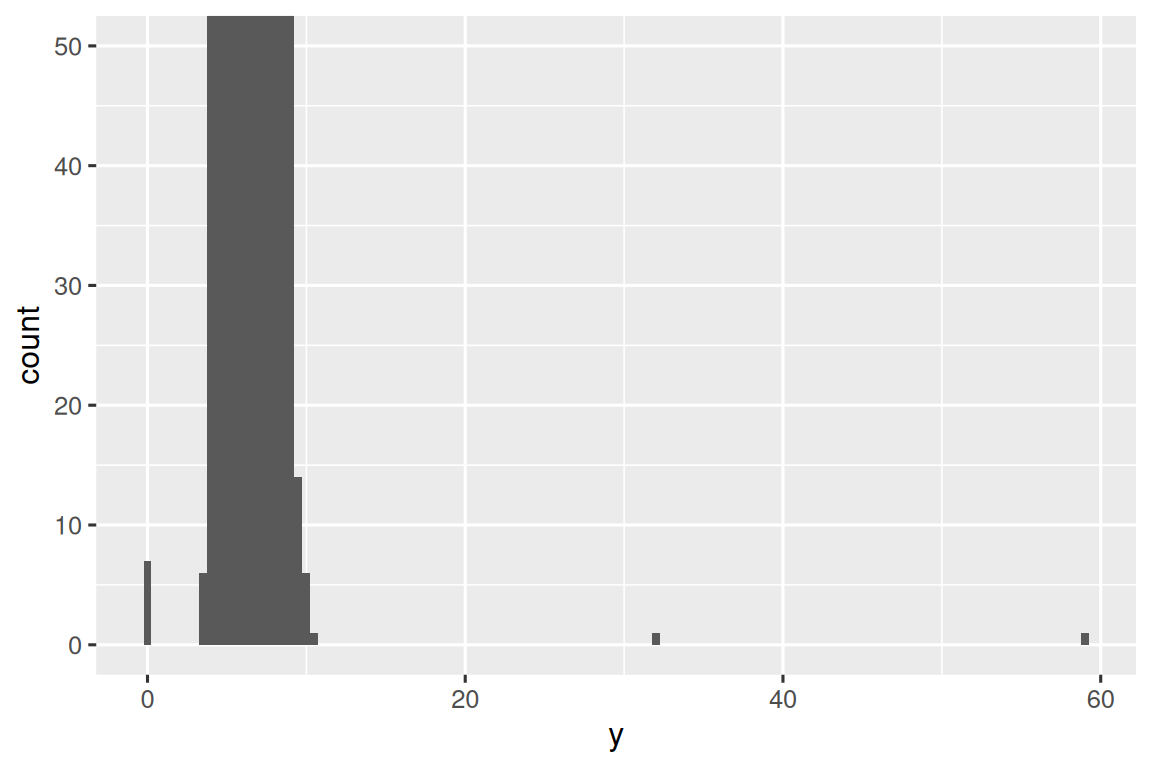
coord_cartesian(), x eksenine yakınlaşmanız gerektiğinde kullanabileceğiniz bir xlim() argümanına da sahiptir. ggplot2’nin ayrıca biraz farklı çalışan xlim() ve ylim() fonksiyonları vardır: bunlar, sınırların dışındaki veriyi atarlar.
Bu, üç olağandışı değer olduğunu görmemizi sağlar: 0, ~30 ve ~60. Bunları dplyr ile ayıklıyoruz:
unusual <- diamonds |>
  filter(y < 3 | y > 20) |>
  select(price, x, y, z) |>
  arrange(y)
unusual
#> # A tibble: 9 × 4
#>   price     x     y     z
#>   <int> <dbl> <dbl> <dbl>
#> 1  5139  0      0    0
#> 2  6381  0      0    0
#> 3 12800  0      0    0
#> 4 15686  0      0    0
#> 5 18034  0      0    0
#> 6  2130  0      0    0
#> 7  2130  0      0    0
#> 8  2075  5.15  31.8  5.12
#> 9 12210  8.09  58.9  8.06
y değişkeni, bu elmasların üç boyutundan birini, mm cinsinden ölçer. Elmasların 0 mm genişliğe sahip olamayacağını biliyoruz; dolayısıyla bu değerler yanlış olmalıdır. EDA yaparak, yalnızca NA arayarak asla bulamayacağımız, 0 olarak kodlanmış eksik veriyi keşfettik. İleride, yanıltıcı hesaplamaları önlemek için bu değerleri NA olarak yeniden kodlamayı seçebiliriz. Ayrıca 32 mm ve 59 mm’lik ölçümlerin gerçekçi olmadığından şüphelenebiliriz: bu elmaslar bir inçten daha uzun, ancak yüz binlerce dolara mal olmuyor!
Analizinizi hem aykırı değerlerle hem de onlar olmadan tekrarlamak iyi bir uygulamadır. Sonuçlar üzerinde çok az etkileri varsa ve neden orada olduklarını çözemiyorsanız onları çıkarıp devam etmek makuldür. Ancak, sonuçlarınız üzerinde önemli bir etkileri varsa, gerekçe göstermeden onları çıkarmamalısınız. Onlara neyin sebep olduğunu (örneğin bir veri girişi hatası) bulmanız ve yazınızda onları çıkardığınızı açıklamanız gerekecektir.
10.3.3 Alıştırmalar
diamondsiçindekix,yvezdeğişkenlerinin her birinin dağılımını keşfedin. Ne öğreniyorsunuz? Bir elması ve hangi boyutun uzunluk, genişlik ve derinlik olduğuna nasıl karar verebileceğinizi düşünün.price’ın dağılımını keşfedin. Olağandışı veya şaşırtıcı bir şey keşfediyor musunuz? (İpucu:binwidth’i dikkatlice düşünün ve geniş bir değer aralığı denediğinizden emin olun.)Kaç elmas 0.99 karat? Kaç tanesi 1 karat? Bu farkın nedeninin ne olduğunu düşünüyorsunuz?
Bir histograma yakınlaşırken
coord_cartesian()’ıxlim()veyaylim()ile karşılaştırıp karşıtlaştırın.binwidth’i ayarlanmamış bırakırsanız ne olur? Yalnızca yarım bir çubuk görünecek şekilde yakınlaşmaya çalışırsanız ne olur?
10.4 Olağandışı değerler
Veri kümenizde olağandışı değerlerle karşılaştıysanız ve analizinizin geri kalanına geçmek istiyorsanız, iki seçeneğiniz vardır.
-
Garip değerlere sahip tüm satırı çıkarın:
Bu seçeneği önermiyoruz; çünkü geçersiz bir değer, o gözlem için diğer tüm değerlerin de geçersiz olduğu anlamına gelmez. Ayrıca, düşük kaliteli veriniz varsa, bu yaklaşımı her değişkene uyguladığınızda elinizde hiç veri kalmadığını görebilirsiniz!
-
Bunun yerine, olağandışı değerleri eksik değerlerle değiştirmenizi öneririz. Bunu yapmanın en kolay yolu, değişkeni değiştirilmiş bir kopyayla değiştirmek için
mutate()’i kullanmaktır. Olağandışı değerleriNAile değiştirmek içinif_else()fonksiyonunu kullanabilirsiniz:
Eksik değerleri nerede çizmeniz gerektiği belli değildir, bu yüzden ggplot2 onları grafiğe dahil etmez; ama kaldırıldıklarına dair uyarır:
ggplot(diamonds2, aes(x = x, y = y)) +
  geom_point()
#> Warning: Removed 9 rows containing missing values or values outside the scale range
#> (`geom_point()`).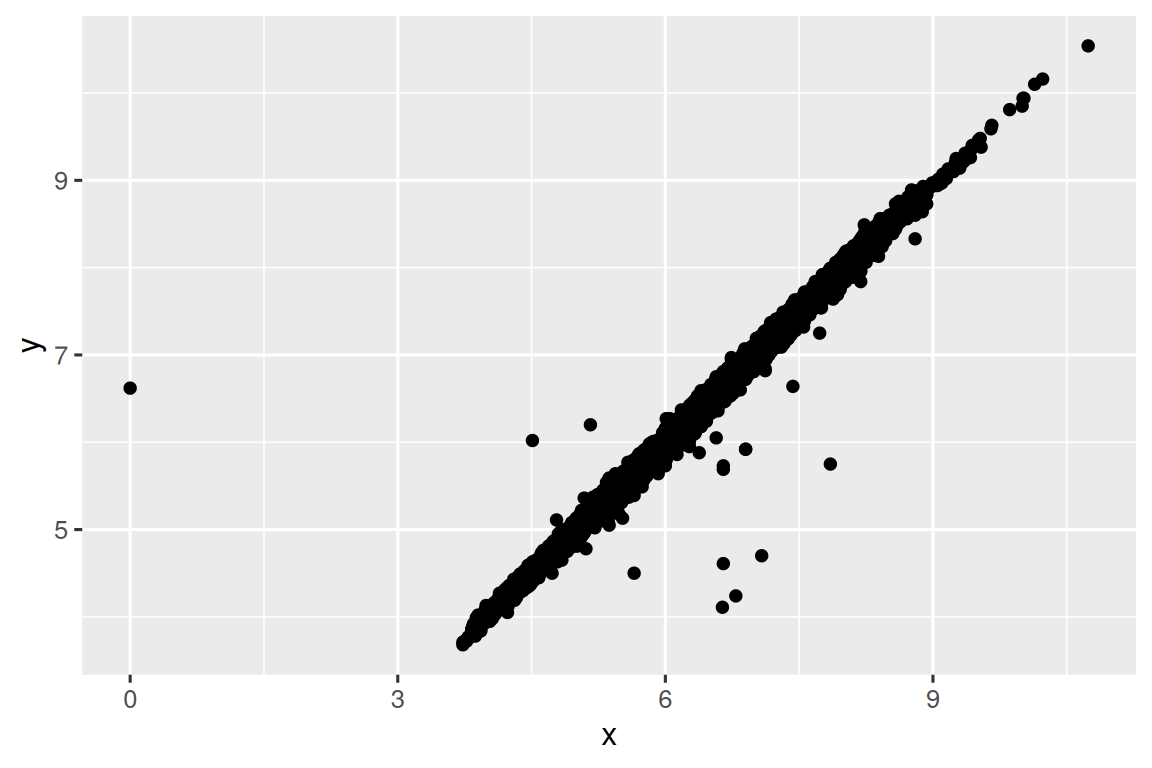
Bu uyarıyı bastırmak için, na.rm = TRUE ayarlayın:
ggplot(diamonds2, aes(x = x, y = y)) +
  geom_point(na.rm = TRUE)
Diğer zamanlarda, eksik değerlere sahip gözlemleri kaydedilmiş değerlere sahip gözlemlerden neyin farklı kıldığını anlamak istersiniz. Örneğin, nycflights13::flights1 içinde, dep_time değişkenindeki eksik değerler, uçuşun iptal edildiğini gösterir. Dolayısıyla, iptal edilen ve edilmeyen uçuşların planlanan kalkış zamanlarını karşılaştırmak isteyebilirsiniz. Bunu, dep_time’ın eksik olup olmadığını kontrol etmek için is.na()’i kullanarak yeni bir değişken oluşturarak yapabilirsiniz.
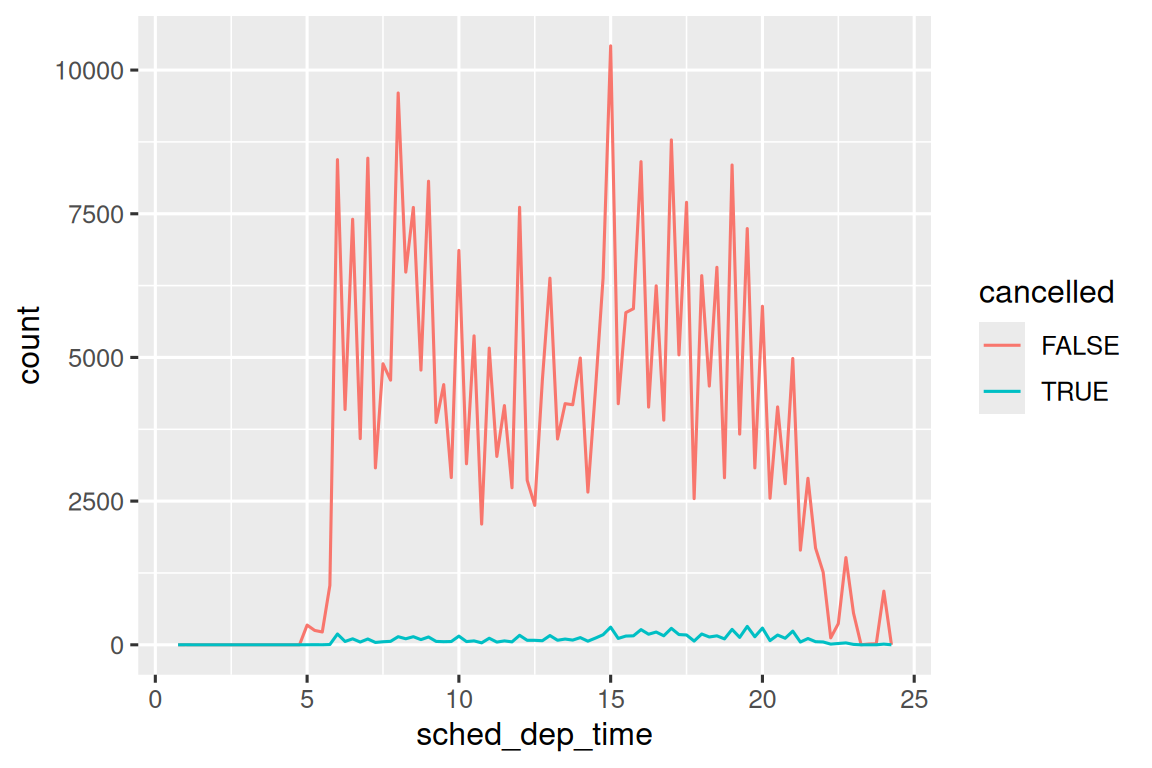
Ancak bu grafik pek iyi değil; çünkü iptal edilmeyen uçuş sayısı iptal edilenlerden çok daha fazla. Bir sonraki bölümde, bu karşılaştırmayı iyileştirmek için bazı teknikleri keşfedeceğiz.
10.4.1 Alıştırmalar
Bir histogramda eksik değerlere ne olur? Bir çubuk grafikte eksik değerlere ne olur? Eksik değerlerin histogramlarda ve çubuk grafiklerde ele alınış biçiminde neden bir fark var?
scheduled_dep_time’ın, uçuşun iptal edilip edilmediğine göre renklendirilmiş frekans grafiğini yeniden oluşturun. Ayrıcacancelleddeğişkenine göre panellere ayırın. İptal edilmeyen uçuşların iptal edilenlerden daha fazla olmasının etkisini azaltmak için panelleme fonksiyonundakiscalesdeğişkeninin farklı değerlerini deneyin.
10.5 Kovaryasyon
Varyasyon bir değişken içindeki davranışı tanımlıyorsa, kovaryasyon değişkenler arasındaki davranışı tanımlar. Kovaryasyon, iki veya daha fazla değişkenin değerlerinin ilişkili bir şekilde birlikte değişme eğilimidir. Kovaryasyonu tespit etmenin en iyi yolu, iki veya daha fazla değişken arasındaki ilişkiyi görselleştirmektir.
10.5.1 Bir kategorik ve bir sayısal değişken
Örneğin, geom_freqpoly() kullanarak bir elmasın fiyatının kalitesine (cut ile ölçülen) göre nasıl değiştiğini keşfedelim:
ggplot(diamonds, aes(x = price)) +
  geom_freqpoly(aes(color = cut), binwidth = 500, linewidth = 0.75)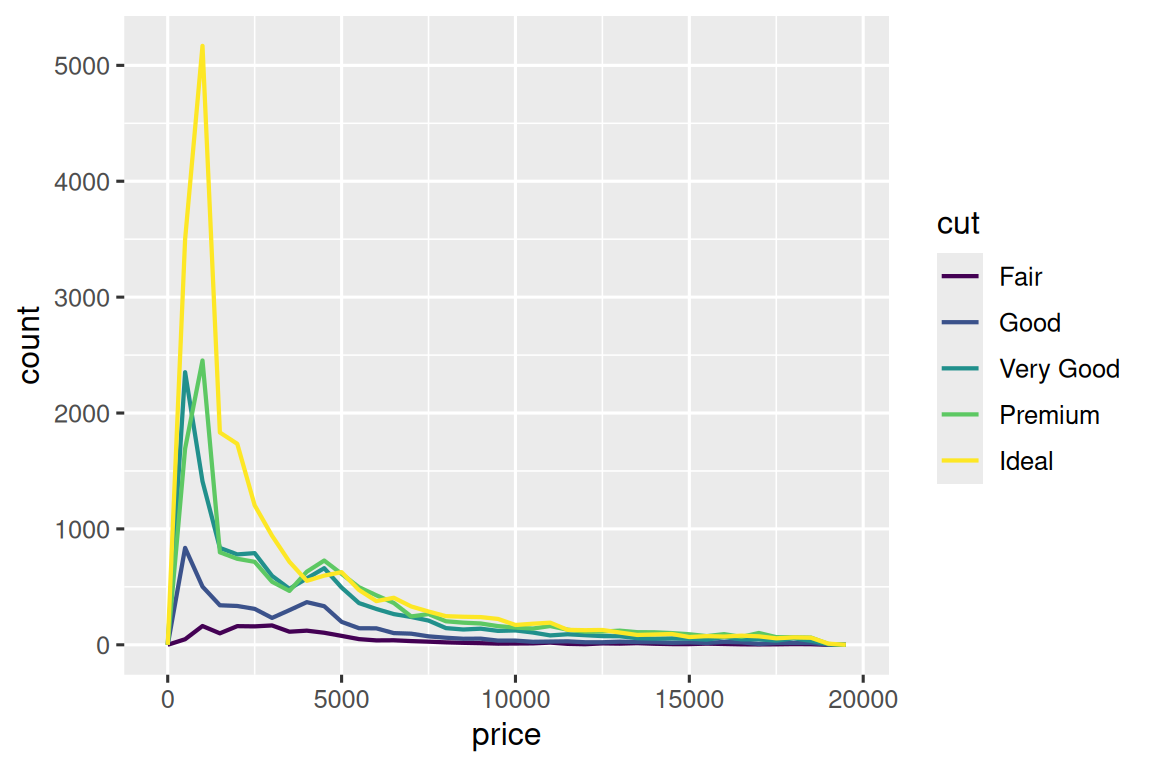
ggplot2’nin cut için sıralı bir renk ölçeği kullandığına dikkat edin; çünkü cut, veride sıralı bir faktör değişkeni olarak tanımlanmıştır. Bunlar hakkında daha fazla bilgiyi Bölüm 16.6 içinde öğreneceksiniz.
geom_freqpoly()’nin varsayılan görünümü burada pek kullanışlı değildir; çünkü genel sayım tarafından belirlenen yükseklik, cut’lar arasında o kadar çok farklılık gösterir ki, dağılımlarının şekillerindeki farkları görmeyi zorlaştırır.
Karşılaştırmayı kolaylaştırmak için, y ekseninde gösterileni değiştirmemiz gerekir. Sayım yerine, her frekans poligonunun altındaki alan 1 olacak biçimde standartlaştırılmış bir sayım olan yoğunluğu (density) göstereceğiz.
ggplot(diamonds, aes(x = price, y = after_stat(density))) +
  geom_freqpoly(aes(color = cut), binwidth = 500, linewidth = 0.75)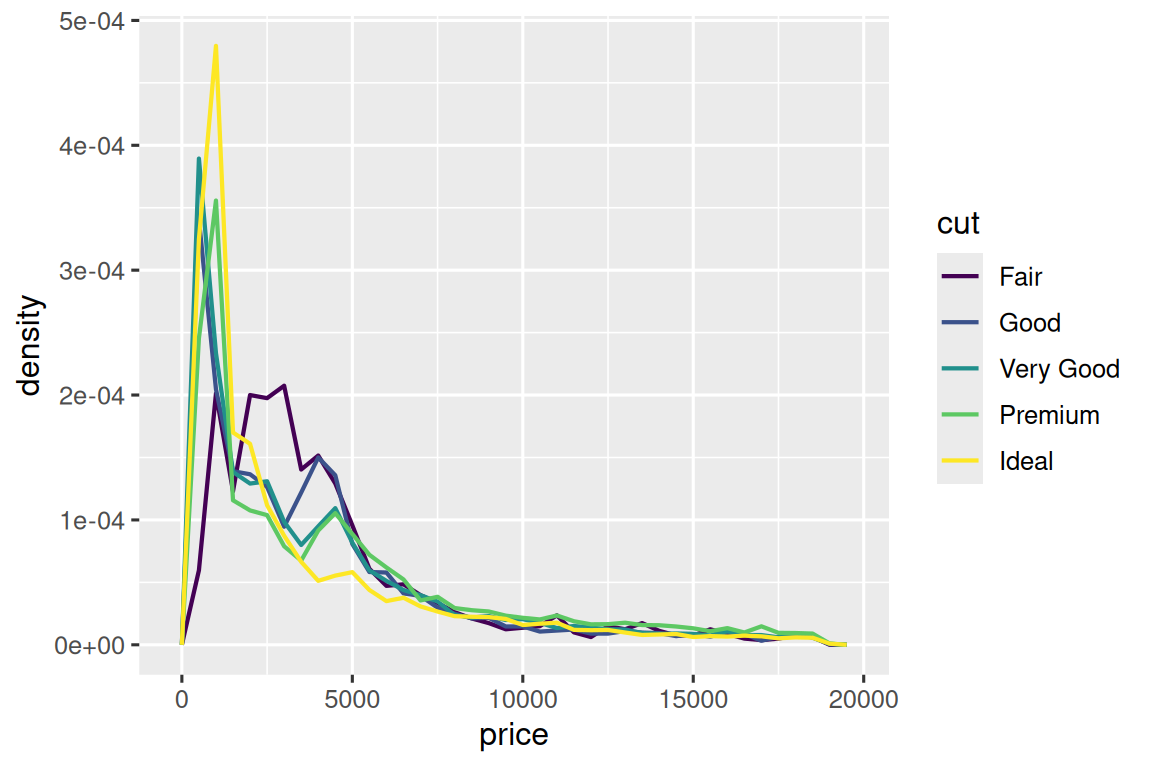
Yoğunluğu y’ye eşlediğimize dikkat edin; ama density, diamonds veri kümesinde bir değişken olmadığından, önce onu hesaplamamız gerekir. Bunu yapmak için after_stat() fonksiyonunu kullanırız.
Bu grafikte oldukça şaşırtıcı bir durum var: en düşük kalite sınıfındaki Fair elmasların en yüksek ortalama fiyata sahip olduğu görülüyor! Ancak bunun nedeni, frekans poligonlarını yorumlamanın biraz zor olması olabilir; bu grafikte çok fazla şey oluyor.
Bu ilişkiyi keşfetmek için görsel olarak daha basit bir grafik, yan yana kutu grafikleri kullanmaktır.
ggplot(diamonds, aes(x = cut, y = price)) +
  geom_boxplot()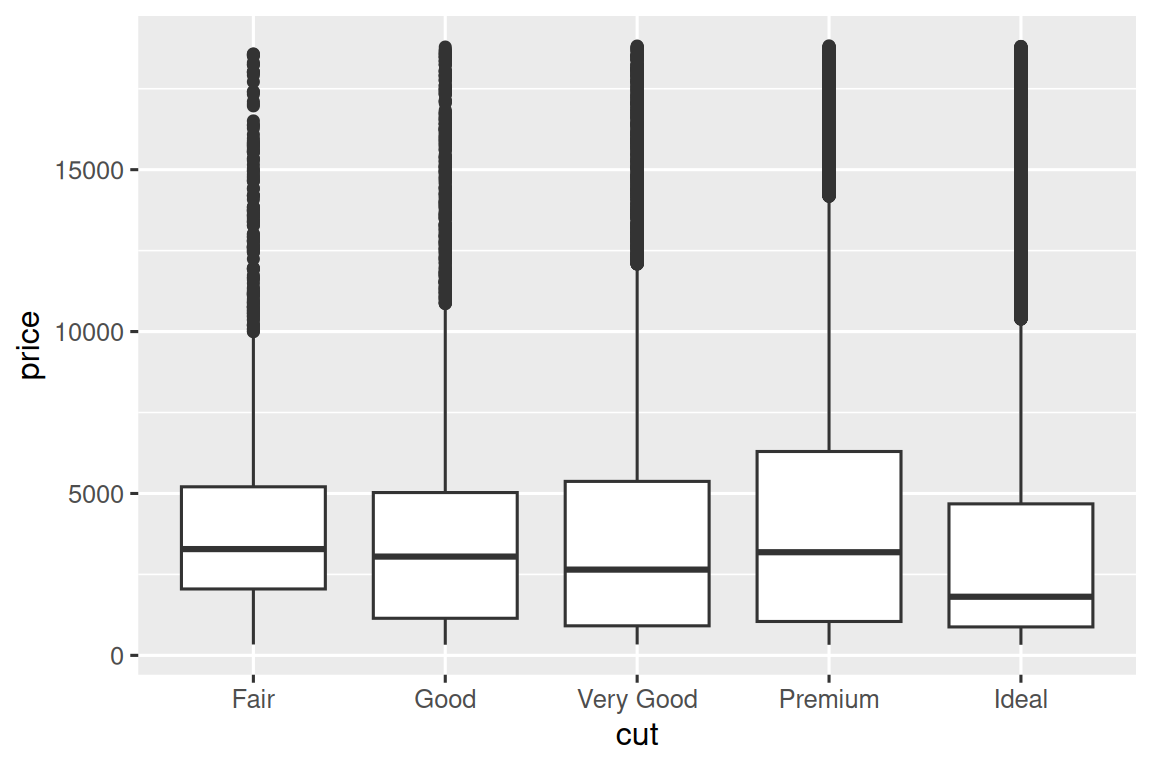
Dağılım hakkında çok daha az bilgi görüyoruz; ama kutu grafikleri çok daha kompakt, bu yüzden onları daha kolay karşılaştırabiliyoruz (ve bir grafiğe daha fazlasını sığdırabiliyoruz). Bu, daha kaliteli elmasların genellikle daha ucuz olduğuna dair sezgilere aykırı bulguyu destekliyor! Alıştırmalarda, nedenini bulmakla karşı karşıya kalacaksınız.
cut sıralı bir faktördür: Fair, Good’dan; Good ise Very Good’dan daha düşük kalitelidir ve sıralama böyle devam eder. Pek çok kategorik değişkenin böyle içsel bir sırası yoktur, bu yüzden daha bilgilendirici bir görüntü oluşturmak için onları yeniden sıralamak isteyebilirsiniz. Bunu yapmanın bir yolu fct_reorder()’dır. Bu fonksiyon hakkında daha fazla bilgiyi Bölüm 16.4 içinde öğreneceksiniz; ama o kadar kullanışlı ki burada size hızlı bir önizleme vermek istiyoruz. Örneğin, mpg veri kümesindeki class değişkenini ele alalım. Otoyol yakıt verimliliğinin sınıflar arasında nasıl değiştiğini bilmek isteyebilirsiniz:
ggplot(mpg, aes(x = class, y = hwy)) +
  geom_boxplot()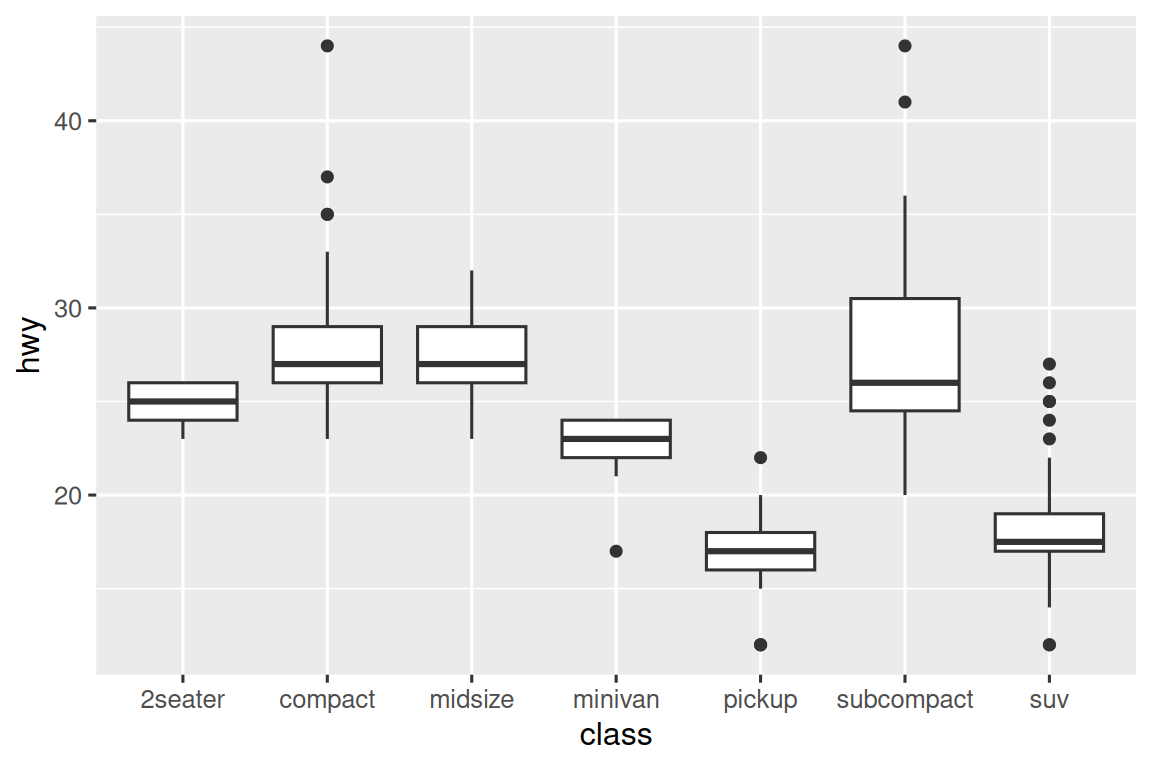
Eğilimi görmeyi kolaylaştırmak için, class’ı hwy’nin medyan değerine göre yeniden sıralayabiliriz:
ggplot(mpg, aes(x = fct_reorder(class, hwy, median), y = hwy)) +
  geom_boxplot()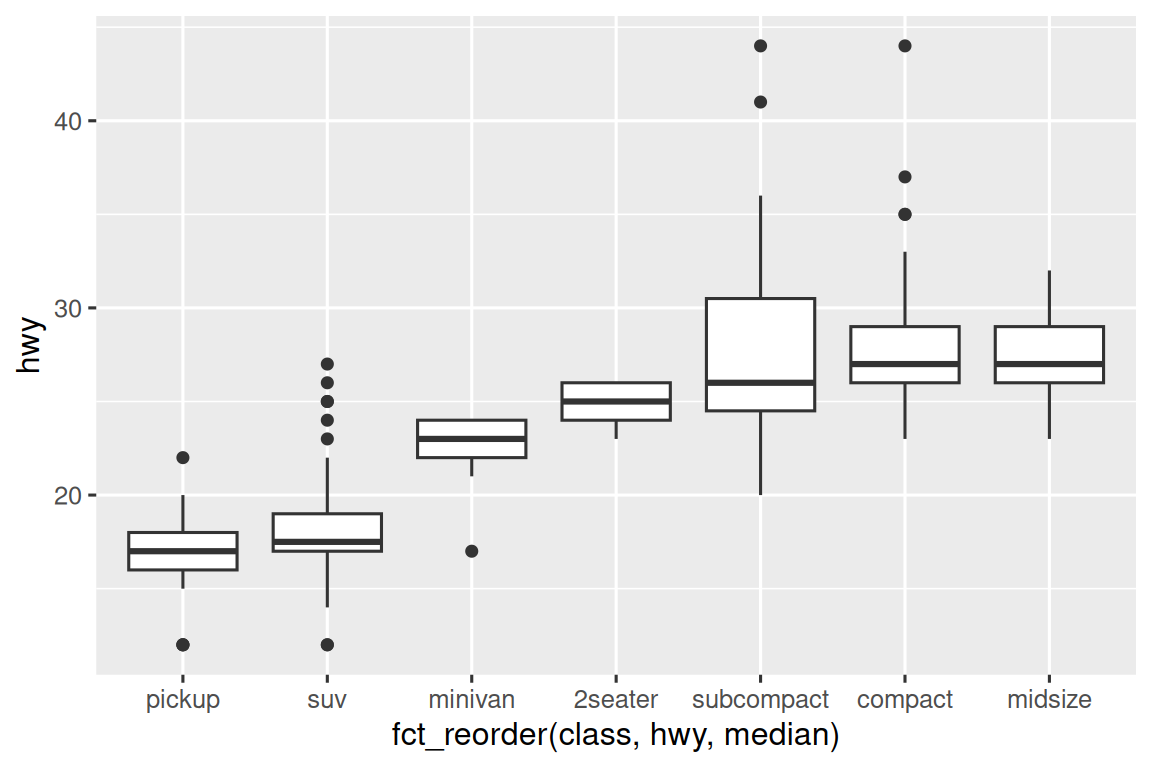
Değişken adlarınız uzunsa grafiği 90° döndürmek daha iyi sonuç verir. Bunu, x ve y estetik eşlemelerini değiştirerek yapabilirsiniz.
ggplot(mpg, aes(x = hwy, y = fct_reorder(class, hwy, median))) +
  geom_boxplot()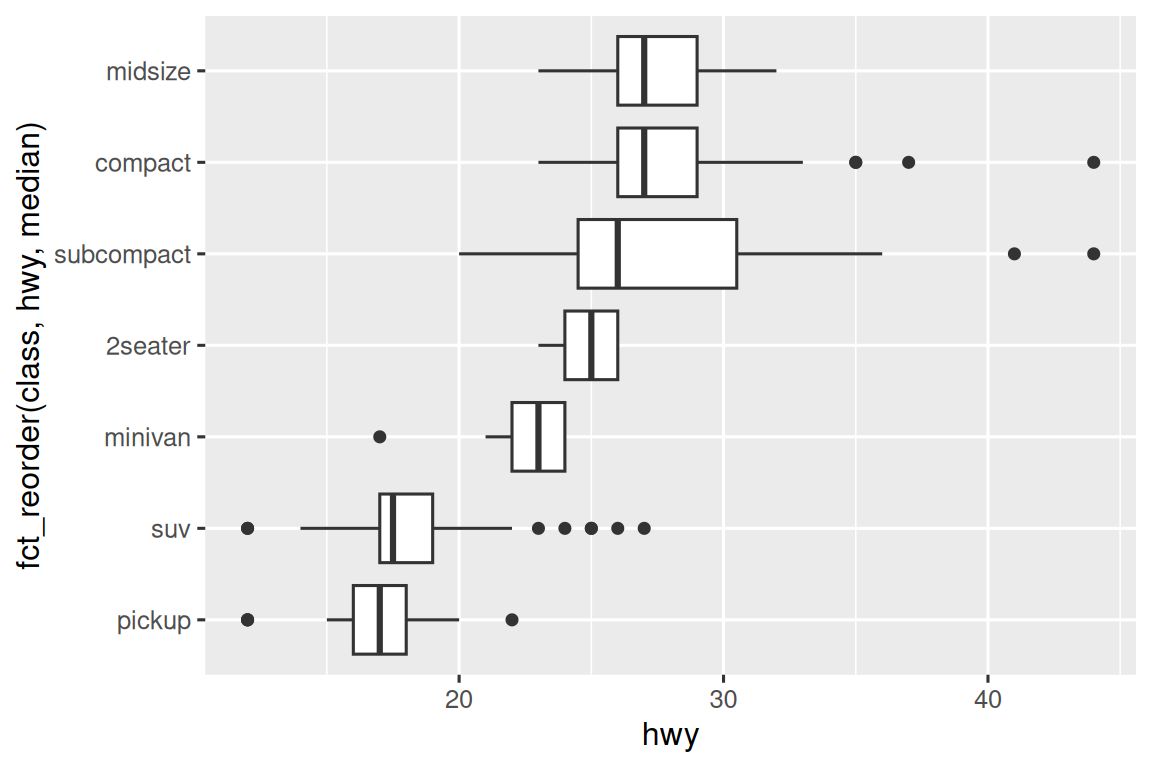
10.5.1.1 Alıştırmalar
İptal edilen ve edilmeyen uçuşların kalkış zamanlarının görselleştirmesini iyileştirmek için öğrendiklerinizi kullanın.
EDA’ya dayanarak, diamonds veri kümesinde bir elmasın fiyatını tahmin etmek için en önemli görünen değişken hangisi? Bu değişken cut ile nasıl bir korelasyona sahip? Bu iki ilişkinin kombinasyonu neden daha düşük kaliteli elmasların daha pahalı olmasına yol açıyor?
X ve y değişkenlerini değiştirmek yerine, dikey kutu grafiğine yeni bir katman olarak
coord_flip()ekleyerek yatay bir kutu grafiği oluşturun. Bu, değişkenleri değiştirmekle nasıl karşılaştırılır?Kutu grafiklerindeki bir sorun, çok daha küçük veri kümelerinin olduğu bir dönemde geliştirilmiş olmaları ve aşırı sayıda “aykırı değer” göstermeye eğilimli olmalarıdır. Bu sorunu gidermenin bir yaklaşımı letter value grafiğidir. lvplot paketini kurun ve price ile cut’ın dağılımını göstermek için
geom_lv()’yi kullanmayı deneyin. Ne öğreniyorsunuz? Grafikleri nasıl yorumluyorsunuz?diamondsveri kümesinden bir kategorik değişkene karşı elmas fiyatlarının görselleştirmesini öncegeom_violin()ile, ardından panellere ayrılmış birgeom_histogram()ile, sonra renklendirilmiş birgeom_freqpoly()ile ve son olarak renklendirilmiş birgeom_density()ile oluşturun. Dört grafiği karşılaştırıp karşıtlaştırın. Kategorik bir değişkenin düzeylerine dayanarak sayısal bir değişkenin dağılımını görselleştirmenin her yönteminin artıları ve eksileri nelerdir?Küçük bir veri kümeniz varsa, sürekli ve kategorik bir değişken arasındaki ilişkiyi daha kolay görmek için aşırı çizimi önlemek üzere
geom_jitter()kullanmak bazen yararlıdır. ggbeeswarm paketi,geom_jitter()’a benzer bir dizi yöntem sunar. Onları listeleyin ve her birinin ne yaptığını kısaca açıklayın.
10.5.2 İki kategorik değişken
Kategorik değişkenler arasındaki kovaryasyonu görselleştirmek için, bu kategorik değişkenlerin düzeylerinin her kombinasyonu için gözlem sayısını saymanız gerekir. Bunu yapmanın bir yolu, yerleşik geom_count()’a güvenmektir:
ggplot(diamonds, aes(x = cut, y = color)) +
  geom_count()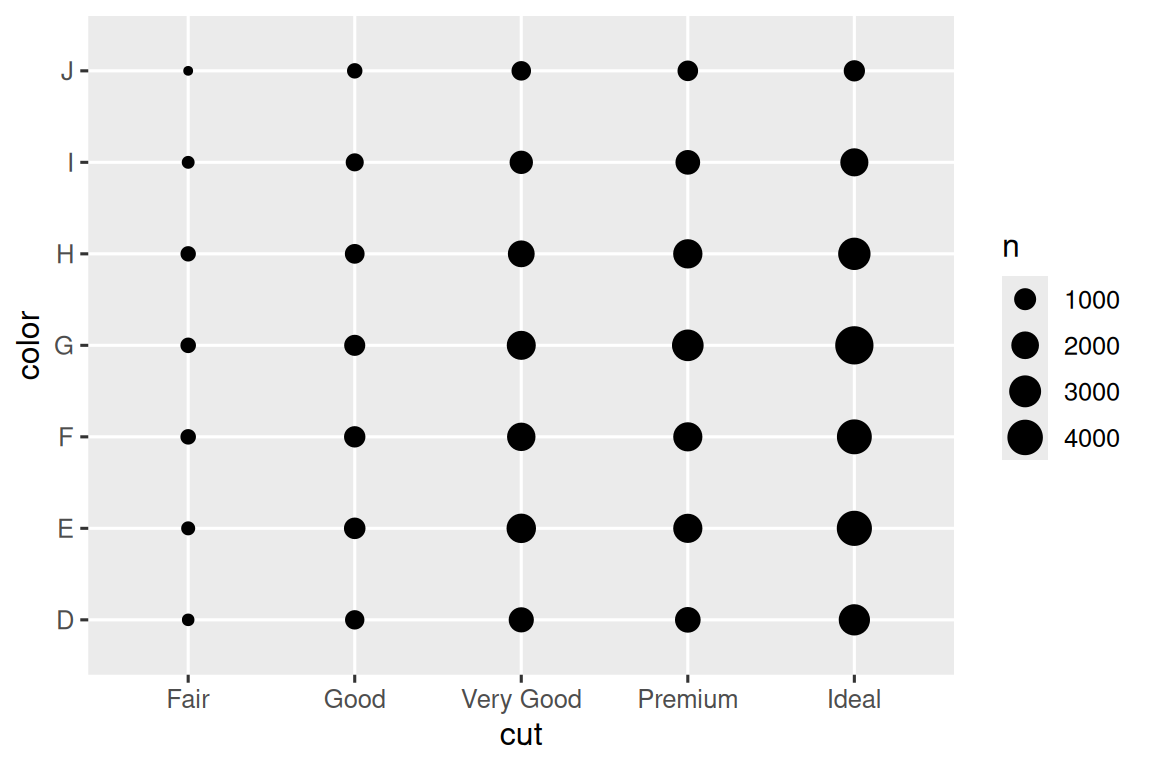
Grafikteki her dairenin boyutu, her değer kombinasyonunda kaç gözlem meydana geldiğini gösterir. Kovaryasyon, belirli x değerleri ile belirli y değerleri arasında güçlü bir korelasyon olarak ortaya çıkacaktır.
Bu değişkenler arasındaki ilişkiyi keşfetmenin bir başka yaklaşımı, sayımları dplyr ile hesaplamaktır:
diamonds |>
  count(color, cut)
#> # A tibble: 35 × 3
#>   color cut           n
#>   <ord> <ord>     <int>
#> 1 D     Fair        163
#> 2 D     Good        662
#> 3 D     Very Good  1513
#> 4 D     Premium    1603
#> 5 D     Ideal      2834
#> 6 E     Fair        224
#> # ℹ 29 more rows
Ardından geom_tile() ve fill estetiğiyle görselleştirin:
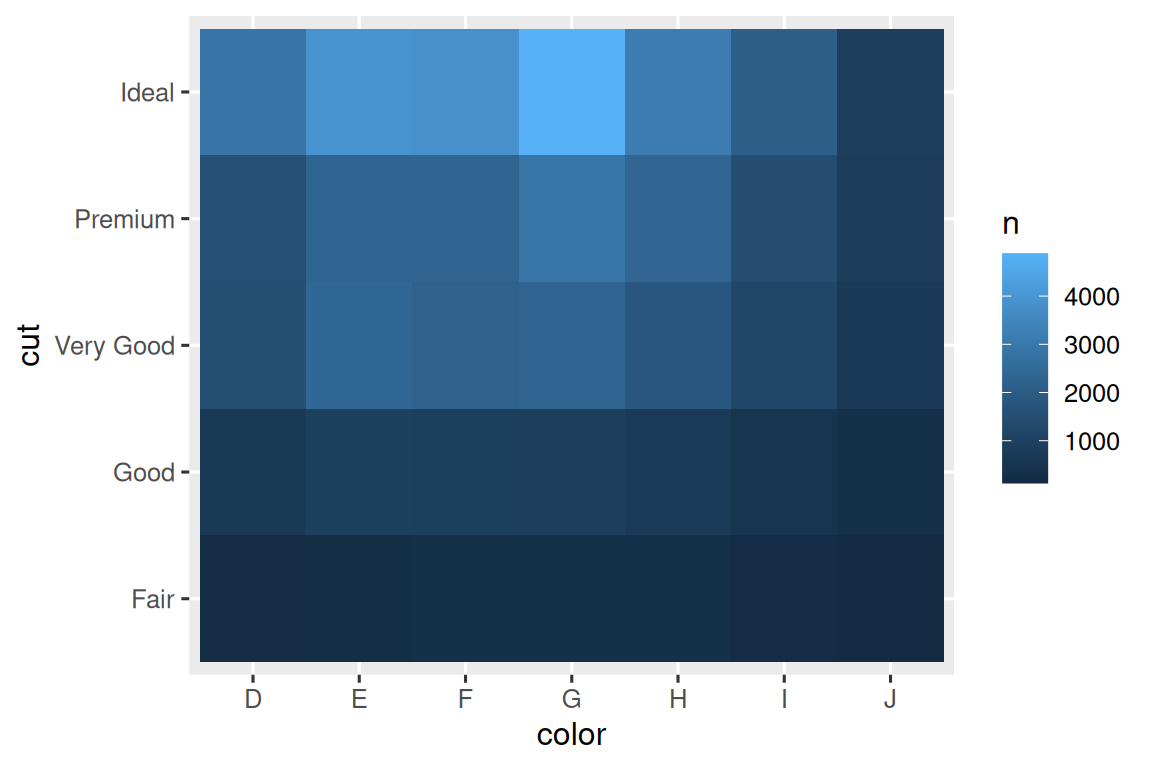
Kategorik değişkenler sırasızsa, ilginç örüntüleri daha net ortaya çıkarmak için satırları ve sütunları aynı anda yeniden sıralamak üzere seriation paketini kullanmak isteyebilirsiniz. Daha büyük grafikler için, etkileşimli grafikler oluşturan heatmaply paketini denemek isteyebilirsiniz.
10.5.2.1 Alıştırmalar
color içinde cut’ın veya cut içinde color’ın dağılımını daha net göstermek için yukarıdaki sayım veri kümesini nasıl yeniden ölçeklendirebilirsiniz?
color,
xestetiğine vecut,fillestetiğine eşlenirse, bölümlere ayrılmış bir çubuk grafikle hangi farklı veri içgörülerini elde edersiniz? Her bölüme düşen sayımları hesaplayın.Ortalama uçuş kalkış gecikmelerinin varış yerine ve yılın ayına göre nasıl değiştiğini keşfetmek için
geom_tile()’ı dplyr ile birlikte kullanın. Grafiği okumayı ne zorlaştırıyor? Onu nasıl iyileştirebilirsiniz?
10.5.3 İki sayısal değişken
İki sayısal değişken arasındaki kovaryasyonu görselleştirmenin harika bir yolunu zaten gördünüz: geom_point() ile bir saçılım grafiği çizmek. Kovaryasyonu noktalardaki bir örüntü olarak görebilirsiniz. Örneğin, bir elmasın karat boyutu ile fiyatı arasında pozitif bir ilişki görebilirsiniz: daha fazla karata sahip elmasların fiyatı daha yüksektir. İlişki üsteldir.
ggplot(smaller, aes(x = carat, y = price)) +
  geom_point()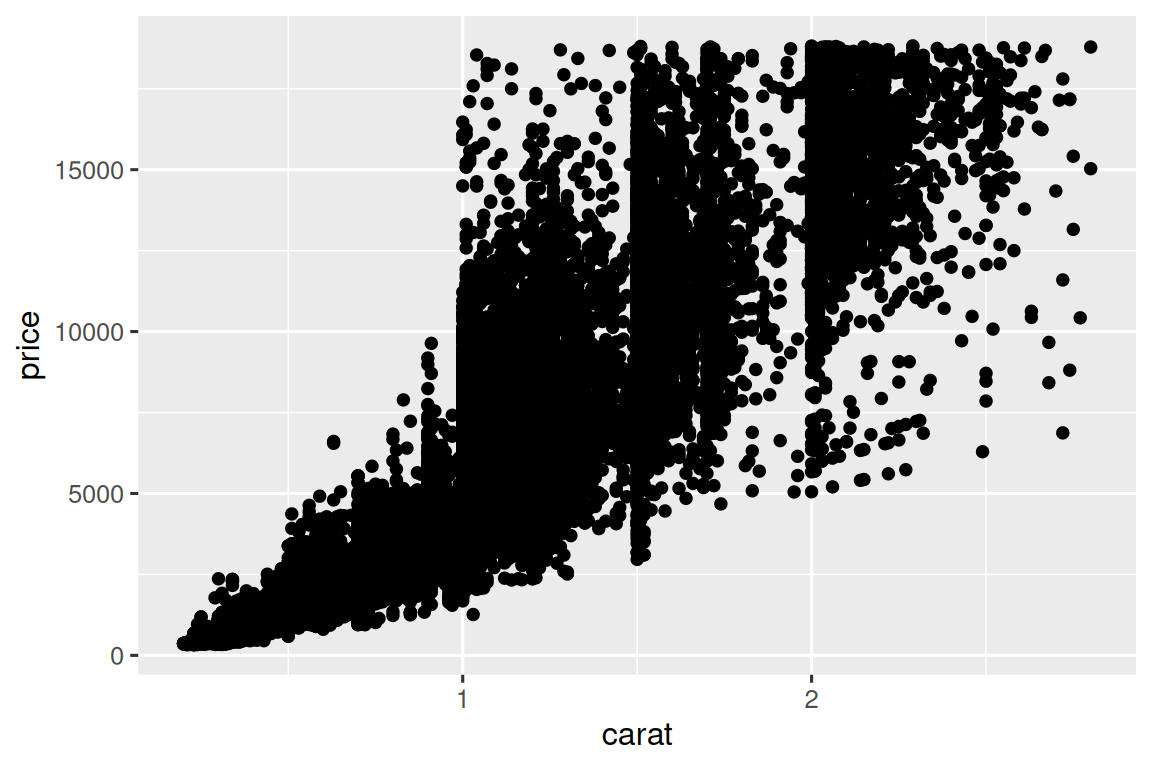
(Bu bölümde, 3 karattan küçük elmasların büyük çoğunluğuna odaklanmak için smaller veri kümesini kullanacağız)
Saçılım grafikleri, veri kümenizin boyutu büyüdükçe daha az kullanışlı hale gelir; çünkü noktalar üst üste binmeye başlar ve tekdüze siyah alanlar halinde yığılır, bu da verinin 2 boyutlu uzaydaki yoğunluk farklarını değerlendirmeyi ve eğilimi tespit etmeyi zorlaştırır. Sorunu düzeltmenin bir yolunu zaten gördünüz: saydamlık eklemek için alpha estetiğini kullanmak.
ggplot(smaller, aes(x = carat, y = price)) +
  geom_point(alpha = 1 / 100)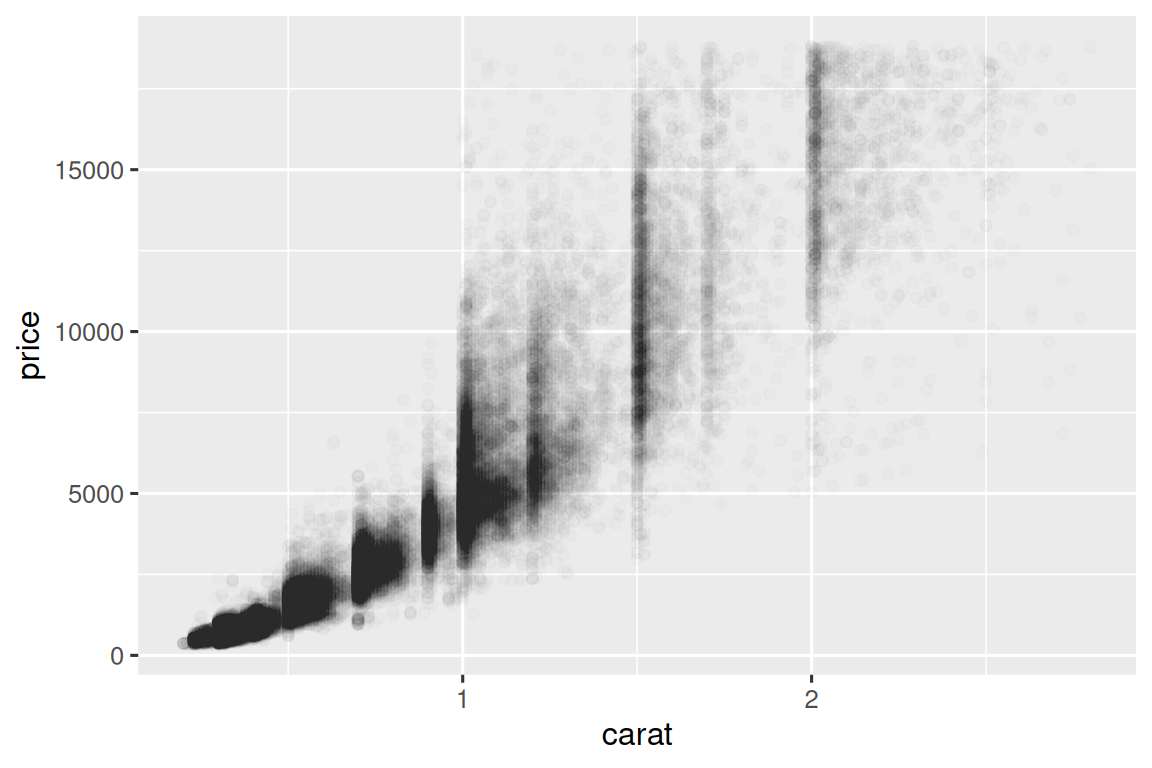
Ancak saydamlık çok büyük veri kümelerinde yetersiz kalabilir. Başka bir çözüm, değerleri aralıklara ayırmaktır (binning). Daha önce tek boyutta aralıklara ayırmak için geom_histogram() ve geom_freqpoly()’yi kullandınız. Şimdi iki boyutta aralıklara ayırmak için geom_bin2d() ve geom_hex()’i nasıl kullanacağınızı öğreneceksiniz.
geom_bin2d() ve geom_hex(), koordinat düzlemini iki boyutlu aralıklara böler ve her aralığa kaç nokta düştüğünü göstermek için dolgu rengini kullanır. geom_bin2d() dikdörtgen, geom_hex() ise altıgen aralıklar oluşturur. geom_hex()’i kullanmak için hexbin paketini kurmanız gerekecektir.
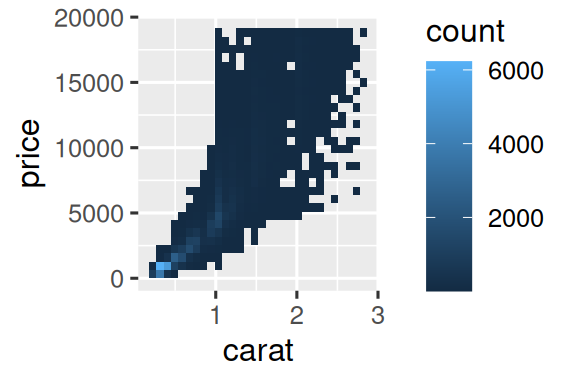
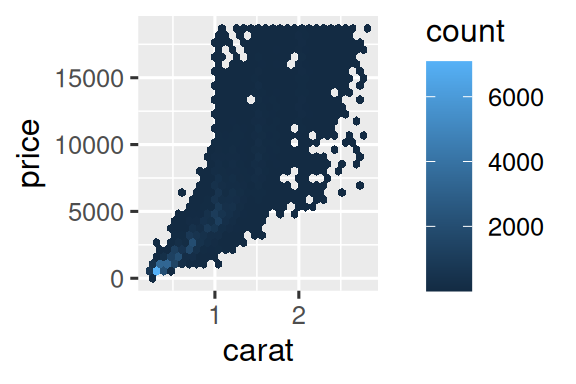
Başka bir seçenek, sürekli bir değişkeni kategorik bir değişken gibi davranacak biçimde aralıklara ayırmaktır. Ardından, öğrendiğiniz kategorik ve sürekli bir değişkenin kombinasyonunu görselleştirme tekniklerinden birini kullanabilirsiniz. Örneğin, carat’ı aralıklara ayırabilir ve ardından her grup için bir kutu grafiği gösterebilirsiniz:
ggplot(smaller, aes(x = carat, y = price)) +
  geom_boxplot(aes(group = cut_width(carat, 0.1)))
#> Warning: Orientation is not uniquely specified when both the x and y aesthetics are
#> continuous. Picking default orientation 'x'.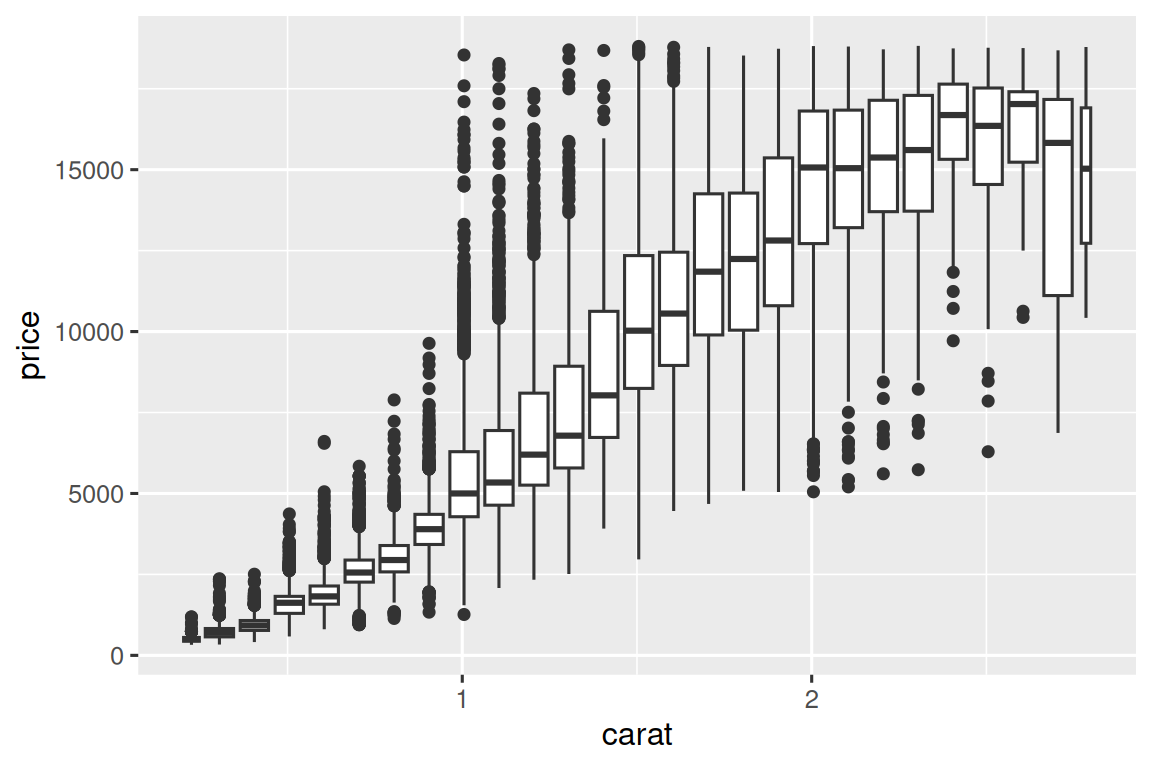
Yukarıda kullanıldığı gibi cut_width(x, width), x’i width genişliğinde aralıklara böler. Varsayılan olarak, kutu grafikleri kaç gözlem olursa olsun (aykırı değer sayısı hariç) kabaca aynı görünür, bu yüzden her kutu grafiğinin farklı sayıda noktayı özetlediğini söylemek zordur. Bunu göstermenin bir yolu, varwidth = TRUE ile kutu grafiğinin genişliğini nokta sayısıyla orantılı yapmaktır.
10.5.3.1 Alıştırmalar
Koşullu dağılımı bir kutu grafiğiyle özetlemek yerine, bir frekans poligonu kullanabilirsiniz.
cut_width()’icut_number()’a karşı kullanırken neyi göz önünde bulundurmanız gerekir? Bu,caratveprice’ın 2 boyutlu dağılımının görselleştirmesini nasıl etkiler?price’a göre bölümlenmişcarat’ın dağılımını görselleştirin.Çok büyük elmasların fiyat dağılımı, küçük elmaslarla nasıl karşılaştırılır? Beklediğiniz gibi mi, yoksa sizi şaşırtıyor mu?
cut, carat ve price’ın birleşik dağılımını görselleştirmek için öğrendiğiniz tekniklerden ikisini birleştirin.
-
İki boyutlu grafikler, tek boyutlu grafiklerde görünmeyen aykırı değerleri ortaya çıkarır. Örneğin, aşağıdaki grafikteki bazı noktalar olağandışı bir
xveydeğeri kombinasyonuna sahiptir; bu daxveydeğerleri ayrı ayrı incelendiğinde normal görünse bile bu noktaları aykırı değer yapar. Bu durumda bir saçılım grafiği neden aralıklara ayrılmış bir grafikten daha iyi bir gösterimdir?diamonds |> filter(x >= 4) |> ggplot(aes(x = x, y = y)) + geom_point() + coord_cartesian(xlim = c(4, 11), ylim = c(4, 11)) -
cut_width()ile eşit genişlikte aralıklar oluşturmak yerine,cut_number()ile kabaca eşit sayıda nokta içeren aralıklar oluşturabiliriz. Bu yaklaşımın avantajları ve dezavantajları nelerdir?ggplot(smaller, aes(x = carat, y = price)) + geom_boxplot(aes(group = cut_number(carat, 20)))
10.6 Örüntüler ve modeller
İki değişken arasında sistematik bir ilişki varsa, bu veride bir örüntü olarak ortaya çıkacaktır. Bir örüntü fark ederseniz, kendinize sorun:
Bu örüntü bir rastlantıdan (yani rastgele şans) kaynaklanıyor olabilir mi?
Örüntünün ima ettiği ilişkiyi nasıl tanımlayabilirsiniz?
Örüntünün ima ettiği ilişki ne kadar güçlü?
Başka hangi değişkenler ilişkiyi etkileyebilir?
Verinin ayrı alt gruplarına bakarsanız ilişki değişiyor mu?
Verinizdeki örüntüler ilişkiler hakkında ipuçları sağlar; yani kovaryasyonu ortaya çıkarırlar. Varyasyonu belirsizlik yaratan bir olgu olarak düşünürseniz, kovaryasyon onu azaltan bir olgudur. İki değişken birlikte değişirse, bir değişkenin değerlerini diğerinin değerleri hakkında daha iyi tahminler yapmak için kullanabilirsiniz. Kovaryasyon nedensel bir ilişkiden kaynaklanıyorsa (özel bir durum), bir değişkenin değerini diğerinin değerini kontrol etmek için kullanabilirsiniz.
Modeller, veriden örüntüleri çıkarmak için bir araçtır. Örneğin, diamonds verisini ele alın. Hem cut ile carat hem de carat ile price yakından ilişkili olduğundan, cut ile price arasındaki ilişkiyi anlamak zordur. Geriye kalan incelikleri keşfedebilmek için price ile carat arasındaki çok güçlü ilişkiyi bir model yardımıyla ayırabiliriz. Aşağıdaki kod, carat’tan price’ı tahmin eden bir model uydurur ve ardından artıkları (residuals) (tahmin edilen değer ile gerçek değer arasındaki fark) hesaplar. Artıklar, carat’ın etkisi çıkarıldıktan sonra elmas fiyatına ilişkin bir görünüm sunar. price ve carat’ın ham değerlerini kullanmak yerine önce logaritmalarını alıyor, ardından logaritmik değerlere bir model uyduruyoruz. Son olarak artıkları ham fiyat ölçeğine döndürmek için üstel dönüşüm uyguluyoruz.
library(tidymodels)

diamonds <- diamonds |>
  mutate(
    log_price = log(price),
    log_carat = log(carat)
  )

diamonds_fit <- linear_reg() |>
  fit(log_price ~ log_carat, data = diamonds)

diamonds_aug <- augment(diamonds_fit, new_data = diamonds) |>
  mutate(.resid = exp(.resid))

ggplot(diamonds_aug, aes(x = carat, y = .resid)) +
  geom_point()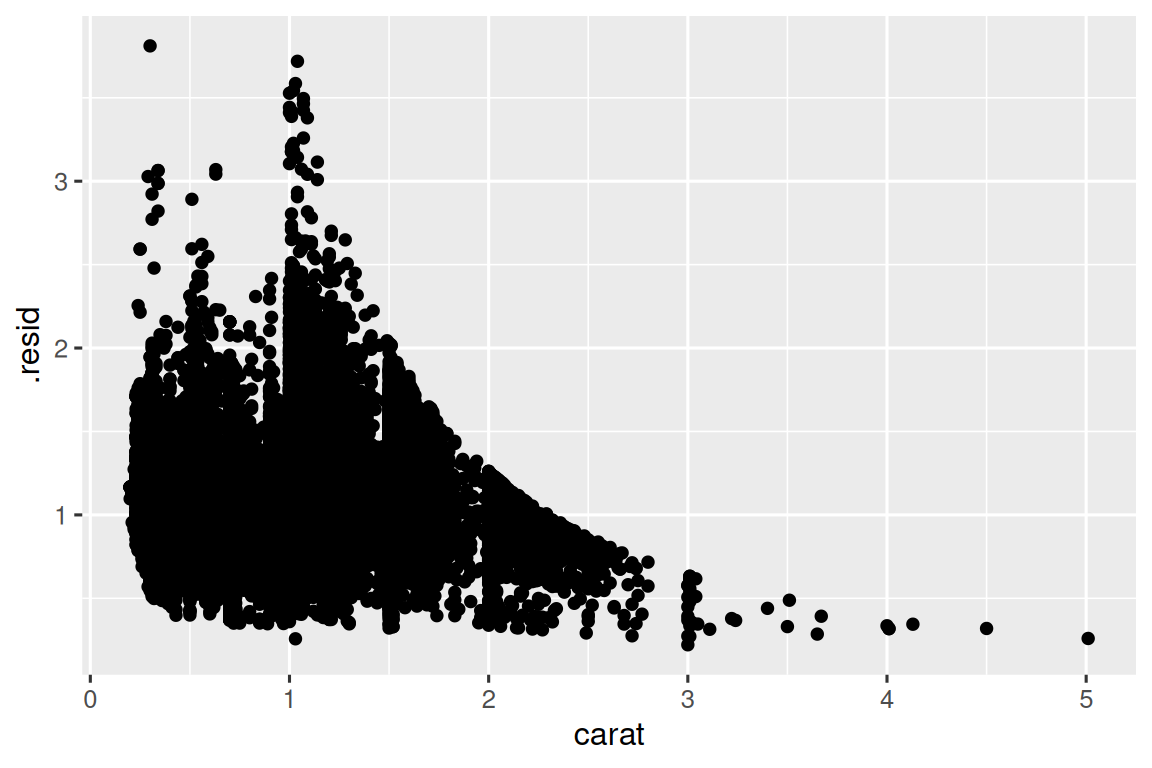
carat ile price arasındaki güçlü ilişkiyi kaldırdığınızda, cut ile price ilişkisinde beklediğiniz örüntüyü görebilirsiniz: aynı boyuttaki elmaslar arasında daha kaliteli olanlar daha pahalıdır.
ggplot(diamonds_aug, aes(x = cut, y = .resid)) +
  geom_boxplot()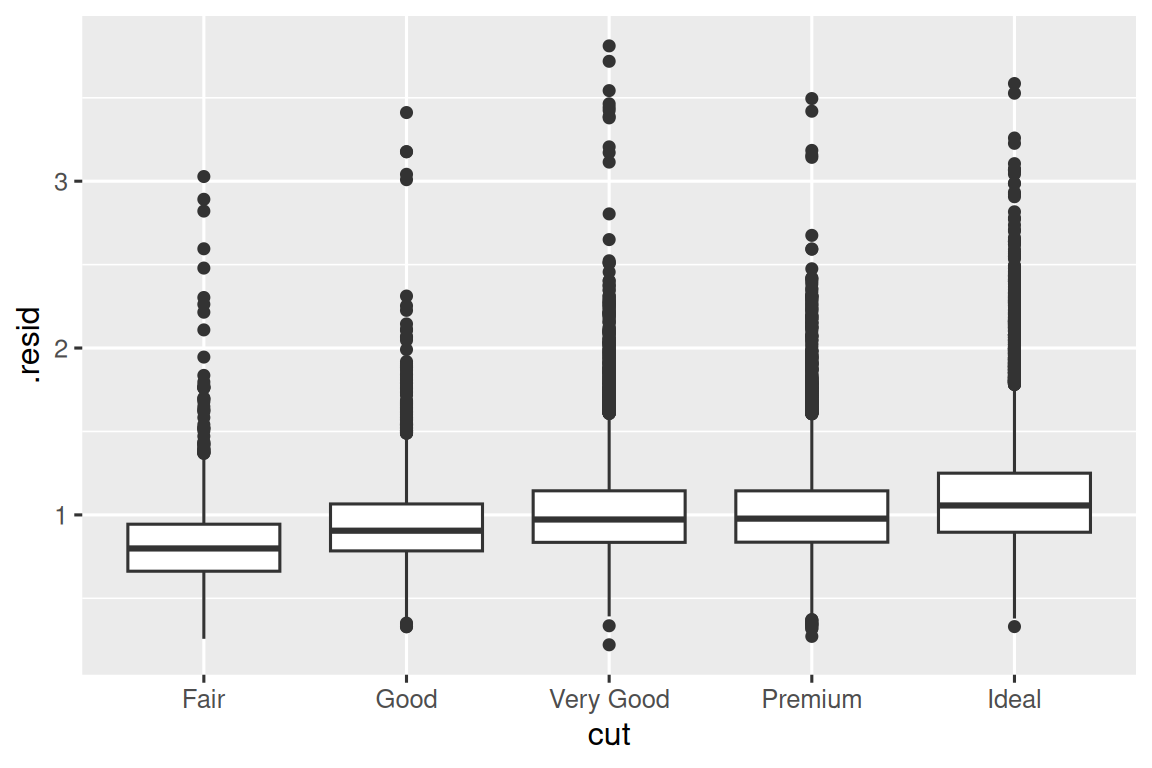
Bu kitapta modellemeyi tartışmıyoruz; çünkü modellerin ne olduğunu ve nasıl çalıştığını anlamak, elinizde veri düzenleme ve programlama araçları olduğunda en kolaydır.
10.7 Özet
Bu bölümde, verinizdeki varyasyonu anlamanıza yardımcı olacak çeşitli araçlar öğrendiniz. Aynı anda tek bir değişkenle ve bir çift değişkenle çalışan teknikler gördünüz. Verinizde onlarca veya yüzlerce değişken varsa bu can sıkıcı derecede kısıtlayıcı görünebilir; ama bunlar, diğer tüm tekniklerin üzerine inşa edildiği temeldir.
Bir sonraki bölümde, sonuçlarımızı iletmek için kullanabileceğimiz araçlara odaklanacağız.
Bir fonksiyonun (veya veri kümesinin) nereden geldiği konusunda açık olmamız gerektiğinde,
paket::fonksiyon()veyapaket::veri_kümesiözel biçimini kullanacağımızı hatırlayın.↩︎