14 Karakter dizileri
14.1 Giriş
Şimdiye kadar ayrıntılarını pek öğrenmeden birçok karakter dizisi kullandınız. Artık bunları derinlemesine inceleme, nasıl çalıştıklarını öğrenme ve elinizdeki güçlü karakter dizisi işleme araçlarında ustalaşma zamanı.
Karakter dizileri ve karakter vektörleri oluşturmanın ayrıntılarıyla başlayacağız. Ardından verilerden karakter dizileri oluşturmayı ve bunun tersini, yani karakter dizilerinden veri çıkarmayı inceleyeceksiniz. Sonra tek tek harflerle çalışan araçları ele alacağız. Bölümü, İngilizceye dayalı beklentilerinizin başka dillerle çalışırken sizi nerelerde yanıltabileceğini kısaca tartışarak tamamlayacağız.
Düzenli ifadelerin gücünü öğreneceğiniz sonraki bölümde karakter dizileriyle çalışmayı sürdüreceğiz.
14.1.1 Ön koşullar
Bu bölümde temel tidyverse’in bir parçası olan stringr paketindeki fonksiyonları kullanacağız. Ayrıca üzerinde çalışması eğlenceli karakter dizileri sunduğu için babynames verilerinden yararlanacağız.
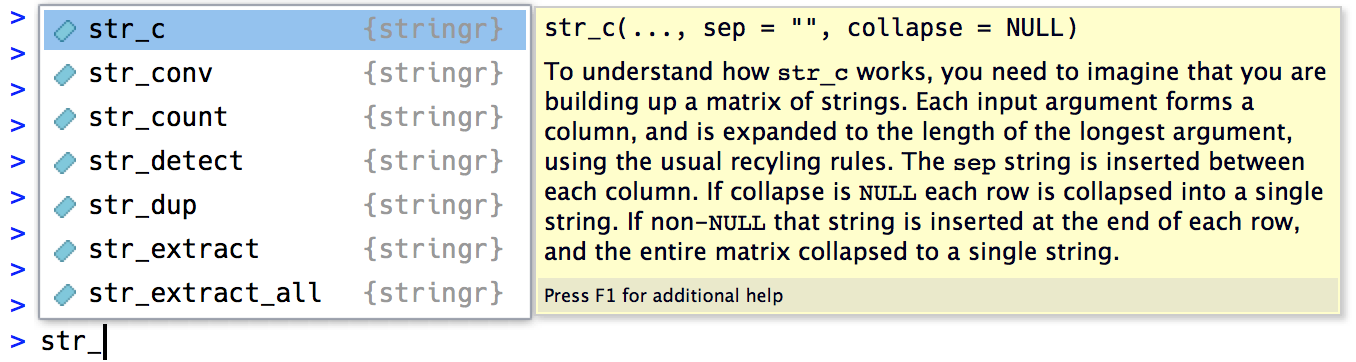
Tüm stringr fonksiyonları str_ ile başladığından bir stringr fonksiyonu kullandığınızı kolayca anlayabilirsiniz. Bu özellik özellikle RStudio’da yararlıdır: str_ yazdığınızda otomatik tamamlama açılır ve kullanılabilir fonksiyonları hatırlamanıza yardımcı olur.
14.2 Karakter dizisi oluşturma
Kitabın önceki bölümlerinde karakter dizileri oluşturduk, ancak ayrıntıları ele almadık. Bir karakter dizisini tek (') veya çift (") tırnakla oluşturabilirsiniz. İkisi arasında davranış farkı yoktur. Bu nedenle tidyverse stil rehberi, tutarlılık adına karakter dizisi birden fazla " içermediği sürece " kullanılmasını önerir.
string1 <- "This is a string"
string2 <- 'If I want to include a "quote" inside a string, I use single quotes'
Tırnağı kapatmayı unutursanız devam istemi olan + işaretini görürsünüz:
> "This is a string without a closing quote
+
+
+ HELP I'M STUCK IN A STRING
Bu durumla karşılaşır ve hangi tırnağı kapatmanız gerektiğini bulamazsanız işlemi iptal etmek için Escape tuşuna basıp yeniden deneyin.
14.2.1 Kaçış karakterleri
Bir karakter dizisine değişmez tek veya çift tırnak eklemek için \ ile tırnaktan “kaçabilirsiniz”:
double_quote <- "\"" # or '"'
single_quote <- '\'' # or "'"
Dolayısıyla karakter dizisine değişmez bir ters eğik çizgi eklemek için ondan da kaçmanız gerekir: "\\".
backslash <- "\\"Bir karakter dizisinin yazdırılan gösteriminin kendisiyle aynı olmadığına dikkat edin; yazdırılan gösterim kaçış karakterlerini de gösterir. Başka bir deyişle çıktıyı kopyalayıp yapıştırarak aynı karakter dizisini yeniden oluşturabilirsiniz. Karakter dizisinin ham içeriğini görmek için str_view()1 kullanın:
14.2.2 Ham karakter dizileri
Birden fazla tırnak veya ters eğik çizgi içeren karakter dizileri oluşturmak hızla kafa karıştırıcı hâle gelir. Sorunu göstermek için double_quote ve single_quote değişkenlerini tanımladığımız kod bloğunun içeriğini barındıran bir karakter dizisi oluşturalım:
tricky <- "double_quote <- \"\\\"\" # or '\"'
single_quote <- '\\'' # or \"'\""
str_view(tricky)
#> [1] │ double_quote <- "\"" # or '"'
#>     │ single_quote <- '\'' # or "'"
Ne kadar çok ters eğik çizgi var! Bu durum bazen eğik kürdan sendromu olarak adlandırılır. Kaçış karakterlerini ortadan kaldırmak için ham karakter dizisi2 kullanabilirsiniz:
tricky <- r"(double_quote <- "\"" # or '"'
single_quote <- '\'' # or "'")"
str_view(tricky)
#> [1] │ double_quote <- "\"" # or '"'
#>     │ single_quote <- '\'' # or "'"
Ham karakter dizisi genellikle r"( ile başlar ve )" ile biter. Karakter diziniz )" içeriyorsa r"[]" veya r"{}" kullanabilirsiniz. Bu da yeterli olmazsa açılış ve kapanış çiftlerini benzersiz kılmak için istediğiniz sayıda kısa çizgi ekleyebilirsiniz: r"--()--", r"---()---" vb. Ham karakter dizileri her türlü metni işleyebilecek kadar esnektir.
14.2.3 Diğer özel karakterler
", ' ve \ dışında yararlı olabilecek birkaç özel karakter daha vardır. En yaygın olanları yeni satırı belirten \n ve sekmeyi belirten \t karakterleridir. Bazen \u veya \U ile başlayan Unicode kaçışları içeren karakter dizileri de görürsünüz. Bunlar İngilizce dışındaki karakterleri tüm sistemlerde çalışacak biçimde yazmanın bir yoludur. Diğer özel karakterlerin tam listesini ?Quotes yardımında görebilirsiniz.
str_view() fonksiyonunun sekmeleri daha kolay fark edebilmeniz için süslü parantezlerle gösterdiğine dikkat edin3. Metinle çalışmanın zorluklarından biri, boşluk karakterlerinin metne birçok farklı biçimde girebilmesidir. Bu arka plan gösterimi, olağandışı bir durum olduğunu fark etmenize yardımcı olur.
14.2.4 Alıştırmalar
-
Aşağıdaki değerleri içeren karakter dizileri oluşturun:
He said "That's amazing!"\a\b\c\d\\\\\\
-
Aşağıdaki karakter dizisini R oturumunuzda oluşturup yazdırın. Özel “\u00a0” karakterine ne olur?
str_view()bunu nasıl gösterir? Bu özel karakterin ne olduğunu bulmak için internette kısa bir arama yapabilir misiniz?x <- "This\u00a0is\u00a0tricky"
14.3 Verilerden çok sayıda karakter dizisi oluşturma
Bir veya iki karakter dizisini “elle” oluşturmanın temellerini öğrendiğinize göre artık başka karakter dizilerinden yeni karakter dizileri oluşturmanın ayrıntılarına geçebiliriz. Bu bilgi, yazdığınız sabit bir metni veri çerçevesindeki karakter dizileriyle birleştirme gereksinimini çözmenize yardımcı olur. Örneğin bir selamlama oluşturmak için “Merhaba” metnini name değişkeniyle birleştirebilirsiniz. Bunu str_c() ve str_glue() ile nasıl yapacağınızı ve bu fonksiyonları mutate() ile nasıl kullanacağınızı göstereceğiz. Bu da doğal olarak summarize() ile hangi stringr fonksiyonlarının kullanılabileceği sorusunu doğurur. Bölümü, karakter dizileri için bir özet fonksiyonu olan str_flatten() ile tamamlayacağız.
14.3.1 str_c()
str_c() istediğiniz sayıda vektörü argüman olarak alır ve bir karakter vektörü döndürür:
str_c() temel R’daki paste0() fonksiyonuna çok benzer; ancak geri dönüşüm ve eksik değerlerin yayılmasıyla ilgili tidyverse kurallarına uyarak mutate() ile kullanılmak üzere tasarlanmıştır:
Eksik değerleri başka bir biçimde göstermek istiyorsanız bunları coalesce() ile değiştirin. İstediğiniz sonuca göre bu fonksiyonu str_c() çağrısının içinde veya dışında kullanabilirsiniz:
df |>
  mutate(
    greeting1 = str_c("Merhaba ", coalesce(name, "size"), "!"),
    greeting2 = coalesce(str_c("Merhaba ", name, "!"), "Merhaba!")
  )
#> # A tibble: 4 × 3
#>   name  greeting1      greeting2
#>   <chr> <chr>          <chr>
#> 1 Flora Merhaba Flora! Merhaba Flora!
#> 2 David Merhaba David! Merhaba David!
#> 3 Terra Merhaba Terra! Merhaba Terra!
#> 4 <NA>  Merhaba size!  Merhaba!
14.3.2 str_glue()
str_c() ile çok sayıda sabit ve değişken karakter dizisini karıştırdığınızda çok fazla " yazdığınızı ve bunun kodun genel amacını görmeyi zorlaştırdığını fark edersiniz. glue paketi, str_glue() aracılığıyla alternatif bir yaklaşım sunar4. Bu fonksiyona özel bir niteliği olan tek bir karakter dizisi verirsiniz: {} içindeki her şey tırnakların dışındaymış gibi değerlendirilir.
Gördüğünüz gibi str_glue() şu anda eksik değerleri "NA" karakter dizisine dönüştürür; bu da ne yazık ki str_c() ile tutarsızdır.
Karakter dizinize sıradan bir { veya } eklemeniz gerekirse ne olacağını da merak edebilirsiniz. Bunlardan bir biçimde kaçmanız gerektiğini düşündüyseniz doğru yoldasınız. Püf noktası, glue paketinin biraz farklı bir kaçış tekniği kullanmasıdır: başına \ gibi özel bir karakter eklemek yerine özel karakteri iki kez yazarsınız:
14.3.3 str_flatten()
str_c() ve str_glue() çıktıları girdileriyle aynı uzunlukta olduğu için mutate() ile iyi çalışır. Her zaman tek bir karakter dizisi döndüren, dolayısıyla summarize() ile iyi çalışan bir fonksiyon isterseniz ne yapmalısınız? Bu görev str_flatten() fonksiyonuna aittir5: bir karakter vektörü alır ve vektörün tüm elemanlarını tek bir karakter dizisinde birleştirir.
str_flatten(c("x", "y", "z"))
#> [1] "xyz"
str_flatten(c("x", "y", "z"), ", ")
#> [1] "x, y, z"
str_flatten(c("x", "y", "z"), ", ", last = " ve ")
#> [1] "x, y ve z"
Bu özellik summarize() ile iyi çalışmasını sağlar:
df <- tribble(
  ~ name, ~ fruit,
  "Carmen", "banana",
  "Carmen", "apple",
  "Marvin", "nectarine",
  "Terence", "cantaloupe",
  "Terence", "papaya",
  "Terence", "mandarin"
)
df |>
  group_by(name) |>
  summarize(fruits = str_flatten(fruit, ", "))
#> # A tibble: 3 × 2
#>   name    fruits
#>   <chr>   <chr>
#> 1 Carmen  banana, apple
#> 2 Marvin  nectarine
#> 3 Terence cantaloupe, papaya, mandarin
14.3.4 Alıştırmalar
-
Aşağıdaki girdiler için
paste0()vestr_c()sonuçlarını karşılaştırın: paste()ilepaste0()arasındaki fark nedir?paste()fonksiyonunun eşdeğerinistr_c()ile nasıl oluşturabilirsiniz?-
Aşağıdaki ifadeleri
str_c()fonksiyonundanstr_glue()fonksiyonuna veya tersine dönüştürün:str_c(food, " ürününün fiyatı ", price)str_glue("{age} yaşındayım ve {country} ülkesinde yaşıyorum")str_c("\\section{", title, "}")
14.4 Karakter dizilerinden veri çıkarma
Birden fazla değişkenin tek bir karakter dizisine sıkıştırılması çok yaygındır. Bu bölümde bunları çıkarmak için dört tidyr fonksiyonunu nasıl kullanacağınızı öğreneceksiniz:
df |> separate_longer_delim(col, delim)df |> separate_longer_position(col, width)df |> separate_wider_delim(col, delim, names)df |> separate_wider_position(col, widths)
Yakından bakarsanız ortak bir örüntü görebilirsiniz: separate_, ardından longer veya wider, sonra _, son olarak delim veya position. Bunun nedeni, bu dört fonksiyonun iki basit temel işlemin bileşiminden oluşmasıdır:
-
pivot_longer()vepivot_wider()fonksiyonlarında olduğu gibi_longerfonksiyonları yeni satırlar oluşturarak girdi veri çerçevesini uzatır;_widerfonksiyonlarıysa yeni sütunlar oluşturarak genişletir. -
delim, karakter dizisini", "veya" "gibi bir ayraçla;positionisec(3, 5, 2)gibi belirtilen genişliklerde böler.
Bu ailenin son üyesi separate_wider_regex() fonksiyonuna Bölüm 15 bölümünde döneceğiz. Bu, wider fonksiyonlarının en esneğidir; ancak kullanabilmek için düzenli ifadeler hakkında bilgi sahibi olmanız gerekir.
Sonraki iki bölüm, önce satırlara, ardından sütunlara ayırarak bu fonksiyonların temel fikrini gösterecek. Son olarak wider fonksiyonlarının sorunları tanılamak için sunduğu araçları ele alacağız.
14.4.1 Satırlara ayırma
Bir karakter dizisini satırlara ayırmak, bileşen sayısı satırdan satıra değiştiğinde en kullanışlıdır. En yaygın durum, bir ayraca göre bölmek için separate_longer_delim() kullanmaktır:
df1 <- tibble(x = c("a,b,c", "d,e", "f"))
df1 |>
  separate_longer_delim(x, delim = ",")
#> # A tibble: 6 × 1
#>   x
#>   <chr>
#> 1 a
#> 2 b
#> 3 c
#> 4 d
#> 5 e
#> 6 f
Gerçek verilerde separate_longer_position() fonksiyonuna daha az rastlanır; ancak bazı eski veri kümeleri her karakterin bir değeri kaydettiği oldukça sıkışık bir biçim kullanır:
df2 <- tibble(x = c("1211", "131", "21"))
df2 |>
  separate_longer_position(x, width = 1)
#> # A tibble: 9 × 1
#>   x
#>   <chr>
#> 1 1
#> 2 2
#> 3 1
#> 4 1
#> 5 1
#> 6 3
#> # ℹ 3 more rows
14.4.2 Sütunlara ayırma
Bir karakter dizisini sütunlara ayırmak, her dizide sabit sayıda bileşen bulunduğunda ve bunları sütunlara yaymak istediğinizde en kullanışlıdır. Sütunları adlandırmanız gerektiğinden bu fonksiyonlar longer karşılıklarından biraz daha karmaşıktır. Örneğin aşağıdaki veri kümesinde x, "." ile ayrılmış bir kod, baskı numarası ve yıldan oluşur. separate_wider_delim() kullanmak için ayracı ve adları iki ayrı argümanda belirtiriz:
df3 <- tibble(x = c("a10.1.2022", "b10.2.2011", "e15.1.2015"))
df3 |>
  separate_wider_delim(
    x,
    delim = ".",
    names = c("code", "edition", "year")
  )
#> # A tibble: 3 × 3
#>   code  edition year
#>   <chr> <chr>   <chr>
#> 1 a10   1       2022
#> 2 b10   2       2011
#> 3 e15   1       2015
Belirli bir parça yararlı değilse sonuçtan çıkarmak için ad olarak NA kullanabilirsiniz:
df3 |>
  separate_wider_delim(
    x,
    delim = ".",
    names = c("code", NA, "year")
  )
#> # A tibble: 3 × 2
#>   code  year
#>   <chr> <chr>
#> 1 a10   2022
#> 2 b10   2011
#> 3 e15   2015
Her sütunun genişliğini belirtmeniz gerektiğinden separate_wider_position() biraz farklı çalışır. Fonksiyona, adları yeni sütun adlarını ve değerleri sütunların kapladığı karakter sayısını belirten adlandırılmış bir tam sayı vektörü verirsiniz. Değerlere ad vermeyerek onları çıktıdan çıkarabilirsiniz:
df4 <- tibble(x = c("202215TX", "202122LA", "202325CA"))
df4 |>
  separate_wider_position(
    x,
    widths = c(year = 4, age = 2, state = 2)
  )
#> # A tibble: 3 × 3
#>   year  age   state
#>   <chr> <chr> <chr>
#> 1 2022  15    TX
#> 2 2021  22    LA
#> 3 2023  25    CA
14.4.3 Genişletme sorunlarını tanılama
separate_wider_delim()6 sabit ve bilinen bir sütun kümesi gerektirir. Bazı satırlarda beklenen sayıda parça yoksa ne olur? Parça sayısının çok az veya çok fazla olması biçiminde iki olası sorun vardır. separate_wider_delim() bunları ele almak için too_few ve too_many argümanlarını sunar. Önce aşağıdaki örnek veri kümesiyle too_few durumunu inceleyelim:
df <- tibble(a = c("1-1-1", "1-1-2", "1-3", "1-3-2", "1"))

df |>
  separate_wider_delim(
    a,
    delim = "-",
    names = c("x", "y", "z")
  )
#> Error in `separate_wider_delim()`:
#> ! Expected 3 pieces in each element of `a`.
#> ! 2 values were too short.
#> ℹ Use `too_few = "debug"` to diagnose the problem.
#> ℹ Use `too_few = "align_start"/"align_end"` to silence this message.
Bir hata aldığımızı, ancak hata iletisinin nasıl ilerleyebileceğimize ilişkin bazı öneriler sunduğunu göreceksiniz. Sorunun hatalarını ayıklayarak başlayalım:
debug <- df |>
  separate_wider_delim(
    a,
    delim = "-",
    names = c("x", "y", "z"),
    too_few = "debug"
  )
#> Warning: Debug mode activated: adding variables `a_ok`, `a_pieces`, and
#> `a_remainder`.
debug
#> # A tibble: 5 × 7
#>   x     y     z     a     a_ok  a_pieces a_remainder
#>   <chr> <chr> <chr> <chr> <lgl>    <int> <chr>
#> 1 1     1     1     1-1-1 TRUE         3 ""
#> 2 1     1     2     1-1-2 TRUE         3 ""
#> 3 1     3     <NA>  1-3   FALSE        2 ""
#> 4 1     3     2     1-3-2 TRUE         3 ""
#> 5 1     <NA>  <NA>  1     FALSE        1 ""
Hata ayıklama kipini kullandığınızda çıktıya üç ek sütun eklenir: a_ok, a_pieces ve a_remainder. Farklı adlı bir değişkeni ayırırsanız farklı bir önek elde edersiniz. Burada a_ok, başarısız girdileri hızla bulmanızı sağlar:
debug |> filter(!a_ok)
#> # A tibble: 2 × 7
#>   x     y     z     a     a_ok  a_pieces a_remainder
#>   <chr> <chr> <chr> <chr> <lgl>    <int> <chr>
#> 1 1     3     <NA>  1-3   FALSE        2 ""
#> 2 1 <NA> <NA> 1 FALSE 1 ""a_pieces, beklenen 3 parçaya (names uzunluğuna) karşılık kaç parça bulunduğunu gösterir. Parça sayısı çok az olduğunda a_remainder yararlı değildir; ancak birazdan onu yeniden göreceğiz.
Bazen bu hata ayıklama bilgileri ayraç stratejinizdeki bir sorunu ortaya çıkarır veya ayırmadan önce daha fazla ön işleme yapmanız gerektiğini gösterir. Bu durumda sorunu önceki adımlarda düzeltin ve yeni sorunların hata oluşturmasını sağlamak için too_few = "debug" ifadesini kaldırmayı unutmayın.
Bazı durumlarda eksik parçaları NA ile doldurup devam etmek isteyebilirsiniz. NA değerlerinin nereye yerleştirileceğini belirlemenizi sağlayan too_few = "align_start" ve too_few = "align_end" bunun içindir:
df |>
  separate_wider_delim(
    a,
    delim = "-",
    names = c("x", "y", "z"),
    too_few = "align_start"
  )
#> # A tibble: 5 × 3
#>   x     y     z
#>   <chr> <chr> <chr>
#> 1 1     1     1
#> 2 1     1     2
#> 3 1     3     <NA>
#> 4 1     3     2
#> 5 1     <NA>  <NA>
Parça sayısı çok fazla olduğunda da aynı ilkeler geçerlidir:
df <- tibble(a = c("1-1-1", "1-1-2", "1-3-5-6", "1-3-2", "1-3-5-7-9"))

df |>
  separate_wider_delim(
    a,
    delim = "-",
    names = c("x", "y", "z")
  )
#> Error in `separate_wider_delim()`:
#> ! Expected 3 pieces in each element of `a`.
#> ! 2 values were too long.
#> ℹ Use `too_many = "debug"` to diagnose the problem.
#> ℹ Use `too_many = "drop"/"merge"` to silence this message.
Ancak bu kez sonucun hatalarını ayıkladığımızda a_remainder sütununun amacını görebiliriz:
debug <- df |>
  separate_wider_delim(
    a,
    delim = "-",
    names = c("x", "y", "z"),
    too_many = "debug"
  )
#> Warning: Debug mode activated: adding variables `a_ok`, `a_pieces`, and
#> `a_remainder`.
debug |> filter(!a_ok)
#> # A tibble: 2 × 7
#>   x     y     z     a         a_ok  a_pieces a_remainder
#>   <chr> <chr> <chr> <chr>     <lgl>    <int> <chr>
#> 1 1     3     5     1-3-5-6   FALSE        4 -6
#> 2 1     3     5     1-3-5-7-9 FALSE        5 -7-9
Çok fazla parçayı ele almak için biraz farklı seçenekleriniz vardır: ek parçaları sessizce “düşürebilir” (drop) veya tümünü son sütunda “birleştirebilirsiniz” (merge):
df |>
  separate_wider_delim(
    a,
    delim = "-",
    names = c("x", "y", "z"),
    too_many = "drop"
  )
#> # A tibble: 5 × 3
#>   x     y     z
#>   <chr> <chr> <chr>
#> 1 1     1     1
#> 2 1     1     2
#> 3 1     3     5
#> 4 1     3     2
#> 5 1     3     5


df |>
  separate_wider_delim(
    a,
    delim = "-",
    names = c("x", "y", "z"),
    too_many = "merge"
  )
#> # A tibble: 5 × 3
#>   x     y     z
#>   <chr> <chr> <chr>
#> 1 1     1     1
#> 2 1     1     2
#> 3 1     3     5-6
#> 4 1     3     2
#> 5 1     3     5-7-9
14.5 Harfler
Bu bölümde bir karakter dizisindeki tek tek harflerle çalışmanızı sağlayan fonksiyonları tanıtacağız. Bir karakter dizisinin uzunluğunu bulmayı, alt dizileri çıkarmayı ve grafiklerle tablolardaki uzun karakter dizilerini ele almayı öğreneceksiniz.
14.5.1 Uzunluk
str_length() karakter dizisindeki harf sayısını verir:
str_length(c("a", "R for data science", NA))
#> [1]  1 18 NA
ABD’deki bebek adlarının uzunluk dağılımını bulmak için bunu count() ile, 15 harften oluşan en uzun adları incelemek içinse filter() ile kullanabilirsiniz7:
babynames |>
  count(length = str_length(name), wt = n)
#> # A tibble: 14 × 2
#>   length        n
#>    <int>    <int>
#> 1      2   338150
#> 2      3  8589596
#> 3      4 48506739
#> 4      5 87011607
#> 5      6 90749404
#> 6      7 72120767
#> # ℹ 8 more rows

babynames |>
  filter(str_length(name) == 15) |>
  count(name, wt = n, sort = TRUE)
#> # A tibble: 34 × 2
#>   name                n
#>   <chr>           <int>
#> 1 Franciscojavier   123
#> 2 Christopherjohn   118
#> 3 Johnchristopher   118
#> 4 Christopherjame   108
#> 5 Christophermich    52
#> 6 Ryanchristopher    45
#> # ℹ 28 more rows
14.5.2 Alt kümeleme
Bir karakter dizisinin parçalarını str_sub(string, start, end) ile çıkarabilirsiniz; start ve end, alt dizinin başlayacağı ve biteceği konumlardır. start ve end konumları sonuca dâhil edildiğinden döndürülen dizinin uzunluğu end - start + 1 olur:
Karakter dizisinin sonundan geriye doğru saymak için negatif değerler kullanabilirsiniz: -1 son, -2 sondan ikinci karakterdir vb.
str_sub(x, -3, -1)
#> [1] "ple" "ana" "ear"
Karakter dizisi çok kısa olduğunda str_sub() fonksiyonunun başarısız olmayacağına dikkat edin; yalnızca mümkün olan kısmı döndürür:
str_sub("a", 1, 5)
#> [1] "a"
Her adın ilk ve son harfini bulmak için str_sub() fonksiyonunu mutate() ile kullanabiliriz:
babynames |>
  mutate(
    first = str_sub(name, 1, 1),
    last = str_sub(name, -1, -1)
  )
#> # A tibble: 1,924,665 × 7
#>    year sex   name          n   prop first last
#>   <dbl> <chr> <chr>     <int>  <dbl> <chr> <chr>
#> 1  1880 F     Mary       7065 0.0724 M     y
#> 2  1880 F     Anna       2604 0.0267 A     a
#> 3  1880 F     Emma       2003 0.0205 E     a
#> 4  1880 F     Elizabeth  1939 0.0199 E     h
#> 5  1880 F     Minnie     1746 0.0179 M     e
#> 6  1880 F     Margaret   1578 0.0162 M     t
#> # ℹ 1,924,659 more rows
14.5.3 Alıştırmalar
- Bebek adlarının uzunluk dağılımını hesaplarken neden
wt = nkullandık? - Her bebek adının ortasındaki harfi çıkarmak için
str_length()vestr_sub()kullanın. Karakter dizisi çift sayıda karakter içeriyorsa ne yapacaksınız? - Bebek adlarının uzunluğunda zaman içinde belirgin eğilimler var mı? İlk ve son harflerin popülerliği nasıl değişiyor?
14.6 İngilizce dışındaki metinler
Şimdiye kadar iki nedenle çalışması özellikle kolay olan İngilizce metinlere odaklandık. Birincisi, İngilizce alfabesi görece basittir ve yalnızca 26 harften oluşur. İkincisi ve belki de daha önemlisi, bugün kullandığımız bilişim altyapısı ağırlıklı olarak İngilizce konuşan kişiler tarafından tasarlanmıştır. Ne yazık ki İngilizce dışındaki dilleri kapsamlı biçimde ele alacak yerimiz yok. Yine de karşılaşabileceğiniz en büyük güçlüklerden bazılarına dikkatinizi çekmek istiyoruz: kodlama, harf çeşitleri ve yerel ayara bağlı fonksiyonlar.
14.6.1 Kodlama
İngilizce dışındaki metinlerle çalışırken ilk güçlük çoğunlukla kodlamadır (encoding). Neler olduğunu anlamak için bilgisayarların karakter dizilerini nasıl temsil ettiğini incelememiz gerekir. R’da bir karakter dizisinin temelindeki gösterime charToRaw() ile erişebiliriz:
charToRaw("Hadley")
#> [1] 48 61 64 6c 65 79
Bu altı onaltılık sayının her biri bir harfi temsil eder: 48, H; 61, a harfidir ve böyle devam eder. Onaltılık sayılarla karakterler arasındaki eşlemeye kodlama denir; bu örnekte kullanılan kodlamanın adı ASCII’dir. ASCII, American Standard Code for Information Interchange (Bilgi Değişimi için Amerikan Standart Kodu) olduğundan İngilizce karakterleri temsil etmede çok başarılıdır.
İngilizce dışındaki dillerde işler bu kadar kolay değildir. Bilgisayarların ilk dönemlerinde İngilizce dışındaki karakterleri kodlamak için birbiriyle rekabet eden birçok standart vardı. Örneğin Avrupa için iki farklı kodlama kullanılıyordu: Batı Avrupa dilleri için Latin1 (ISO-8859-1), Orta Avrupa dilleri için Latin2 (ISO-8859-2). Latin1 kodlamasında b1 baytı “±”, Latin2 kodlamasında ise “ą” karakteridir! Neyse ki bugün neredeyse her yerde desteklenen tek bir standart vardır: UTF-8. UTF-8, günümüzde insanların kullandığı hemen her karakteri ve emoji gibi birçok ek simgeyi kodlayabilir.
readr her yerde UTF-8 kullanır. Bu iyi bir varsayılandır; ancak UTF-8 kullanmayan eski sistemlerin ürettiği verilerde başarısız olur. Böyle bir durumda karakter dizileriniz yazdırıldığında tuhaf görünür. Bazen yalnızca bir iki karakter bozulur, bazen de tamamen anlamsız bir çıktı elde edersiniz. Örneğin aşağıda olağandışı kodlamalara sahip iki satır içi CSV vardır8:
Bunları doğru okumak için kodlamayı locale argümanıyla belirtirsiniz:
Doğru kodlamayı nasıl bulabilirsiniz? Şanslıysanız veri belgelerinde bir yerde belirtilmiştir. Ne yazık ki bu nadiren olur; bu nedenle readr kodlamayı bulmanıza yardımcı olmak için guess_encoding() fonksiyonunu sunar. Bu yöntem kusursuz değildir ve çok miktarda metin olduğunda buradakinden daha iyi çalışır; yine de başlamak için makul bir yerdir. Doğru kodlamayı bulmadan önce birkaç farklı seçeneği denemeniz gerekebilir.
Kodlamalar kapsamlı ve karmaşık bir konudur; burada yalnızca yüzeyine değindik. Daha fazla bilgi edinmek için http://kunststube.net/encoding/ adresindeki ayrıntılı açıklamayı okumanızı öneririz.
14.6.2 Harf çeşitleri
Aksan işaretleri kullanan dillerde harflerin konumunu, örneğin str_length() ve str_sub() ile belirlemek önemli bir güçlük yaratır. Aksanlı bir harf tek bir karakter (örneğin ü) olarak veya aksansız bir harfle (örneğin u) ayırıcı işaretin (örneğin ¨) birleştirilmesiyle iki karakter olarak kodlanabilir. Örneğin aşağıdaki kod, aynı görünen ü harfini temsil etmenin iki yolunu gösterir:
Ancak bu iki karakter dizisinin uzunlukları ve ilk karakterleri farklıdır:
str_length(u)
#> [1] 1 2
str_sub(u, 1, 1)
#> [1] "ü" "u"
Son olarak bu karakter dizilerini == ile karşılaştırmanın onları farklı kabul ettiğine, stringr paketindeki kullanışlı str_equal() fonksiyonunun ise aynı görünüme sahip olduklarını tanıdığına dikkat edin:
u[[1]] == u[[2]]
#> [1] FALSE

str_equal(u[[1]], u[[2]])
#> [1] TRUE
14.6.3 Yerel ayara bağlı fonksiyonlar
Son olarak davranışı yerel ayarınıza (locale) bağlı olan birkaç stringr fonksiyonu vardır. Yerel ayar dile benzer; ancak dil içindeki bölgesel farklılıkları ele almak için isteğe bağlı bir bölge belirteci de içerir. Küçük harfli dil kısaltmasıyla belirtilir; bunu isteğe bağlı olarak _ ve büyük harfli bölge tanımlayıcısı izler. Örneğin “en” İngilizceyi, “en_GB” Britanya İngilizcesini, “en_US” ise Amerikan İngilizcesini belirtir. Dilinizin kodunu bilmiyorsanız Wikipedia’da iyi bir liste bulabilir; stringr tarafından desteklenen kodları stringi::stri_locale_list() ile görebilirsiniz.
Temel R karakter dizisi fonksiyonları işletim sisteminizde ayarlanan yerel ayarı otomatik olarak kullanır. Bu sayede kendi dilinizde beklediğiniz gibi çalışırlar; ancak kodunuzu başka bir ülkede yaşayan biriyle paylaşırsanız farklı sonuçlar ortaya çıkabilir. stringr bu sorunu önlemek için varsayılan olarak “en” yerel ayarıyla İngilizce kurallarını kullanır ve bu davranışı değiştirmek için locale argümanını belirtmenizi ister. Neyse ki yerel ayarın gerçekten önemli olduğu yalnızca iki fonksiyon grubu vardır: büyük-küçük harf dönüştürme ve sıralama.
Büyük-küçük harf dönüştürme kuralları diller arasında değişir. Örneğin Türkçede noktalı ve noktasız olmak üzere iki i vardır. Bunlar farklı harfler olduğu için büyük harfe de farklı dönüştürülürler:
str_to_upper(c("i", "ı"))
#> [1] "I" "I"
str_to_upper(c("i", "ı"), locale = "tr")
#> [1] "İ" "I"
Karakter dizilerini sıralamak alfabenin düzenine bağlıdır ve alfabe sırası her dilde aynı değildir9! Örneğin Çekçede “ch”, alfabede h harfinden sonra gelen birleşik bir harftir.
Aynı sorun karakter dizilerini dplyr::arrange() ile sıralarken de ortaya çıktığından bu fonksiyon da locale argümanına sahiptir.
14.7 Özet
Bu bölümde stringr paketinin sunduğu olanakların bir bölümünü öğrendiniz: karakter dizileri oluşturmayı, birleştirmeyi ve bunlardan veri çıkarmayı; ayrıca İngilizce dışındaki metinlerde karşılaşabileceğiniz bazı güçlükleri gördünüz. Şimdi karakter dizileriyle çalışmanın en önemli ve güçlü araçlarından birini öğrenme zamanı: düzenli ifadeler. Karakter dizilerindeki kalıpları tanımlamak için son derece özlü ama ifade gücü yüksek bir dil sunan düzenli ifadeler, sonraki bölümün konusudur.
Temel R fonksiyonu
writeLines()da kullanılabilir.↩︎R 4.0.0 ve sonraki sürümlerde kullanılabilir.↩︎
str_view()sekmeleri, boşlukları, eşleşmeleri vb. öne çıkarmak için renk de kullanır. Renkler şu anda kitapta görünmez; ancak kodu etkileşimli çalıştırdığınızda bunları fark edersiniz.↩︎stringr kullanmıyorsanız fonksiyona doğrudan
glue::glue()ile de erişebilirsiniz.↩︎Temel R’daki karşılığı,
collapseargümanıyla kullanılanpaste()fonksiyonudur.↩︎Aynı ilkeler
separate_wider_position()veseparate_wider_regex()için de geçerlidir.↩︎Bu kayıtlara bakarak babynames verilerinin boşlukları veya kısa çizgileri kaldırdığını ve adları 15 harften sonra kestiğini tahmin edebiliriz.↩︎
Burada ikili verileri doğrudan karakter dizisine kodlamak için özel
\xgösterimini kullanıyorum.↩︎Çince gibi alfabesi olmayan dillerde sıralama daha da karmaşıktır.↩︎