Giriş
Veri bilimi, ham veriden anlayış, içgörü ve bilgi üretmenizi sağlayan heyecan verici bir disiplindir. “Veri Bilimi için R” kitabının amacı, veri bilimini verimli ve yeniden üretilebilir biçimde yürütmenizi sağlayacak en önemli R araçlarını öğrenmenize yardımcı olmak ve bu sırada biraz da eğlenmenizi sağlamaktır 😃. Bu kitabı okuduktan sonra R’ın en iyi yönlerinden yararlanarak çok çeşitli veri bilimi sorunlarının üstesinden gelebilecek araçlara sahip olacaksınız.
Neler öğreneceksiniz?
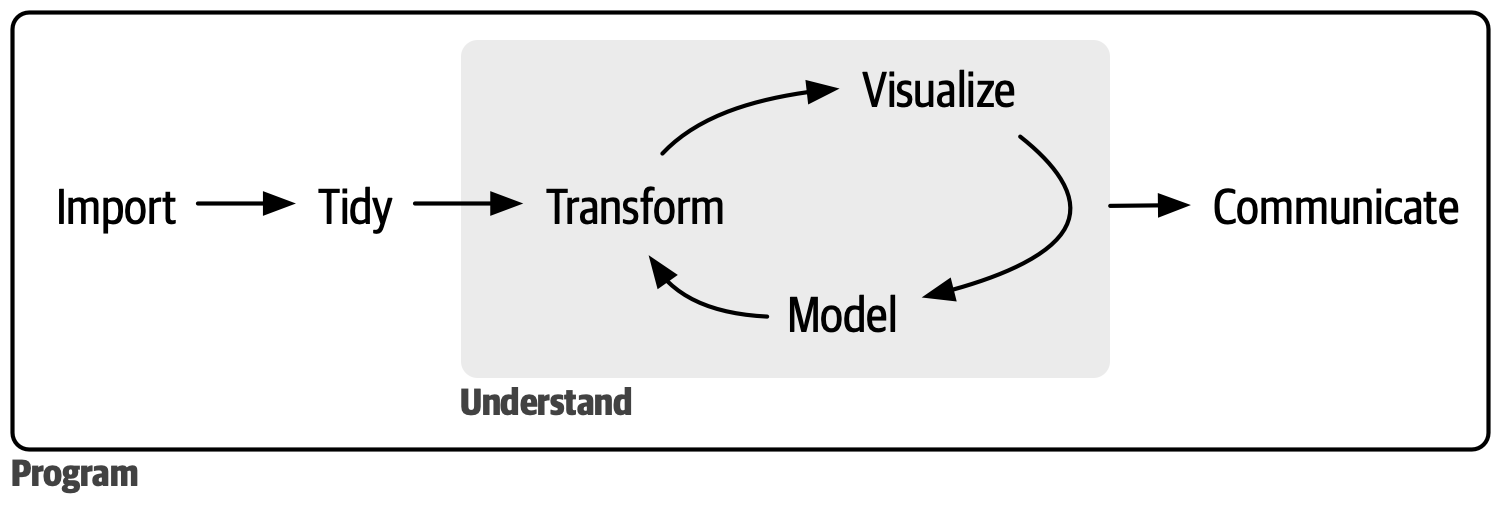
Veri bilimi uçsuz bucaksız bir alandır; tek bir kitap okuyarak bu alanın tamamında uzmanlaşmanız mümkün değildir. Bu kitap size en önemli araçlar konusunda sağlam bir temel ve gerektiğinde daha fazlasını öğrenebileceğiniz kaynakları bulmaya yetecek bilgi kazandırmayı amaçlıyor. Tipik bir veri bilimi projesinin adımlarına ilişkin modelimiz Şekil 1 üzerinde gösterilmiştir.
Öncelikle verilerinizi R’a içe aktarmalısınız. Bu işlem genellikle bir dosyada, veritabanında veya web uygulaması programlama arayüzünde (API) saklanan verileri alıp R’daki bir veri çerçevesine (data frame) yüklemek anlamına gelir. Verilerinizi R’a içe aktaramıyorsanız üzerlerinde veri bilimi de yapamazsınız!
Verilerinizi içe aktardıktan sonra düzenlemek iyi bir fikirdir. Verileri düzenlemek, veri kümesinin anlamsal yapısıyla saklanma biçiminin örtüştüğü tutarlı bir yapıda saklamak demektir. Kısacası verileriniz düzenliyse her sütun bir değişkeni, her satır da bir gözlemi temsil eder. Düzenli veri önemlidir; çünkü bu tutarlı yapı, enerjinizi farklı fonksiyonlar için verileri doğru biçime sokmakla uğraşmak yerine veriler hakkındaki soruları yanıtlamaya yöneltmenizi sağlar.
Düzenli verilere ulaştığınızda sonraki adım genellikle onları dönüştürmektir. Dönüştürme; ilgilendiğiniz gözlemlere odaklanmayı (belirli bir şehirdeki tüm insanlar veya geçen yıla ait tüm veriler gibi), mevcut değişkenlerin fonksiyonu olan yeni değişkenler oluşturmayı (mesafe ve süreden hız hesaplamak gibi) ve bir dizi özet istatistik hesaplamayı (sayımlar veya ortalamalar gibi) kapsar. Düzenleme ve dönüştürme işlemlerinin bütününe veri düzenleme (wrangling) denir; çünkü verileri çalışmaya elverişli ve doğal bir biçime sokmak çoğu zaman onlarla boğuşmayı andırır!
İhtiyacınız olan değişkenleri içeren düzenli verilere ulaştığınızda bilgi üretmenin iki ana motoru devreye girer: görselleştirme ve modelleme. Bunların birbirini tamamlayan güçlü ve zayıf yönleri vardır; dolayısıyla gerçek bir veri analizinde bu ikisi arasında defalarca gidip gelirsiniz.
Görselleştirme özünde insana özgü bir etkinliktir. İyi bir görselleştirme size beklemediğiniz şeyler gösterir veya veriler hakkında yeni sorular doğurur. Ayrıca yanlış soruyu sorduğunuza ya da farklı veriler toplamanız gerektiğine ilişkin ipuçları verebilir. Görselleştirmeler sizi şaşırtabilir, ancak yorumlanmaları için bir insana ihtiyaç duyduklarından pek iyi ölçeklenmezler.
Modeller, görselleştirmeyi tamamlayan araçlardır. Sorularınızı yeterince kesin hâle getirdiğinizde onları yanıtlamak için bir model kullanabilirsiniz. Modeller özünde matematiksel veya hesaplamalı araçlardır; bu nedenle genellikle iyi ölçeklenirler. Ölçeklenmediklerinde bile daha fazla bilgisayar satın almak, daha fazla insan beyni satın almaktan çoğu zaman daha ucuzdur! Ancak her model birtakım varsayımlarda bulunur ve doğası gereği kendi varsayımlarını sorgulayamaz. Bu nedenle bir model sizi gerçek anlamda şaşırtamaz.
Veri biliminin son adımı iletişimdir ve bu, her veri analizi projesinin kesinlikle vazgeçilmez bir parçasıdır. Sonuçlarınızı başkalarına aktaramıyorsanız modellerinizin ve görselleştirmelerinizin verileri ne kadar iyi anlamanızı sağladığının hiçbir önemi yoktur.
Tüm bu araçları çevreleyen unsur programlamadır. Programlama, bir veri bilimi projesinin hemen her aşamasında kullandığınız ve sürecin tamamına yayılan bir araçtır. Başarılı bir veri bilimci olmak için uzman bir programcı olmanız gerekmez, ancak programlama hakkında daha fazla şey öğrenmek karşılığını verir: Daha iyi bir programcı olmak, sık karşılaşılan görevleri otomatikleştirmenizi ve yeni sorunları daha kolay çözmenizi sağlar.
Bu araçları her veri bilimi projesinde kullanacaksınız, ancak çoğu proje için bunlar tek başına yeterli olmayacaktır. Burada kabaca bir 80/20 kuralı işler: Her projenin yaklaşık %80’ini bu kitapta öğreneceğiniz araçlarla ele alabilirsiniz, ancak kalan %20 için başka araçlara ihtiyaç duyarsınız. Kitap boyunca daha fazlasını öğrenebileceğiniz kaynaklara yönlendirmeler yapacağız.
Bu kitap nasıl düzenlendi?
Veri bilimi araçlarına ilişkin yukarıdaki açıklama, bu araçları bir analiz sırasında kabaca kullanacağınız sıraya göre düzenlenmiştir (elbette bu adımlardan defalarca geçeceksiniz). Ancak deneyimlerimize göre işe veri içe aktarmayı ve düzenlemeyi öğrenerek başlamak pek uygun değildir; çünkü bu süreç zamanın %80’inde sıradan ve sıkıcı, kalan %20’sinde ise tuhaf ve sinir bozucudur. Yeni bir konuyu öğrenmeye başlamak için hiç de iyi bir yer değil!
Bunun yerine, önceden içe aktarılıp düzenlenmiş verileri görselleştirmek ve dönüştürmekle başlayacağız. Böylece kendi verilerinizi içeri alıp düzenleme zamanı geldiğinde, çektiğiniz zahmete değeceğini bildiğiniz için motivasyonunuz yüksek kalacak.
Her bölümde tutarlı bir düzen izlemeye çalışıyoruz: Büyük resmi görebilmeniz için önce birkaç ilgi uyandırıcı örnek veriyor, ardından ayrıntılara giriyoruz. Kitabın her bölümü, öğrendiklerinizi uygulamanıza yardımcı olacak alıştırmalar içeriyor. Alıştırmaları atlamak cazip gelebilir, ancak gerçek sorunlar üzerinde pratik yapmaktan daha iyi bir öğrenme yolu yoktur.
Neler öğrenmeyeceksiniz?
Bu kitabın kapsamadığı birkaç önemli konu var. Olabildiğince çabuk işe koyulabilmeniz için temel konulara tavizsiz biçimde odaklanmanın önemli olduğuna inanıyoruz. Bu da kitabın her önemli konuyu ele alamayacağı anlamına geliyor.
Modelleme
Modelleme veri bilimi için son derece önemlidir, ancak çok geniş bir konudur ve ne yazık ki burada ona hak ettiği yeri ayıracak alanımız yok. Modelleme hakkında daha fazla bilgi edinmek için meslektaşlarımız Max Kuhn ve Julia Silge’nin yazdığı Tidy Modeling with R kitabını özellikle öneriyoruz. Bu kitap, adından da tahmin edebileceğiniz gibi, burada kullandığımız tidyverse paketleriyle pek çok ortak kurala sahip tidymodels paket ailesini öğretecek.
Büyük veri
Bu kitapta bilinçli bir tercihle öncelikle küçük, bellek içi (in-memory) veri kümelerine odaklanıyoruz. Başlamak için doğru yer burasıdır; çünkü küçük verilerle deneyim kazanmadan büyük verilerin üstesinden gelemezsiniz. Kitabın büyük bölümünde öğreneceğiniz araçlar yüzlerce megabaytlık veriyi kolayca işleyebilir; biraz dikkatle bu araçları birkaç gigabaytlık verilerle çalışmak için de kullanabilirsiniz. Ayrıca büyük verileri saklamakta sık kullanılan veritabanlarından ve parquet dosyalarından nasıl veri alacağınızı göstereceğiz. Her zaman veri kümesinin tamamıyla çalışamayabilirsiniz, ancak bu sorun değildir; çünkü ilgilendiğiniz soruyu yanıtlamak için genellikle verilerin bir alt kümesi veya alt örneklemi yeterlidir.
Düzenli olarak daha büyük verilerle (örneğin 10–100 GB) çalışıyorsanız data.table hakkında daha fazla bilgi edinmenizi öneriyoruz. Bu paketi burada öğretmiyoruz; çünkü tidyverse’den farklı bir arayüz kullanıyor ve başka kurallar öğrenmenizi gerektiriyor. Bununla birlikte inanılmaz derecede hızlıdır. Büyük verilerle çalışıyorsanız sağladığı performans artışı, onu öğrenmeye zaman ayırmaya değer.
Python, Julia ve arkadaşları
Bu kitapta Python, Julia veya veri bilimi için yararlı olan diğer programlama dilleri hakkında hiçbir şey öğrenmeyeceksiniz. Bunun nedeni bu araçların kötü olduğunu düşünmemiz değil. Kesinlikle değiller! Uygulamada çoğu veri bilimi ekibi farklı dilleri, genellikle de en azından R ile Python’ı birlikte kullanır. Ancak her seferinde tek bir araçta uzmanlaşmanın en iyisi olduğuna ve R’ın başlamak için harika bir seçenek olduğuna yürekten inanıyoruz.
Ön koşullar
Bu kitaptan en iyi şekilde yararlanabilmeniz için hâlihazırda bildiklerinize ilişkin birkaç varsayımda bulunduk. Genel bir sayısal okuryazarlığa sahip olmalısınız; ayrıca biraz programlama deneyiminizin olması yararlı olacaktır. Daha önce hiç programlama yapmadıysanız Garrett’ın yazdığı Hands on Programming with R kitabı bu kitap için değerli bir yardımcı kaynak olabilir.
Bu kitaptaki kodları çalıştırmak için dört şeye ihtiyacınız var: R, RStudio, tidyverse adlı bir R paketleri koleksiyonu ve birkaç ek paket. Paketler, yeniden üretilebilir R kodunun temel birimleridir. Yeniden kullanılabilir fonksiyonlar, bu fonksiyonların nasıl kullanılacağını açıklayan belgeler ve örnek veriler içerirler.
R
R’ı indirmek için Comprehensive R Archive Network (CRAN; Kapsamlı R Arşiv Ağı) adresine gidin: https://cloud.r-project.org. R’ın her yıl yeni bir ana sürümü, yıl içinde de iki veya üç ara sürümü yayımlanır. Düzenli olarak güncelleme yapmak iyi bir fikirdir. Özellikle tüm paketlerinizi yeniden kurmanızı gerektiren ana sürümlere geçmek biraz zahmetli olabilir, ancak ertelemek işleri daha da zorlaştırır. Bu kitap için R 4.2.0 veya daha yeni bir sürümünü kullanmanızı öneriyoruz.
RStudio
RStudio, R programlama için bir tümleşik geliştirme ortamıdır (integrated development environment, IDE) ve https://posit.co/download/rstudio-desktop/ adresinden indirilebilir. RStudio yılda birkaç kez güncellenir ve yeni bir sürüm çıktığında sizi otomatik olarak bilgilendirir; dolayısıyla sürekli kontrol etmeniz gerekmez. En yeni özelliklerden yararlanmak için düzenli olarak güncelleme yapmak iyi bir fikirdir. Bu kitap için en az RStudio 2022.02.0 sürümünü kullandığınızdan emin olun.
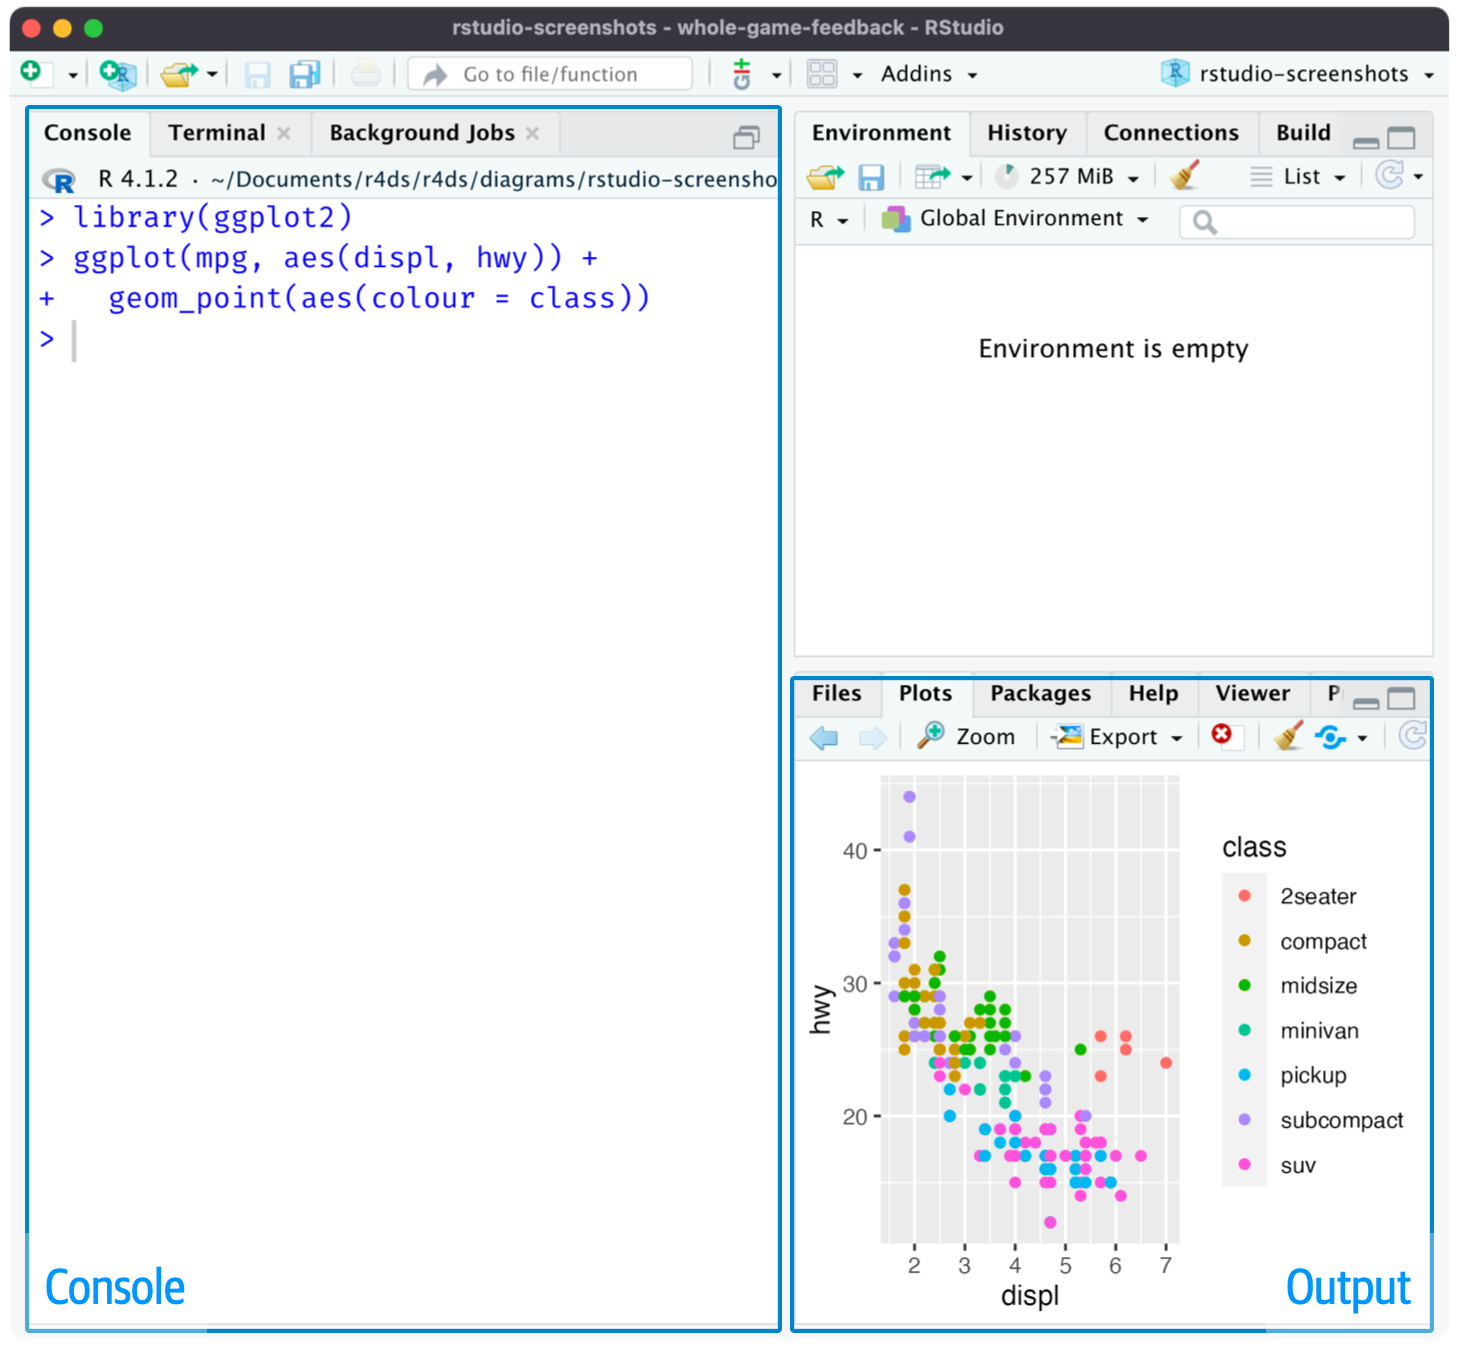
RStudio’yu başlattığınızda (Şekil 2) arayüzde iki temel bölge göreceksiniz: Console (Konsol) paneli ve Output (Çıktı) paneli. Şimdilik bilmeniz gereken tek şey, R kodunu Console paneline yazıp çalıştırmak için Enter tuşuna basacağınızdır. İlerledikçe daha fazlasını öğreneceksiniz!1
tidyverse
Bazı R paketlerini de kurmanız gerekecek. Bir R paketi, temel R’ın yeteneklerini genişleten fonksiyon, veri ve belge koleksiyonudur. R’ı başarıyla kullanmanın anahtarı paketlerden yararlanmaktır. Bu kitapta öğreneceğiniz paketlerin çoğu tidyverse’in parçasıdır. tidyverse’deki tüm paketler veri ve R programlama konusunda ortak bir felsefeyi paylaşır ve birlikte çalışacak şekilde tasarlanmıştır.
Tidyverse’in tamamını tek bir satır kodla kurabilirsiniz:
install.packages("tidyverse")Bu kod satırını bilgisayarınızdaki Console paneline yazın ve çalıştırmak için Enter tuşuna basın. R, paketleri CRAN’dan indirip bilgisayarınıza kuracaktır.
Bir paketi library() ile yükleyene kadar o paketteki fonksiyonları, nesneleri veya yardım dosyalarını kullanamazsınız. Paketi kurduktan sonra library() fonksiyonuyla yükleyebilirsiniz:
library(tidyverse)
#> ── Attaching core tidyverse packages ───────────────────── tidyverse 2.0.0 ──
#> ✔ dplyr     1.2.1     ✔ readr     2.2.0
#> ✔ forcats   1.0.1     ✔ stringr   1.6.0
#> ✔ ggplot2   4.0.3     ✔ tibble    3.3.1
#> ✔ lubridate 1.9.5     ✔ tidyr     1.3.2
#> ✔ purrr     1.2.2
#> ── Conflicts ─────────────────────────────────────── tidyverse_conflicts() ──
#> ✖ dplyr::filter() masks stats::filter()
#> ✖ dplyr::lag()    masks stats::lag()
#> ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors
Çıktı, tidyverse’in dokuz paket yüklediğini gösterir: dplyr, forcats, ggplot2, lubridate, purrr, readr, stringr, tibble ve tidyr. Neredeyse her analizde kullanacağınız bu paketler tidyverse’in çekirdeği kabul edilir.
tidyverse içindeki paketler oldukça sık güncellenir. tidyverse_update() fonksiyonunu çalıştırarak güncelleme olup olmadığını denetleyebilirsiniz.
Diğer paketler
Tidyverse’in parçası olmayan pek çok başka mükemmel paket de vardır; bunlar farklı alanlardaki sorunları çözer veya farklı temel ilkelerle tasarlanmıştır. Bu durum onları daha iyi ya da daha kötü değil, yalnızca farklı yapar. Başka bir deyişle tidyverse’in karşıtı messyverse değil, birbiriyle ilişkili paketlerden oluşan başka pek çok evrendir. R ile daha fazla veri bilimi projesi yaptıkça yeni paketler ve veriler hakkında yeni düşünme biçimleri öğreneceksiniz.
Bu kitapta tidyverse dışından da pek çok paket kullanacağız. Örneğin R’ı öğrenirken üzerinde çalışabileceğimiz ilginç veri kümeleri sundukları için şu paketlerden yararlanacağız:
install.packages(
  c("arrow", "babynames", "curl", "duckdb", "gapminder",
    "ggrepel", "ggridges", "ggthemes", "hexbin", "janitor", "Lahman",
    "leaflet", "maps", "nycflights13", "openxlsx", "palmerpenguins",
    "repurrrsive", "tidymodels", "writexl")
  )
Ayrıca tek seferlik örneklerde başka paketler de kullanacağız. Bunları şimdi kurmanız gerekmiyor; aşağıdaki gibi bir hata gördüğünüzde ne yapacağınızı hatırlamanız yeterli:
Paketi kurmak için install.packages("ggrepel") komutunu çalıştırmalısınız.
R kodunu çalıştırma
Önceki kısımda R kodunu çalıştırmaya ilişkin birkaç örnek gördünüz. Kitaptaki kod şöyle görünür:
1 + 2
#> [1] 3
Aynı kodu kendi konsolunuzda çalıştırırsanız şöyle görünür:
> 1 + 2
[1] 3
İki temel fark vardır. Kendi konsolunuzda istem (prompt) adı verilen > işaretinden sonra yazarsınız; kitapta ise istemi göstermiyoruz. Kitapta çıktılar #> ile yorum satırı biçiminde gösterilir; konsolunuzda ise doğrudan kodunuzun altında görünür. Bu iki fark sayesinde kitabın elektronik bir sürümünü kullanıyorsanız kodları kolayca kopyalayıp konsola yapıştırabilirsiniz.
Kitap boyunca koddan söz ederken tutarlı bir dizi kural kullanıyoruz:
Fonksiyonlar kod yazı tipinde gösterilir ve adlarının ardından
sum()veyamean()örneklerindeki gibi parantez gelir.Veri veya fonksiyon argümanı gibi diğer R nesneleri,
flightsvexörneklerindeki gibi parantezsiz olarak kod yazı tipinde gösterilir.Bazen bir nesnenin hangi paketten geldiğini belirtmek için paket adının ardından çift iki nokta (
::) kullanırız:dplyr::mutate()veyanycflights13::flights. Bu aynı zamanda geçerli bir R kodudur.
Teşekkür
Bu kitap yalnızca Hadley, Mine ve Garrett’ın eseri değildir; R topluluğundaki pek çok kişiyle yüz yüze ve çevrimiçi yaptığımız sayısız sohbetin sonucudur. Tüm bu sohbetler için hepinize ne kadar teşekkür etsek az; çok teşekkürler!
Bu kitap herkese açık olarak yazıldı ve birçok kişi pull request’ler aracılığıyla katkıda bulundu. GitHub pull request’leriyle iyileştirmeler sunan 259 kişiye özellikle teşekkür ederiz (kullanıcı adına göre alfabetik sırada): @a-rosenberg, Tim Becker (@a2800276), Abinash Satapathy (@Abinashbunty), Adam Gruer (@adam-gruer), adi pradhan (@adidoit), A. s. (@Adrianzo), Aep Hidyatuloh (@aephidayatuloh), Andrea Gilardi (@agila5), Ajay Deonarine (@ajay-d), @AlanFeder, Daihe Sui (@alansuidaihe), @alberto-agudo, @AlbertRapp, @aleloi, pete (@alonzi), Alex (@ALShum), Andrew M. (@amacfarland), Andrew Landgraf (@andland), @andyhuynh92, Angela Li (@angela-li), Antti Rask (@AnttiRask), LOU Xun (@aquarhead), @ariespirgel, @august-18, Michael Henry (@aviast), Azza Ahmed (@azzaea), Steven Moran (@bambooforest), Brian G. Barkley (@BarkleyBG), Mara Averick (@batpigandme), Oluwafemi OYEDELE (@BB1464), Brent Brewington (@bbrewington), Bill Behrman (@behrman), Ben Herbertson (@benherbertson), Ben Marwick (@benmarwick), Ben Steinberg (@bensteinberg), Benjamin Yeh (@bentyeh), Betul Turkoglu (@betulturkoglu), Brandon Greenwell (@bgreenwell), Bianca Peterson (@BinxiePeterson), Birger Niklas (@BirgerNi), Brett Klamer (@bklamer), @boardtc, Christian (@c-hoh), Caddy (@caddycarine), Camille V Leonard (@camillevleonard), @canovasjm, Cedric Batailler (@cedricbatailler), Christina Wei (@christina-wei), Christian Mongeau (@chrMongeau), Cooper Morris (@coopermor), Colin Gillespie (@csgillespie), Rademeyer Vermaak (@csrvermaak), Chloe Thierstein (@cthierst), Chris Saunders (@ctsa), Abhinav Singh (@curious-abhinav), Curtis Alexander (@curtisalexander), Christian G. Warden (@cwarden), Charlotte Wickham (@cwickham), Kenny Darrell (@darrkj), David Kane (@davidkane9), David (@davidrsch), David Rubinger (@davidrubinger), David Clark (@DDClark), Derwin McGeary (@derwinmcgeary), Daniel Gromer (@dgromer), @Divider85, @djbirke, Danielle Navarro (@djnavarro), Russell Shean (@DOH-RPS1303), Zhuoer Dong (@dongzhuoer), Devin Pastoor (@dpastoor), @DSGeoff, Devarshi Thakkar (@dthakkar09), Julian During (@duju211), Dylan Cashman (@dylancashman), Dirk Eddelbuettel (@eddelbuettel), Edwin Thoen (@EdwinTh), Ahmed El-Gabbas (@elgabbas), Henry Webel (@enryH), Ercan Karadas (@ercan7), Eric Kitaif (@EricKit), Eric Watt (@ericwatt), Erik Erhardt (@erikerhardt), Etienne B. Racine (@etiennebr), Everett Robinson (@evjrob), @fellennert, Flemming Miguel (@flemmingmiguel), Floris Vanderhaeghe (@florisvdh), @funkybluehen, @gabrivera, Garrick Aden-Buie (@gadenbuie), Peter Ganong (@ganong123), Gerome Meyer (@GeroVanMi), Gleb Ebert (@gl-eb), Josh Goldberg (@GoldbergData), bahadir cankardes (@gridgrad), Gustav W Delius (@gustavdelius), Hao Chen (@hao-trivago), Harris McGehee (@harrismcgehee), @hendrikweisser, Hengni Cai (@hengnicai), Iain (@Iain-S), Ian Sealy (@iansealy), Ian Lyttle (@ijlyttle), Ivan Krukov (@ivan-krukov), Jacob Kaplan (@jacobkap), Jazz Weisman (@jazzlw), John Blischak (@jdblischak), John D. Storey (@jdstorey), Gregory Jefferis (@jefferis), Jeffrey Stevens (@JeffreyRStevens), 蒋雨蒙 (@JeldorPKU), Jennifer (Jenny) Bryan (@jennybc), Jen Ren (@jenren), Jeroen Janssens (@jeroenjanssens), @jeromecholewa, Janet Wesner (@jilmun), Jim Hester (@jimhester), JJ Chen (@jjchern), Jacek Kolacz (@jkolacz), Joanne Jang (@joannejang), @johannes4998, John Sears (@johnsears), @jonathanflint, Jon Calder (@jonmcalder), Jonathan Page (@jonpage), Jon Harmon (@jonthegeek), JooYoung Seo (@jooyoungseo), Justinas Petuchovas (@jpetuchovas), Jordan (@jrdnbradford), Jeffrey Arnold (@jrnold), Jose Roberto Ayala Solares (@jroberayalas), Joyce Robbins (@jtr13), @juandering, Julia Stewart Lowndes (@jules32), Sonja (@kaetschap), Kara Woo (@karawoo), Katrin Leinweber (@katrinleinweber), Karandeep Singh (@kdpsingh), Kevin Perese (@kevinxperese), Kevin Ferris (@kferris10), Kirill Sevastyanenko (@kirillseva), Jonathan Kitt (@KittJonathan), @koalabearski, Kirill Müller (@krlmlr), Rafał Kucharski (@kucharsky), Kevin Wright (@kwstat), Noah Landesberg (@landesbergn), Lawrence Wu (@lawwu), @lindbrook, Luke W Johnston (@lwjohnst86), Kara de la Marck (@MarckK), Kunal Marwaha (@marwahaha), Matan Hakim (@matanhakim), Matthias Liew (@MatthiasLiew), Matt Wittbrodt (@MattWittbrodt), Mauro Lepore (@maurolepore), Mark Beveridge (@mbeveridge), @mcewenkhundi, mcsnowface, PhD (@mcsnowface), Matt Herman (@mfherman), Michael Boerman (@michaelboerman), Mitsuo Shiota (@mitsuoxv), Matthew Hendrickson (@mjhendrickson), @MJMarshall, Misty Knight-Finley (@mkfin7), Mohammed Hamdy (@mmhamdy), Maxim Nazarov (@mnazarov), Maria Paula Caldas (@mpaulacaldas), Mustafa Ascha (@mustafaascha), Nelson Areal (@nareal), Nate Olson (@nate-d-olson), Nathanael (@nateaff), @nattalides, Ned Western (@NedJWestern), Nick Clark (@nickclark1000), @nickelas, Nirmal Patel (@nirmalpatel), Nischal Shrestha (@nischalshrestha), Nicholas Tierney (@njtierney), Jakub Nowosad (@Nowosad), Nick Pullen (@nstjhp), @olivier6088, Olivier Cailloux (@oliviercailloux), Robin Penfold (@p0bs), Pablo E. Garcia (@pabloedug), Paul Adamson (@padamson), Penelope Y (@penelopeysm), Peter Hurford (@peterhurford), Peter Baumgartner (@petzi53), Patrick Kennedy (@pkq), Pooya Taherkhani (@pooyataher), Y. Yu (@PursuitOfDataScience), Radu Grosu (@radugrosu), Ranae Dietzel (@Ranae), Ralph Straumann (@rastrau), Rayna M Harris (@raynamharris), @ReeceGoding, Robin Gertenbach (@rgertenbach), Jajo (@RIngyao), Riva Quiroga (@rivaquiroga), Richard Knight (@RJHKnight), Richard Zijdeman (@rlzijdeman), @robertchu03, Robin Kohrs (@RobinKohrs), Robin (@Robinlovelace), Emily Robinson (@robinsones), Rob Tenorio (@robtenorio), Rod Mazloomi (@RodAli), Rohan Alexander (@RohanAlexander), Romero Morais (@RomeroBarata), Albert Y. Kim (@rudeboybert), Saghir (@saghirb), Hojjat Salmasian (@salmasian), Jonas (@sauercrowd), Vebash Naidoo (@sciencificity), Seamus McKinsey (@seamus-mckinsey), @seanpwilliams, Luke Smith (@seasmith), Matthew Sedaghatfar (@sedaghatfar), Sebastian Kraus (@sekR4), Sam Firke (@sfirke), Shannon Ellis (@ShanEllis), @shoili, Christian Heinrich (@Shurakai), S’busiso Mkhondwane (@sibusiso16), SM Raiyyan (@sm-raiyyan), Jakob Krigovsky (@sonicdoe), Stephan Koenig (@stephan-koenig), Stephen Balogun (@stephenbalogun), Steven M. Mortimer (@StevenMMortimer), Stéphane Guillou (@stragu), Sulgi Kim (@sulgik), Sergiusz Bleja (@svenski), Tal Galili (@talgalili), Alec Fisher (@Taurenamo), Todd Gerarden (@tgerarden), Tom Godfrey (@thomasggodfrey), Tim Broderick (@timbroderick), Tim Waterhouse (@timwaterhouse), TJ Mahr (@tjmahr), Thomas Klebel (@tklebel), Tom Prior (@tomjamesprior), Terence Teo (@tteo), @twgardner2, Ulrik Lyngs (@ulyngs), Shinya Uryu (@uribo), Martin Van der Linden (@vanderlindenma), Walter Somerville (@waltersom), @werkstattcodes, Will Beasley (@wibeasley), Yihui Xie (@yihui), Yiming (Paul) Li (@yimingli), @yingxingwu, Hiroaki Yutani (@yutannihilation), Yu Yu Aung (@yuyu-aung), Zach Bogart (@zachbogart), @zeal626, Zeki Akyol (@zekiakyol).
Yayın bilgileri
Kitabın çevrimiçi sürümüne https://r4ds.hadley.nz adresinden ulaşabilirsiniz. Bu sürüm, basılı kitabın yeniden basımları arasında gelişmeye devam edecektir. Kitabın kaynak dosyaları https://github.com/hadley/r4ds adresindedir. Kitap, metin ile çalıştırılabilir kodu bir araya getiren kitaplar yazmayı kolaylaştıran Quarto ile hazırlanmıştır.
RStudio’nun tüm özelliklerine dair kapsamlı bir genel bakış isterseniz, https://docs.posit.co/ide/user adresindeki RStudio Kullanıcı Kılavuzu’na bakabilirsiniz.↩︎