12 Mantıksal vektörler
12.1 Giriş
Bu bölümde mantıksal vektörlerle çalışmaya yönelik araçları öğreneceksiniz. Mantıksal vektörler en basit vektör türüdür; çünkü her eleman yalnızca üç olası değerden birini alabilir: TRUE, FALSE veya NA. Ham verilerde mantıksal vektörlere pek sık rastlanmaz; ancak hemen her analiz sırasında bunları oluşturur ve işlersiniz.
Mantıksal vektör oluşturmanın en yaygın yolu olan sayısal karşılaştırmalarla başlayacağız. Ardından farklı mantıksal vektörleri Boole cebiriyle birleştirmeyi ve bunları özetlemeye yarayan bazı fonksiyonları öğreneceksiniz. Son olarak mantıksal vektörlerden yararlanarak koşullu değişiklikler yapmanızı sağlayan if_else() ve case_when() fonksiyonlarını ele alacağız.
12.1.1 Ön koşullar
Bu bölümde öğreneceğiniz fonksiyonların çoğu temel R ile gelir; dolayısıyla tidyverse’e ihtiyacımız yoktur. Yine de veri çerçeveleri üzerinde mutate(), filter() ve benzeri fonksiyonları kullanabilmek için tidyverse’i yükleyeceğiz. Örneklerimizde nycflights13::flights veri kümesinden yararlanmaya devam edeceğiz.
Ne var ki ele aldığımız araçların sayısı arttıkça her konu için kusursuz bir gerçek yaşam örneği bulamayacağız. Bu nedenle c() ile bazı örnek veriler oluşturmaya başlayacağız:
x <- c(1, 2, 3, 5, 7, 11, 13)
x * 2
#> [1]  2  4  6 10 14 22 26
Bu yaklaşım tek tek fonksiyonları açıklamayı kolaylaştırırken, bunların kendi veri sorunlarınıza nasıl uygulanacağını görmeyi biraz zorlaştırabilir. Bağımsız bir vektör üzerinde yaptığımız her işlemi, mutate() ve benzeri fonksiyonlarla bir veri çerçevesindeki değişkene de uygulayabileceğinizi unutmayın.
12.2 Karşılaştırmalar
Mantıksal vektör oluşturmanın çok yaygın bir yolu, <, <=, >, >=, != ve == operatörleriyle sayısal karşılaştırmalar yapmaktır. Şimdiye kadar mantıksal değişkenleri çoğunlukla filter() içinde geçici olarak oluşturduk: hesaplandılar, kullanıldılar ve ardından atıldılar. Örneğin aşağıdaki filtre, gündüz kalkıp yaklaşık zamanında varan tüm uçuşları bulur:
flights |>
  filter(dep_time > 600 & dep_time < 2000 & abs(arr_delay) < 20)
#> # A tibble: 172,286 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      601            600         1      844            850
#> 2  2013     1     1      602            610        -8      812            820
#> 3  2013     1     1      602            605        -3      821            805
#> 4  2013     1     1      606            610        -4      858            910
#> 5  2013     1     1      606            610        -4      837            845
#> 6  2013     1     1      607            607         0      858            915
#> # ℹ 172,280 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Bunun bir kısayol olduğunu ve temelindeki mantıksal değişkenleri mutate() ile açıkça oluşturabileceğinizi bilmek yararlıdır:
flights |>
  mutate(
    daytime = dep_time > 600 & dep_time < 2000,
    approx_ontime = abs(arr_delay) < 20,
    .keep = "used"
  )
#> # A tibble: 336,776 × 4
#>   dep_time arr_delay daytime approx_ontime
#>      <int>     <dbl> <lgl>   <lgl>
#> 1      517        11 FALSE   TRUE
#> 2      533        20 FALSE   FALSE
#> 3      542        33 FALSE   FALSE
#> 4      544       -18 FALSE   TRUE
#> 5      554       -25 FALSE   FALSE
#> 6      554        12 FALSE   TRUE
#> # ℹ 336,770 more rows
Bu yaklaşım özellikle daha karmaşık mantıksal ifadelerde yararlıdır; ara adımları adlandırmak hem kodu okumayı hem de her adımın doğru hesaplanıp hesaplanmadığını denetlemeyi kolaylaştırır.
Sonuç olarak ilk filtre şuna eşdeğerdir:
12.2.1 Kayan noktalı sayıların karşılaştırılması
Sayılarla == kullanırken dikkatli olun. Örneğin şu vektör 1 ve 2 sayılarını içeriyor gibi görünür:
Ancak eşit olup olmadıklarını sınarsanız FALSE elde edersiniz:
x == c(1, 2)
#> [1] FALSE FALSE
Peki burada ne oluyor? Bilgisayarlar sayıları sabit sayıda ondalık basamakla saklar. Bu nedenle 1/49 veya sqrt(2) değerlerini tam olarak temsil etmek mümkün değildir ve sonraki hesaplamalarda çok küçük sapmalar oluşur. print() fonksiyonunu digits1 argümanıyla çağırarak tam değerleri görebiliriz:
print(x, digits = 16)
#> [1] 0.9999999999999999 2.0000000000000004
R’ın bu sayıları varsayılan olarak neden yuvarladığını görebilirsiniz: değerler gerçekten de beklediklerinize çok yakındır.
== operatörünün neden başarısız olduğunu gördüğümüze göre bu sorunu nasıl çözebiliriz? Seçeneklerden biri, küçük farkları yok sayan dplyr::near() fonksiyonunu kullanmaktır:
12.2.2 Eksik değerler
Eksik değerler bilinmeyeni temsil eder; dolayısıyla bir bakıma “bulaşıcıdır”: bilinmeyen bir değerin yer aldığı hemen her işlemin sonucu da bilinmeyen olur:
NA > 5
#> [1] NA
10 == NA
#> [1] NA
En kafa karıştırıcı sonuç şudur:
NA == NA
#> [1] NA
Biraz bağlam eklersek bunun neden böyle olduğunu daha kolay anlayabiliriz:
# Mary'nin kaç yaşında olduğunu bilmiyoruz
age_mary <- NA

# John'un kaç yaşında olduğunu bilmiyoruz
age_john <- NA

# Mary ve John aynı yaşta mı?
age_mary == age_john
#> [1] NA
# Bilmiyoruz!
Dolayısıyla dep_time değeri eksik olan tüm uçuşları bulmak istediğinizde aşağıdaki kod çalışmaz. Bunun nedeni, dep_time == NA ifadesinin her satır için NA üretmesi ve filter() fonksiyonunun eksik değerleri otomatik olarak elemesidir:
flights |>
  filter(dep_time == NA)
#> # A tibble: 0 × 19
#> # ℹ 19 variables: year <int>, month <int>, day <int>, dep_time <int>,
#> #   sched_dep_time <int>, dep_delay <dbl>, arr_time <int>, …
Bunun yerine yeni bir araca ihtiyacımız var: is.na().
12.2.3 is.na()
is.na(x) her vektör türüyle çalışır; eksik değerler için TRUE, diğer tüm değerler için FALSE döndürür:
dep_time değeri eksik olan tüm satırları is.na() ile bulabiliriz:
flights |>
  filter(is.na(dep_time))
#> # A tibble: 8,255 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1       NA           1630        NA       NA           1815
#> 2  2013     1     1       NA           1935        NA       NA           2240
#> 3  2013     1     1       NA           1500        NA       NA           1825
#> 4  2013     1     1       NA            600        NA       NA            901
#> 5  2013     1     2       NA           1540        NA       NA           1747
#> 6  2013     1     2       NA           1620        NA       NA           1746
#> # ℹ 8,249 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …is.na(), arrange() içinde de yararlı olabilir. arrange() normalde tüm eksik değerleri sona yerleştirir; ancak önce is.na() sonucuna göre sıralama yaparak bu varsayılan davranışı değiştirebilirsiniz:
flights |>
  filter(month == 1, day == 1) |>
  arrange(dep_time)
#> # A tibble: 842 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 836 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …

flights |>
  filter(month == 1, day == 1) |>
  arrange(desc(is.na(dep_time)), dep_time)
#> # A tibble: 842 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1       NA           1630        NA       NA           1815
#> 2  2013     1     1       NA           1935        NA       NA           2240
#> 3  2013     1     1       NA           1500        NA       NA           1825
#> 4  2013     1     1       NA            600        NA       NA            901
#> 5  2013     1     1      517            515         2      830            819
#> 6  2013     1     1      533            529         4      850            830
#> # ℹ 836 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Eksik değerleri Bölüm 18 bölümünde daha ayrıntılı ele alacağız.
12.2.4 Alıştırmalar
-
dplyr::near()nasıl çalışır? Kaynak kodunu görmek için konsolanearyazın.sqrt(2)^2, 2’ye yakın mıdır? -
dep_time,sched_dep_timevedep_delaydeğişkenlerindeki eksik değerlerin birbiriyle nasıl ilişkili olduğunu açıklamak içinmutate(),is.na()vecount()fonksiyonlarını birlikte kullanın.
12.3 Boole cebiri
Birden fazla mantıksal vektörünüz olduğunda bunları Boole cebiriyle birleştirebilirsiniz. R’da & “ve”, | “veya”, ! “değil”, xor() ise dışlayan veya2 anlamına gelir. Örneğin df |> filter(!is.na(x)), x değerinin eksik olmadığı tüm satırları; df |> filter(x < -10 | x > 0) ise x değerinin -10’dan küçük veya 0’dan büyük olduğu tüm satırları bulur. Şekil 12.1, sık kullanılan Boole işlemlerini ve bunların nasıl çalıştığını gösterir.
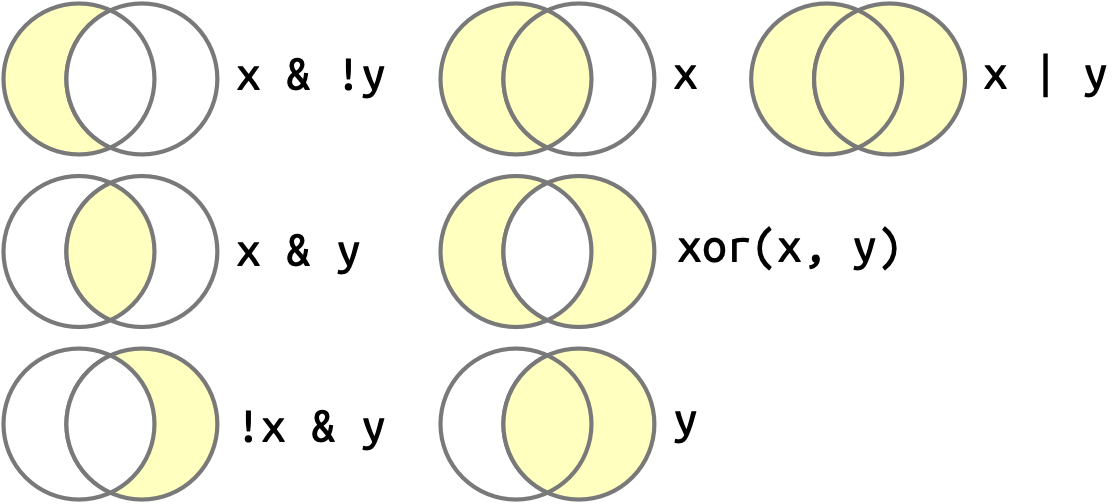
x soldaki, y sağdaki dairedir; taralı bölgeler her operatörün seçtiği alanları gösterir.
R’da & ve | operatörlerinin yanı sıra && ve || de vardır. Bunları dplyr fonksiyonlarında kullanmayın! Kısa devre operatörleri olarak adlandırılan bu operatörler yalnızca tek bir TRUE veya FALSE değeri döndürür. Veri biliminden çok programlama açısından önemlidirler.
12.3.1 Eksik değerler
Boole cebirinde eksik değerlere ilişkin kuralları açıklamak biraz zordur; çünkü ilk bakışta tutarsız görünürler:
Neler olduğunu anlamak için NA | TRUE (NA veya TRUE) ifadesini düşünün. Mantıksal bir vektördeki eksik değer, söz konusu değerin TRUE veya FALSE olabileceği anlamına gelir. TRUE | TRUE ve FALSE | TRUE ifadelerinin ikisi de TRUE sonucunu verir; çünkü değerlerden en az biri TRUE’dur. NA, TRUE veya FALSE olabileceği için NA | TRUE da mutlaka TRUE olmalıdır. Ancak NA değerinin TRUE mu yoksa FALSE mu olduğunu bilmediğimizden NA | FALSE sonucu NA olur. Her iki koşulun da sağlanması gerektiğini göz önünde bulundurduğumuzda & için de benzer bir akıl yürütme geçerlidir. Dolayısıyla NA değeri TRUE veya FALSE olabileceğinden NA & TRUE sonucu NA; koşullardan en az biri FALSE olduğundan NA & FALSE sonucu ise FALSE olur.
12.3.2 İşlem sırası
İşlem sırasının günlük dildeki gibi çalışmadığına dikkat edin. Kasım veya Aralık ayında kalkan tüm uçuşları bulan şu kodu ele alalım:
flights |>
   filter(month == 11 | month == 12)
Bunu günlük dilde söylediğiniz biçime benzer şekilde yazmak isteyebilirsiniz: “Kasım veya Aralık ayında kalkan tüm uçuşları bul”:
flights |>
   filter(month == 11 | 12)
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Bu kod hata vermez; ancak doğru çalışmış gibi de görünmez. Peki neler oluyor? R önce month == 11 ifadesini değerlendirerek nov adını vereceğimiz bir mantıksal vektör oluşturur. Ardından nov | 12 ifadesini hesaplar. Mantıksal bir operatörle sayı kullandığınızda R, 0 dışındaki her sayıyı TRUE değerine dönüştürür. Dolayısıyla bu ifade, sonucu her zaman TRUE olan nov | TRUE ifadesine eşdeğerdir ve tüm satırlar seçilir:
flights |>
  mutate(
    nov = month == 11,
    final = nov | 12,
    .keep = "used"
  )
#> # A tibble: 336,776 × 3
#>   month nov   final
#>   <int> <lgl> <lgl>
#> 1     1 FALSE TRUE
#> 2     1 FALSE TRUE
#> 3     1 FALSE TRUE
#> 4     1 FALSE TRUE
#> 5     1 FALSE TRUE
#> 6     1 FALSE TRUE
#> # ℹ 336,770 more rows
12.3.3 %in%
== ve | operatörlerini doğru sırada kullanma sorununu aşmanın kolay bir yolu %in% operatöründen yararlanmaktır. x %in% y, x ile aynı uzunlukta bir mantıksal vektör döndürür; x içindeki bir değer y içinde bulunduğunda karşılık gelen sonuç TRUE olur.
Dolayısıyla Kasım ve Aralık aylarındaki tüm uçuşları bulmak için şunu yazabiliriz:
NA %in% NA sonucu TRUE olduğundan, %in% operatörünün NA için == operatöründen farklı kurallar izlediğine dikkat edin.
Bu özellik yararlı bir kısayol sağlar:
flights |>
  filter(dep_time %in% c(NA, 0800))
#> # A tibble: 8,803 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      800            800         0     1022           1014
#> 2  2013     1     1      800            810       -10      949            955
#> 3  2013     1     1       NA           1630        NA       NA           1815
#> 4  2013     1     1       NA           1935        NA       NA           2240
#> 5  2013     1     1       NA           1500        NA       NA           1825
#> 6  2013     1     1       NA            600        NA       NA            901
#> # ℹ 8,797 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
12.3.4 Alıştırmalar
-
arr_delaydeğeri eksik, ancakdep_delaydeğeri eksik olmayan tüm uçuşları bulun. Hemarr_timehem desched_arr_timedeğerleri mevcut, ancakarr_delaydeğeri eksik olan tüm uçuşları bulun. - Kaç uçuşun
dep_timedeğeri eksiktir? Bu satırlarda başka hangi değişkenler eksiktir? Bu satırlar neyi temsil ediyor olabilir? - Eksik bir
dep_timedeğerinin uçuşun iptal edildiği anlamına geldiğini varsayarak günlük iptal edilen uçuş sayısını inceleyin. Bir örüntü var mı? İptal edilen uçuşların oranı ile iptal edilmeyen uçuşların ortalama gecikmesi arasında bir ilişki var mı?
12.4 Özetler
Aşağıdaki bölümlerde mantıksal vektörleri özetlemeye yönelik bazı yararlı teknikleri ele alacağız. Yalnızca mantıksal vektörlerle çalışan fonksiyonların yanı sıra sayısal vektörlerle çalışan fonksiyonlardan da yararlanabilirsiniz.
12.4.1 Mantıksal özetler
İki temel mantıksal özet fonksiyonu vardır: any() ve all(). any(x), | operatörüne eşdeğerdir; x içinde en az bir TRUE varsa TRUE döndürür. all(x), & operatörüne eşdeğerdir; yalnızca x içindeki tüm değerler TRUE olduğunda TRUE döndürür. Çoğu özet fonksiyonunda olduğu gibi na.rm = TRUE kullanarak eksik değerleri yok sayabilirsiniz.
Örneğin tüm uçuşların kalkışta en fazla bir saat gecikip gecikmediğini veya herhangi bir uçuşun varışta beş saat ya da daha fazla gecikip gecikmediğini all() ve any() ile bulabiliriz. group_by() kullanarak bu hesaplamayı gün bazında yapabiliriz:
flights |>
  group_by(year, month, day) |>
  summarize(
    all_delayed = all(dep_delay <= 60, na.rm = TRUE),
    any_long_delay = any(arr_delay >= 300, na.rm = TRUE),
    .groups = "drop"
  )
#> # A tibble: 365 × 5
#>    year month   day all_delayed any_long_delay
#>   <int> <int> <int> <lgl>       <lgl>
#> 1  2013     1     1 FALSE       TRUE
#> 2  2013     1     2 FALSE       TRUE
#> 3  2013     1     3 FALSE       FALSE
#> 4  2013     1     4 FALSE       FALSE
#> 5  2013     1     5 FALSE       TRUE
#> 6  2013     1     6 FALSE       FALSE
#> # ℹ 359 more rows
Ancak çoğu durumda any() ve all() biraz fazla kabadır; kaç değerin TRUE veya FALSE olduğuna ilişkin daha fazla ayrıntı elde etmek isteriz. Bu gereksinim bizi sayısal özetlere götürür.
12.4.2 Mantıksal vektörlerin sayısal özetleri
Mantıksal bir vektörü sayısal bağlamda kullandığınızda TRUE değeri 1’e, FALSE değeri ise 0’a dönüşür. Bu nedenle sum() ve mean() mantıksal vektörlerle son derece kullanışlıdır: sum(x), TRUE değerlerinin sayısını; mean(x) ise TRUE değerlerinin oranını verir (mean(), sum() sonucunun length() sonucuna bölünmesidir).
Örneğin bu özellik, kalkışta en fazla bir saat geciken uçuşların oranını ve varışta beş saat ya da daha fazla geciken uçuşların sayısını görmemizi sağlar:
flights |>
  group_by(year, month, day) |>
  summarize(
    proportion_delayed = mean(dep_delay <= 60, na.rm = TRUE),
    count_long_delay = sum(arr_delay >= 300, na.rm = TRUE),
    .groups = "drop"
  )
#> # A tibble: 365 × 5
#>    year month   day proportion_delayed count_long_delay
#>   <int> <int> <int>              <dbl>            <int>
#> 1  2013     1     1              0.939                3
#> 2  2013     1     2              0.914                3
#> 3  2013     1     3              0.941                0
#> 4  2013     1     4              0.953                0
#> 5  2013     1     5              0.964                1
#> 6  2013     1     6              0.959                0
#> # ℹ 359 more rows
12.4.3 Mantıksal alt kümeleme
Mantıksal vektörlerin özetlerde son bir kullanım alanı daha vardır: tek bir değişkeni ilgilendiğiniz alt kümeye indirgemek için mantıksal vektör kullanabilirsiniz. Bu işlem, Bölüm 27.2 bölümünde daha ayrıntılı öğreneceğiniz temel R’ın [ (“alt küme” diye okunur) operatöründen yararlanır.
Yalnızca gerçekten geciken uçuşların ortalama gecikmesini incelemek istediğimizi düşünün. Bunu yapmanın bir yolu, önce uçuşları filtrelemek ve ardından ortalama gecikmeyi hesaplamaktır:
flights |>
  filter(arr_delay > 0) |>
  group_by(year, month, day) |>
  summarize(
    behind = mean(arr_delay),
    n = n(),
    .groups = "drop"
  )
#> # A tibble: 365 × 5
#>    year month   day behind     n
#>   <int> <int> <int>  <dbl> <int>
#> 1  2013     1     1   32.5   461
#> 2  2013     1     2   32.0   535
#> 3  2013     1     3   27.7   460
#> 4  2013     1     4   28.3   297
#> 5  2013     1     5   22.6   238
#> 6  2013     1     6   24.4   381
#> # ℹ 359 more rows
Bu yöntem çalışır; peki erken varan uçuşların ortalama gecikmesini de hesaplamak istersek ne olur? Ayrı bir filtreleme adımı uygulamamız ve ardından iki veri çerçevesini nasıl birleştireceğimizi bulmamız gerekir3. Bunun yerine satır içinde filtreleme yapmak için [ operatörünü kullanabilirsiniz: arr_delay[arr_delay > 0] yalnızca pozitif varış gecikmelerini verir.
Böylece şu sonuca ulaşırız:
flights |>
  group_by(year, month, day) |>
  summarize(
    behind = mean(arr_delay[arr_delay > 0], na.rm = TRUE),
    ahead = mean(arr_delay[arr_delay < 0], na.rm = TRUE),
    n = n(),
    .groups = "drop"
  )
#> # A tibble: 365 × 6
#>    year month   day behind ahead     n
#>   <int> <int> <int>  <dbl> <dbl> <int>
#> 1  2013     1     1   32.5 -12.5   842
#> 2  2013     1     2   32.0 -14.3   943
#> 3  2013     1     3   27.7 -18.2   914
#> 4  2013     1     4   28.3 -17.0   915
#> 5  2013     1     5   22.6 -14.0   720
#> 6  2013     1     6   24.4 -13.6   832
#> # ℹ 359 more rows
Grup büyüklüğündeki farka da dikkat edin: ilk kod parçasında n() günlük geciken uçuş sayısını, ikinci kod parçasında ise toplam uçuş sayısını verir.
12.4.4 Alıştırmalar
12.5 Koşullu dönüştürmeler
Mantıksal vektörlerin en güçlü özelliklerinden biri, koşullu dönüştürmelerde kullanılabilmeleridir; başka bir deyişle x koşulunda bir, y koşulunda başka bir işlem yapabilirsiniz. Bunun için iki önemli araç vardır: if_else() ve case_when().
12.5.1 if_else()
Bir koşul TRUE olduğunda bir, FALSE olduğunda başka bir değer kullanmak istiyorsanız dplyr::if_else() fonksiyonundan yararlanabilirsiniz4. if_else() fonksiyonunun ilk üç argümanını her zaman kullanırsınız. İlk argüman olan condition bir mantıksal vektördür; ikinci argüman true, koşul doğru olduğunda; üçüncü argüman false ise koşul yanlış olduğunda döndürülecek çıktıyı belirtir.
Sayısal bir vektörün değerlerini “pozitif” veya “negatif” olarak etiketleyen basit bir örnekle başlayalım:
Girdi NA olduğunda kullanılacak isteğe bağlı dördüncü bir argüman daha vardır: missing.
if_else(x > 0, "pozitif", "negatif", "???")
#> [1] "negatif" "negatif" "negatif" "negatif" "pozitif" "pozitif" "pozitif"
#> [8] "???"
true ve false argümanlarında vektörler de kullanabilirsiniz. Örneğin bu özellik, abs() fonksiyonunun basit bir sürümünü oluşturmamızı sağlar:
if_else(x < 0, -x, x)
#> [1]  3  2  1  0  1  2  3 NA
Şimdiye kadar tüm argümanlarda aynı vektörleri kullandık; elbette farklı vektörleri de bir arada kullanabilirsiniz. Örneğin coalesce() fonksiyonunun basit bir sürümünü şöyle oluşturabilirsiniz:
Yukarıdaki etiketleme örneğinde küçük bir kusur fark etmiş olabilirsiniz: sıfır ne pozitif ne de negatiftir. Ek bir if_else() kullanarak bu sorunu çözebiliriz:
Bu ifade şimdiden biraz zor okunuyor; daha fazla koşul eklendiğinde ne kadar karmaşıklaşacağını tahmin edebilirsiniz. Bunun yerine dplyr::case_when() fonksiyonuna geçebilirsiniz.
12.5.2 case_when()
dplyr’ın case_when() fonksiyonu SQL’in CASE ifadesinden esinlenmiştir ve farklı koşullar için farklı hesaplamalar yapmanın esnek bir yolunu sunar. Ne yazık ki tidyverse içinde kullanacağınız başka hiçbir yapıya benzemeyen özel bir sözdizimi vardır. Fonksiyon, condition ~ output biçimindeki çiftleri alır. condition bir mantıksal vektör olmalıdır; değeri TRUE olduğunda output kullanılır.
Bu sayede önceki iç içe if_else() ifademizi şöyle yeniden oluşturabiliriz:
Bu sürüm daha fazla kod içerir; ancak ne yaptığı da daha açıktır.
case_when() fonksiyonunun nasıl çalıştığını açıklamak için daha basit birkaç durumu inceleyelim. Koşulların hiçbiri eşleşmezse çıktı NA olur:
case_when(
  x < 0 ~ "negatif",
  x > 0 ~ "pozitif"
)
#> [1] "negatif" "negatif" "negatif" NA        "pozitif" "pozitif" "pozitif"
#> [8] NA
Tüm diğer durumları kapsayan bir varsayılan değer oluşturmak için .default kullanın:
case_when(
  x < 0 ~ "negatif",
  x > 0 ~ "pozitif",
  .default = "???"
)
#> [1] "negatif" "negatif" "negatif" "???"     "pozitif" "pozitif" "pozitif"
#> [8] "???"
Birden fazla koşul eşleştiğinde yalnızca ilkinin kullanılacağına dikkat edin:
case_when(
  x > 0 ~ "pozitif",
  x > 2 ~ "büyük"
)
#> [1] NA        NA        NA        NA        "pozitif" "pozitif" "pozitif"
#> [8] NA
if_else() fonksiyonunda olduğu gibi ~ işaretinin iki yanında da değişkenler kullanabilir ve sorununuzun gerektirdiği biçimde farklı değişkenleri bir araya getirebilirsiniz. Örneğin varış gecikmesine kolay okunur etiketler vermek için case_when() kullanabiliriz:
flights |>
  mutate(
    status = case_when(
      is.na(arr_delay)      ~ "iptal edildi",
      arr_delay < -30       ~ "çok erken",
      arr_delay < -15       ~ "erken",
      abs(arr_delay) <= 15  ~ "zamanında",
      arr_delay < 60        ~ "geç",
      arr_delay < Inf       ~ "çok geç",
    ),
    .keep = "used"
  )
#> # A tibble: 336,776 × 2
#>   arr_delay status
#>       <dbl> <chr>
#> 1        11 zamanında
#> 2        20 geç
#> 3        33 geç
#> 4       -18 erken
#> 5       -25 erken
#> 6        12 zamanında
#> # ℹ 336,770 more rows
Bu tür karmaşık case_when() ifadeleri yazarken dikkatli olun. İlk iki denememde < ve > operatörlerini karıştırdığım için yanlışlıkla birbiriyle örtüşen koşullar oluşturdum.
12.5.3 Uyumlu türler
Hem if_else() hem de case_when() çıktılarının uyumlu türlerde olması gerektiğine dikkat edin. Türler uyumlu değilse aşağıdakilere benzer hatalar görürsünüz:
Genel olarak çok az tür birbiriyle uyumludur; çünkü bir vektör türünü otomatik olarak başka bir türe dönüştürmek yaygın bir hata kaynağıdır. En önemli uyumlu türler şunlardır:
- Bölüm 12.4.2 bölümünde ele aldığımız gibi sayısal ve mantıksal vektörler uyumludur.
- Karakter dizileri ve faktörler (Bölüm 16) uyumludur; çünkü faktörü, olası değerleri kısıtlanmış bir karakter dizisi olarak düşünebilirsiniz.
- Bölüm 17 bölümünde ele alacağımız tarihler ile tarih-saatler uyumludur; çünkü tarihi, tarih-saatin özel bir durumu olarak düşünebilirsiniz.
- Teknik olarak mantıksal bir vektör olan
NA, her şeyle uyumludur; çünkü her vektör türünün eksik değeri temsil etmenin bir yolu vardır.
Bu kuralları ezberlemenizi beklemiyoruz; ancak tidyverse’in her yerinde tutarlı biçimde uygulandıkları için zamanla doğal gelmeye başlayacaklardır.
12.5.4 Alıştırmalar
Bir sayı ikiye tam bölünüyorsa çifttir; R’da bunu
x %% 2 == 0ifadesiyle sınayabilirsiniz. Bu bilgiyi veif_else()fonksiyonunu kullanarak 0 ile 20 arasındaki her sayının tek mi çift mi olduğunu belirleyin.x <- c("Pazartesi", "Cumartesi", "Çarşamba")gibi gün adlarından oluşan bir vektör verildiğinde, günleri hafta sonu veya hafta içi olarak etiketlemek içinif_else()kullanın.xadlı sayısal bir vektörün mutlak değerini hesaplamak içinif_else()kullanın.ABD’deki bazı önemli tatilleri (örneğin Yılbaşı, 4 Temmuz, Şükran Günü ve Noel) etiketlemek üzere
flightsveri kümesininmonthvedaysütunlarını kullanan bircase_when()ifadesi yazın. ÖnceTRUEveyaFALSEdeğerlerinden oluşan mantıksal bir sütun, ardından tatilin adını ya daNAdeğerini içeren bir karakter sütunu oluşturun.
12.6 Özet
Mantıksal vektörün tanımı basittir; çünkü her değer TRUE, FALSE veya NA olmalıdır. Ancak mantıksal vektörler son derece güçlüdür. Bu bölümde >, <, <=, >=, ==, != ve is.na() ile mantıksal vektörler oluşturmayı; bunları !, & ve | ile birleştirmeyi; any(), all(), sum() ve mean() ile özetlemeyi öğrendiniz. Ayrıca mantıksal bir vektörün değerine bağlı olarak farklı sonuçlar döndürmenizi sağlayan güçlü if_else() ve case_when() fonksiyonlarını gördünüz.
İlerleyen bölümlerde mantıksal vektörlerle tekrar tekrar karşılaşacağız. Örneğin Bölüm 14 bölümünde, x içinde pattern ile eşleşen elemanlar için TRUE değerini içeren bir mantıksal vektör döndüren str_detect(x, pattern) fonksiyonunu öğreneceksiniz. Bölüm 17 bölümünde ise tarihleri ve saatleri karşılaştırarak mantıksal vektörler oluşturacaksınız. Şimdilik sıradaki önemli vektör türüne, sayısal vektörlere geçiyoruz.
R normalde
print()fonksiyonunu sizin için çağırır; başka bir deyişlex,print(x)için bir kısayoldur. Ancak ek argümanlar vermek istediğinizde fonksiyonu açıkça çağırmak yararlıdır.↩︎Başka bir deyişle x veya y doğruysa, ancak ikisi birden doğru değilse
xor(x, y)doğrudur. Günlük dilde “veya” sözcüğünü genellikle bu anlamda kullanırız. “Dondurma mı pasta mı istersiniz?” sorusunun yanıtı çoğunlukla “İkisini de” değildir.↩︎dplyr’ın
if_else()fonksiyonu, temel R’ınifelse()fonksiyonuna çok benzer.if_else()fonksiyonunun iki temel üstünlüğü vardır: eksik değerlere ne olacağını seçebilirsiniz ve değişkenleriniz uyumsuz türlerdeyse anlamlı bir hata alma olasılığınız çok daha yüksektir.↩︎