13 Sayılar
13.1 Giriş
Sayısal vektörler veri biliminin belkemiğidir ve kitabın önceki bölümlerinde onları birçok kez kullandınız. Şimdi R’da sayısal vektörlerle neler yapabileceğinizi sistematik biçimde inceleyerek gelecekte karşılaşacağınız sayısal sorunlar için sağlam bir temel oluşturma zamanı.
Karakter dizilerinden sayı üretmeye yarayan birkaç araçla başlayacak, ardından count() fonksiyonunu biraz daha ayrıntılı ele alacağız. Sonra mutate() ile iyi çalışan çeşitli sayısal dönüştürmeleri inceleyeceğiz. Bunların arasında başka vektör türlerine de uygulanabilen, ancak çoğunlukla sayısal vektörlerle kullanılan genel dönüştürmeler de yer alacak. Son olarak summarize() ile birlikte kullanılan özet fonksiyonlarını ele alacak ve bunların mutate() ile nasıl kullanılabileceğini göstereceğiz.
13.1.1 Ön koşullar
Bu bölümde çoğunlukla herhangi bir paket yüklemeden kullanılabilen temel R fonksiyonlarından yararlanacağız. Ancak bu fonksiyonları mutate() ve filter() gibi tidyverse fonksiyonlarının içinde kullanacağımız için tidyverse’e yine de ihtiyacımız var. Önceki bölümde olduğu gibi nycflights13 paketinden gerçek örneklerin yanı sıra c() ve tribble() ile oluşturulan küçük örnekleri kullanacağız.
13.2 Sayı oluşturma
Çoğu durumda sayılar, R’ın sayısal türlerinden biri olan integer veya double biçiminde kaydedilmiş olarak gelir. Ancak bazen sütun başlıklarını pivotlayarak oluşturduğunuz ya da veri içe aktarma sırasında bir sorun yaşandığı için sayılarla karakter dizisi biçiminde karşılaşabilirsiniz.
readr, karakter dizilerini sayıya ayrıştırmak için iki yararlı fonksiyon sunar: parse_double() ve parse_number(). Karakter dizisi biçiminde yazılmış sayılarınız varsa parse_double() kullanın:
x <- c("1.2", "5.6", "1e3")
parse_double(x)
#> [1]    1.2    5.6 1000.0
Karakter dizisi, yok saymak istediğiniz sayısal olmayan metinler içeriyorsa parse_number() kullanın. Bu fonksiyon özellikle para birimleri ve yüzdeler için yararlıdır:
x <- c("$1,234", "USD 3,513", "59%")
parse_number(x)
#> [1] 1234 3513   59
13.3 Sayımlar
Yalnızca sayımlar ve biraz temel aritmetikle ne kadar çok veri bilimi yapabileceğiniz şaşırtıcıdır. Bu nedenle dplyr, count() ile sayma işlemini olabildiğince kolaylaştırır. Bu fonksiyon analiz sırasında hızlı keşifler ve denetimler yapmak için idealdir:
flights |> count(dest)
#> # A tibble: 105 × 2
#>   dest      n
#>   <chr> <int>
#> 1 ABQ     254
#> 2 ACK     265
#> 3 ALB     439
#> 4 ANC       8
#> 5 ATL   17215
#> 6 AUS    2439
#> # ℹ 99 more rows(Bölüm 4 bölümündeki öneriye rağmen count() çağrısını genellikle tek satıra yazarız; çünkü çoğunlukla bir hesaplamanın beklendiği gibi çalıştığını konsolda hızla denetlemek için kullanılır.)
En yaygın değerleri görmek istiyorsanız sort = TRUE ekleyin:
flights |> count(dest, sort = TRUE)
#> # A tibble: 105 × 2
#>   dest      n
#>   <chr> <int>
#> 1 ORD   17283
#> 2 ATL   17215
#> 3 LAX   16174
#> 4 BOS   15508
#> 5 MCO   14082
#> 6 CLT   14064
#> # ℹ 99 more rows
Tüm değerleri görmek için |> View() veya |> print(n = Inf) kullanabileceğinizi unutmayın.
Aynı hesaplamayı group_by(), summarize() ve n() ile “elle” yapabilirsiniz. Bu yaklaşım başka özetleri de aynı anda hesaplamanızı sağladığı için kullanışlıdır:
n(), argüman almayan ve bunun yerine “geçerli” grup hakkındaki bilgilere erişen özel bir özet fonksiyonudur. Bu nedenle yalnızca dplyr fiillerinin içinde çalışır:
n()
#> Error in `n()`:
#> ! Must only be used inside data-masking verbs like `mutate()`,
#>   `filter()`, and `group_by()`.
n() ve count() fonksiyonlarının yararlı olabilecek birkaç çeşidi vardır:
-
n_distinct(x), bir veya daha fazla değişkendeki farklı (benzersiz) değerlerin sayısını hesaplar. Örneğin en fazla hava yolu şirketinin hizmet verdiği varış noktalarını bulabiliriz:flights |> group_by(dest) |> summarize(carriers = n_distinct(carrier)) |> arrange(desc(carriers)) #> # A tibble: 105 × 2 #> dest carriers #> <chr> <int> #> 1 ATL 7 #> 2 BOS 7 #> 3 CLT 7 #> 4 ORD 7 #> 5 TPA 7 #> 6 AUS 6 #> # ℹ 99 more rows -
Ağırlıklı sayım aslında bir toplamdır. Örneğin her uçağın uçtuğu mil sayısını “sayabilirsiniz”:
Ağırlıklı sayımlar sık kullanıldığı için
count()aynı işlemi yapan birwtargümanına sahiptir:flights |> count(tailnum, wt = distance) -
sum()veis.na()fonksiyonlarını birleştirerek eksik değerleri sayabilirsiniz.flightsveri kümesinde bu değerler iptal edilen uçuşları temsil eder:
13.3.1 Alıştırmalar
- Belirli bir değişkende eksik değer bulunan satırların sayısını
count()ile nasıl hesaplayabilirsiniz? - Aşağıdaki
count()çağrılarınıgroup_by(),summarize()vearrange()kullanacak biçimde genişletin:flights |> count(dest, sort = TRUE)flights |> count(tailnum, wt = distance)
13.4 Sayısal dönüştürmeler
Dönüştürme fonksiyonlarının çıktısı girdileriyle aynı uzunlukta olduğundan bu fonksiyonlar mutate() ile iyi çalışır. Dönüştürme fonksiyonlarının büyük çoğunluğu temel R’da yerleşik olarak bulunur. Hepsini listelemek kullanışlı olmayacağından bu bölümde en yararlı olanları göstereceğiz. Örneğin R aklınıza gelebilecek tüm trigonometrik fonksiyonları sunsa da veri biliminde nadiren gerektikleri için bunları burada listelemiyoruz.
13.4.1 Aritmetik ve geri dönüşüm kuralları
Aritmetiğin temellerini (+, -, *, /, ^) Bölüm 2 bölümünde tanıttık ve o zamandan beri birçok kez kullandık. Bu fonksiyonlar okulda öğrendiğiniz biçimde çalıştıkları için ayrıntılı açıklama gerektirmez. Ancak sol ve sağ tarafın uzunlukları farklı olduğunda ne olacağını belirleyen geri dönüşüm kurallarından (recycling rules) kısaca söz etmemiz gerekir. Örneğin flights |> mutate(air_time = air_time / 60) işleminde / işaretinin solunda 336.776, sağında ise yalnızca bir sayı bulunduğundan bu kurallar önemlidir.
R, kısa vektörü tekrarlayarak, yani geri dönüştürerek, eşleşmeyen uzunlukları ele alır. Bir veri çerçevesinin dışında birkaç vektör oluşturursak bu işlemi daha kolay görebiliriz:
Genellikle yalnızca tek sayıları, yani uzunluğu 1 olan vektörleri geri dönüştürmek istersiniz; ancak R daha kısa olan her vektörü geri dönüştürür. Uzun vektörün uzunluğu kısa vektörün uzunluğunun katı değilse R genellikle, ancak her zaman değil, bir uyarı verir:
Bu geri dönüşüm kuralları mantıksal karşılaştırmalara (==, <, <=, >, >=, !=) da uygulanır. Yanlışlıkla %in% yerine == kullanırsanız ve veri çerçevesinin satır sayısı talihsiz bir değerse şaşırtıcı sonuçlar ortaya çıkabilir. Örneğin Ocak ve Şubat aylarındaki tüm uçuşları bulmaya çalışan şu kodu ele alalım:
flights |>
  filter(month == c(1, 2))
#> # A tibble: 25,977 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      542            540         2      923            850
#> 3  2013     1     1      554            600        -6      812            837
#> 4  2013     1     1      555            600        -5      913            854
#> 5  2013     1     1      557            600        -3      838            846
#> 6  2013     1     1      558            600        -2      849            851
#> # ℹ 25,971 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Kod hata vermeden çalışır; ancak istediğiniz sonucu döndürmez. Geri dönüşüm kuralları nedeniyle tek numaralı satırlarda Ocak ayında, çift numaralı satırlarda ise Şubat ayında kalkan uçuşları bulur. Ne yazık ki flights çift sayıda satıra sahip olduğundan herhangi bir uyarı da verilmez.
Bu tür sessiz hatalardan korunmanız için çoğu tidyverse fonksiyonu, yalnızca tek değerleri geri dönüştüren daha katı kurallar kullanır. Ne yazık ki temel hesaplamayı filter() değil temel R operatörü == gerçekleştirdiğinden bu önlem burada ve benzer birçok durumda işe yaramaz.
13.4.2 En küçük ve en büyük değerler
Aritmetik fonksiyonlar değişken çiftleriyle çalışır. Bunlarla yakından ilişkili pmin() ve pmax() fonksiyonları, iki veya daha fazla değişken verildiğinde her satırdaki en küçük veya en büyük değeri döndürür:
Bu fonksiyonların, birden fazla gözlem alıp tek bir değer döndüren min() ve max() özet fonksiyonlarından farklı olduğuna dikkat edin. Tüm en küçük ve en büyük değerler aynı çıktığında yanlış fonksiyonu kullandığınızı anlayabilirsiniz:
13.4.3 Modüler aritmetik
Modüler aritmetik, ondalık sayıları öğrenmeden önce yaptığınız türden matematiğin teknik adıdır; yani bölümün tam sayı, kalanın ise ayrıca elde edildiği bölme işlemidir. R’da %/% tam sayı bölmesi yapar, %% ise kalanı hesaplar:
Modüler aritmetik flights veri kümesi için kullanışlıdır; çünkü sched_dep_time değişkenini hour ve minute bileşenlerine ayırmak için kullanabiliriz:
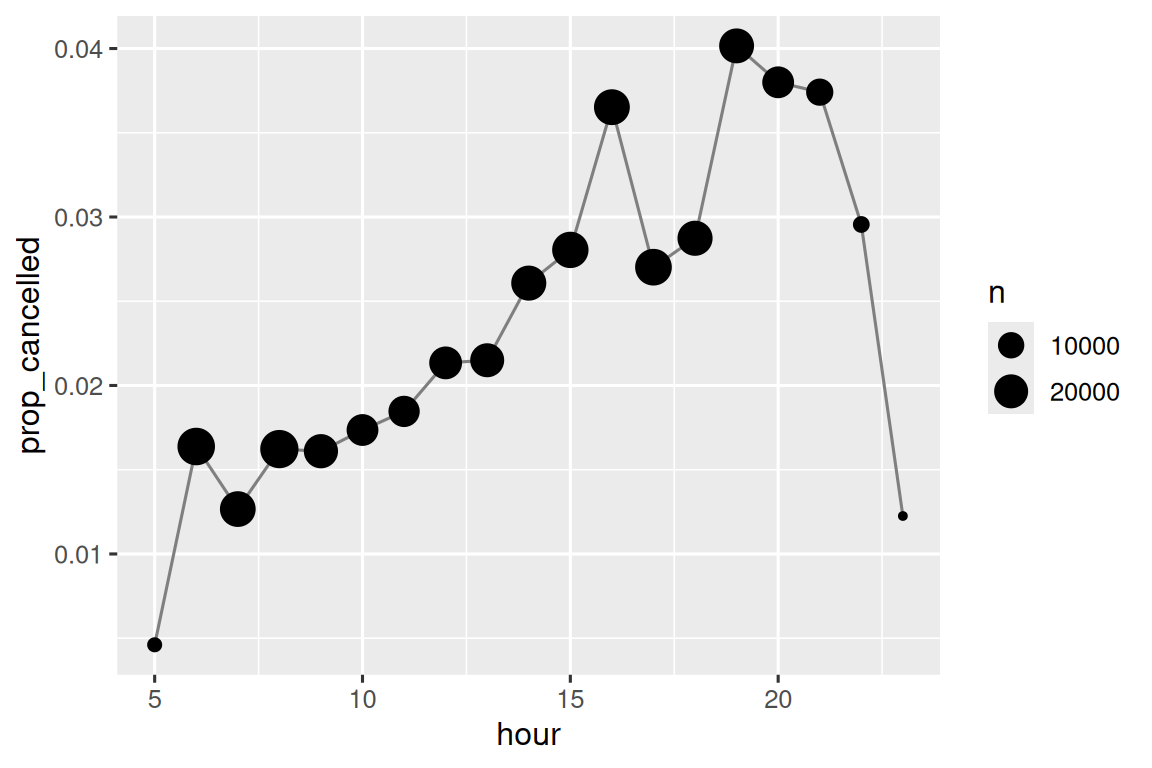
İptal edilen uçuşların oranının gün boyunca nasıl değiştiğini görmek için bunu Bölüm 12.4 bölümündeki mean(is.na(x)) yöntemiyle birleştirebiliriz. Sonuçlar Şekil 13.1 üzerinde gösterilmiştir.
13.4.4 Logaritmalar
Logaritmalar, birçok büyüklük mertebesine yayılan verilerle çalışmak ve üstel büyümeyi doğrusal büyümeye dönüştürmek için son derece yararlı bir dönüşümdür. R’da üç logaritma seçeneği vardır: log() (e tabanında doğal logaritma), log2() (2 tabanında) ve log10() (10 tabanında). log2() veya log10() kullanmanızı öneririz. Logaritmik ölçekte 1 birimlik fark özgün ölçekte iki katına, -1 birimlik fark ise yarıya karşılık geldiğinden log2() kolay yorumlanır. Öte yandan, örneğin 3 değeri 10^3 = 1000 olduğundan log10() ters dönüşümü kolaylaştırır. log() fonksiyonunun tersi exp() fonksiyonudur; log2() veya log10() fonksiyonunun tersini hesaplamak için 2^ ya da 10^ kullanmanız gerekir.
13.4.5 Yuvarlama
Bir sayıyı en yakın tam sayıya yuvarlamak için round(x) kullanın:
round(123.456)
#> [1] 123
Yuvarlama hassasiyetini ikinci argüman olan digits ile belirleyebilirsiniz. round(x, digits), en yakın 10^-n değerine yuvarlar; dolayısıyla digits = 2, en yakın 0,01’e yuvarlama yapar. Bu tanım, round(x, -3) ifadesinin en yakın binliğe yuvarlayacağını gösterir ve gerçekten de böyle çalışır:
round() fonksiyonunun ilk bakışta şaşırtıcı görünen bir özelliği vardır:
round(), “yarımı çifte yuvarlama” veya bankacı yuvarlaması olarak bilinen yöntemi kullanır: bir sayı iki tam sayının tam ortasındaysa çift tam sayıya yuvarlanır. Bu yöntem yuvarlamayı yansız tuttuğu için iyi bir stratejidir: 0,5 ile biten değerlerin yarısı yukarı, yarısı aşağı yuvarlanır.
round() fonksiyonuna, her zaman aşağı yuvarlayan floor() ve her zaman yukarı yuvarlayan ceiling() eşlik eder:
Bu fonksiyonlarda digits argümanı yoktur; bunun yerine değeri küçültüp yuvarladıktan sonra yeniden büyütebilirsiniz:
Başka bir sayının katına yuvarlamak istediğinizde de aynı yöntemi kullanabilirsiniz:
13.4.6 Sayıları aralıklara ayırma
Sayısal bir vektörü kesikli aralıklara ayırmak (binning) için cut()1 kullanın:
Kesme noktalarının eşit aralıklı olması gerekmez:
İsterseniz kendi labels değerlerinizi belirtebilirsiniz. labels sayısının breaks sayısından bir eksik olması gerektiğine dikkat edin.
Kesme noktalarının belirlediği aralığın dışında kalan değerler NA olur:
Aralıkların [a, b) mı yoksa (a, b] mi olacağını ve en düşük aralığın [a, b] biçiminde kapsanıp kapsanmayacağını belirleyen right ve include.lowest gibi diğer yararlı argümanlar için belgelere bakın.
13.4.7 Birikimli ve hareketli toplulaştırmalar
Temel R; hareketli veya birikimli toplam, çarpım, en küçük ve en büyük değerler için cumsum(), cumprod(), cummin() ve cummax() fonksiyonlarını sunar. dplyr ise birikimli ortalamalar için cummean() sağlar. Uygulamada en sık birikimli toplamlarla karşılaşılır:
x <- 1:10
cumsum(x)
#>  [1]  1  3  6 10 15 21 28 36 45 55
Daha karmaşık hareketli veya kayan toplulaştırmalara ihtiyacınız varsa slider paketini deneyin.
13.4.8 Alıştırmalar
Şekil 13.1 grafiğini oluşturmak için kullanılan kodun her satırının ne yaptığını sözcüklerle açıklayın.
R hangi trigonometrik fonksiyonları sunar? Bazı adları tahmin edin ve belgelerde arayın. Bu fonksiyonlar derece mi yoksa radyan mı kullanır?
-
Şu anda
dep_timevesched_dep_timedeğişkenlerini okumak kolay, ancak gerçekte sürekli sayılar olmadıkları için bunlarla hesaplama yapmak zordur. Aşağıdaki kodu çalıştırdığınızda temel sorunu görebilirsiniz: her saat arasında bir boşluk vardır.flights |> filter(month == 1, day == 1) |> ggplot(aes(x = sched_dep_time, y = dep_delay)) + geom_point()Bunları zamanı daha doğru temsil eden bir biçime dönüştürün: kesirli saatler veya gece yarısından itibaren geçen dakikalar.
dep_timevearr_timedeğerlerini en yakın beş dakikaya yuvarlayın.
13.5 Genel dönüştürmeler
Aşağıdaki bölümlerde çoğunlukla sayısal vektörlerle kullanılan, ancak diğer tüm sütun türlerine de uygulanabilen bazı genel dönüştürmeleri ele alacağız.
13.5.1 Sıralar
dplyr, SQL’den esinlenen çeşitli sıralama fonksiyonları sunar; ancak işe her zaman dplyr::min_rank() ile başlamalısınız. Bu fonksiyon eşitlikleri ele almak için yaygın yöntemi kullanır: örneğin 1., 2., 2., 4.
En küçük değerlerin en düşük sıra numaralarını aldığına dikkat edin. En büyük değerlere en düşük sıra numaralarını vermek için desc(x) kullanın:
min_rank() ihtiyacınızı karşılamıyorsa dplyr::row_number(), dplyr::dense_rank(), dplyr::percent_rank() ve dplyr::cume_dist() çeşitlerini inceleyin. Ayrıntılar için belgelere bakın.
df <- tibble(x = x)
df |>
  mutate(
    row_number = row_number(x),
    dense_rank = dense_rank(x),
    percent_rank = percent_rank(x),
    cume_dist = cume_dist(x)
  )
#> # A tibble: 6 × 5
#>       x row_number dense_rank percent_rank cume_dist
#>   <dbl>      <int>      <int>        <dbl>     <dbl>
#> 1     1          1          1         0          0.2
#> 2     5          2          2         0.25       0.6
#> 3     5          3          2         0.25       0.6
#> 4    17          4          3         0.75       0.8
#> 5    22          5          4         1          1
#> 6    NA         NA         NA        NA         NA
Temel R’ın rank() fonksiyonunda uygun ties.method argümanını seçerek aynı sonuçların çoğunu elde edebilirsiniz. NA değerlerini NA olarak korumak için büyük olasılıkla na.last = "keep" de kullanmak isteyeceksiniz.
row_number(), bir dplyr fiilinin içinde argümansız da kullanılabilir. Bu durumda “geçerli” satırın numarasını verir. %% veya %/% ile birleştirildiğinde verileri benzer büyüklükte gruplara ayırmak için kullanışlı bir araç olur:
df <- tibble(id = 1:10)

df |>
  mutate(
    row0 = row_number() - 1,
    three_groups = row0 %% 3,
    three_in_each_group = row0 %/% 3
  )
#> # A tibble: 10 × 4
#>      id  row0 three_groups three_in_each_group
#>   <int> <dbl>        <dbl>               <dbl>
#> 1     1     0            0                   0
#> 2     2     1            1                   0
#> 3     3     2            2                   0
#> 4     4     3            0                   1
#> 5     5     4            1                   1
#> 6     6     5            2                   1
#> # ℹ 4 more rows
13.5.2 Kaydırmalar
dplyr::lead() ve dplyr::lag(), “geçerli” değerin hemen öncesindeki veya sonrasındaki değerlere başvurmanızı sağlar. Girdiyle aynı uzunlukta, başına veya sonuna NA değerleri eklenmiş bir vektör döndürürler:
-
x - lag(x), geçerli değer ile önceki değer arasındaki farkı verir.x - lag(x) #> [1] NA 3 6 0 8 16 -
x == lag(x), geçerli değerin ne zaman değiştiğini gösterir.x == lag(x) #> [1] NA FALSE FALSE TRUE FALSE FALSE
İkinci argüman olan n ile birden fazla konum ileri veya geri gidebilirsiniz.
13.5.3 Ardışık tanımlayıcılar
Bazen belirli bir olay her gerçekleştiğinde yeni bir grup başlatmak istersiniz. Örneğin web sitesi verilerini incelerken olayları oturumlara ayırmak ve son etkinliğin üzerinden x dakikadan fazla zaman geçtiğinde yeni bir oturum başlatmak yaygın bir gereksinimdir. Bir kişinin web sitesini ziyaret ettiği zamanlara sahip olduğunuzu düşünün:
Her olay arasındaki süreyi hesapladığınızı ve yeni bir grup oluşturacak kadar büyük bir boşluk bulunup bulunmadığını belirlediğinizi varsayalım:
Peki bu mantıksal vektörü group_by() ile kullanabileceğimiz bir değere nasıl dönüştürebiliriz? Bölüm 13.4.7 bölümündeki cumsum() yardımımıza yetişir: bir boşluk olduğunda, yani has_gap değeri TRUE olduğunda group değeri bir artar (Bölüm 12.4.2):
Gruplama değişkenleri oluşturmanın başka bir yolu, argümanlarından biri her değiştiğinde yeni bir grup başlatan consecutive_id() fonksiyonudur. Örneğin bu Stack Overflow sorusundan esinlenerek çok sayıda yinelenen değer içeren bir veri çerçeveniz olduğunu düşünün:
Yinelenen her x grubunun ilk satırını korumak için group_by(), consecutive_id() ve slice_head() kullanabilirsiniz:
df |>
  group_by(id = consecutive_id(x)) |>
  slice_head(n = 1)
#> # A tibble: 7 × 3
#> # Groups:   id [7]
#>   x         y    id
#>   <chr> <dbl> <int>
#> 1 a         1     1
#> 2 b         2     2
#> 3 c         4     3
#> 4 d         3     4
#> 5 e         9     5
#> 6 a         4     6
#> # ℹ 1 more row
13.5.4 Alıştırmalar
Bir sıralama fonksiyonu kullanarak en çok geciken 10 uçuşu bulun. Eşitlikleri nasıl ele almak istiyorsunuz?
min_rank()belgelerini dikkatle okuyun.Zamanında kalkış/varış performansı en kötü olan uçak (
tailnum) hangisidir?Gecikmelerden olabildiğince kaçınmak istiyorsanız günün hangi saatinde uçmalısınız?
flights |> group_by(dest) |> filter(row_number() < 4)ne yapar? Pekiflights |> group_by(dest) |> filter(row_number(dep_delay) < 4)ne yapar?Her varış noktası için toplam gecikme süresini dakika cinsinden hesaplayın. Her uçuşun, varış noktasına ait toplam gecikmedeki payını hesaplayın.
-
Gecikmeler genellikle zaman içinde ilişkilidir: ilk gecikmeye neden olan sorun çözüldükten sonra bile önceki uçuşların kalkabilmesi için sonraki uçuşlar gecikir.
lag()kullanarak bir saatteki ortalama uçuş gecikmesinin önceki saatin ortalama gecikmesiyle nasıl ilişkili olduğunu araştırın. Her varış noktasını inceleyin. Kuşkulu derecede hızlı, yani olası bir veri girişi hatasını temsil eden uçuşlar bulabilir misiniz? Bir uçuşun havada geçirdiği süreyi, o varış noktasına yapılan en kısa uçuşa göre hesaplayın. Havada en çok geciken uçuşlar hangileridir?
En az iki hava yolu şirketinin uçtuğu tüm varış noktalarını bulun. Aynı varış noktasındaki performanslarına göre hava yolu şirketlerinin göreli bir sıralamasını oluşturmak için bu varış noktalarını kullanın.
13.6 Sayısal özetler
Şimdiye kadar tanıttığımız sayım, ortalama ve toplamları kullanmak bile sizi oldukça ileri götürür; ancak R başka birçok yararlı özet fonksiyonu da sunar. Aşağıda yararlı bulabileceğiniz bazılarını seçtik.
13.6.1 Merkez
Şimdiye kadar bir değer vektörünün merkezini özetlemek için çoğunlukla mean() kullandık. Bölüm 3.6 bölümünde gördüğümüz gibi ortalama, toplamın gözlem sayısına bölünmesiyle hesaplandığından yalnızca birkaç olağandışı yüksek veya düşük değere bile duyarlıdır. Bir alternatif, vektörün “ortasında” bulunan değeri, yani değerlerin %50’sinin üstünde ve %50’sinin altında kaldığı değeri bulan median() fonksiyonudur. İlgilendiğiniz değişkenin dağılımına bağlı olarak ortalama veya medyan daha iyi bir merkez ölçüsü olabilir. Örneğin simetrik dağılımlarda genellikle ortalamayı, çarpık dağılımlarda ise medyanı bildiririz.
Şekil 13.2, her varış noktası için ortalama ve medyan kalkış gecikmesini dakika cinsinden karşılaştırır. Uçuşlar bazen saatlerce geç kalkar, ancak hiçbir zaman saatlerce erken kalkmaz; bu nedenle medyan gecikme her zaman ortalama gecikmeden küçüktür.
flights |>
  group_by(year, month, day) |>
  summarize(
    mean = mean(dep_delay, na.rm = TRUE),
    median = median(dep_delay, na.rm = TRUE),
    n = n(),
    .groups = "drop"
  ) |>
  ggplot(aes(x = mean, y = median)) +
  geom_abline(slope = 1, intercept = 0, color = "white", linewidth = 2) +
  geom_point()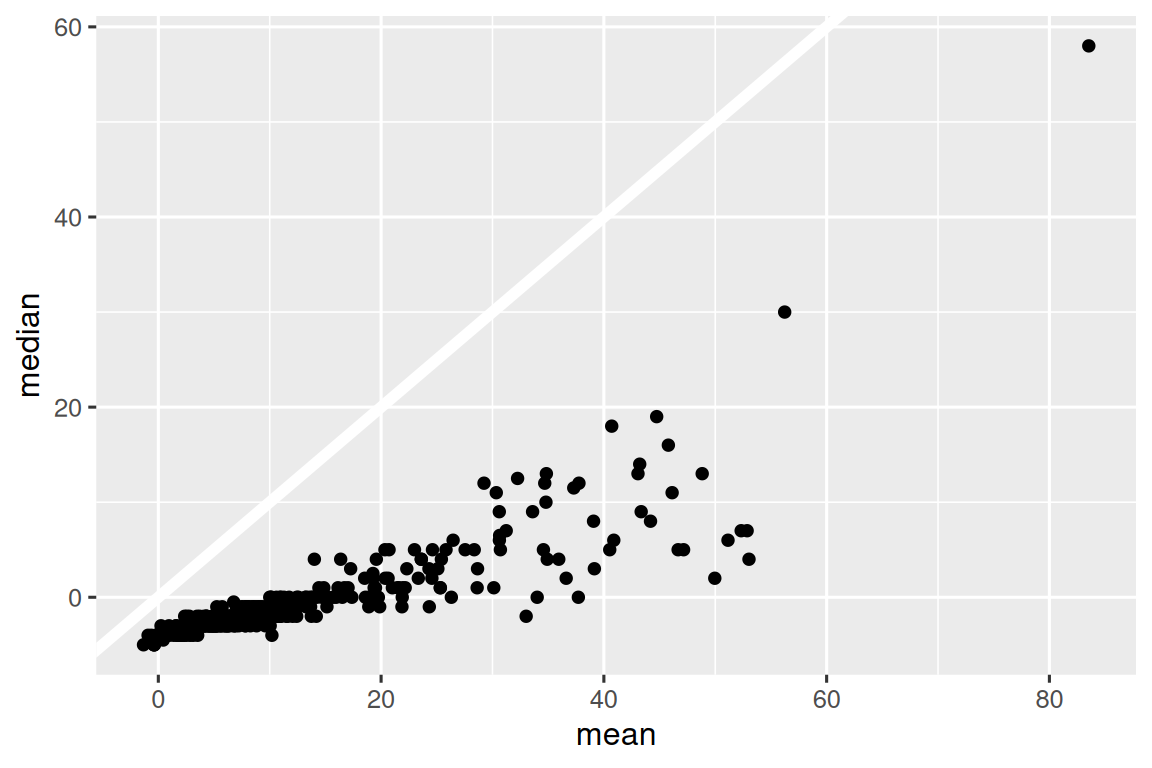
En sık görülen değer olan modu da merak edebilirsiniz. Bu özet yalnızca çok basit durumlarda iyi çalışır; lisede öğrenmiş olmanızın nedeni de budur. Pek çok gerçek veri kümesinde ise iyi sonuç vermez. Veri kesikliyse birden fazla en sık değer olabilir; sürekliyse her değer az da olsa farklı olduğundan en sık değer hiç olmayabilir. Bu nedenlerle istatistikçiler modu pek kullanmaz ve temel R’da modu hesaplayan bir fonksiyon bulunmaz2.
13.6.2 En küçük, en büyük değerler ve kantiller
Merkez dışındaki konumlarla ilgileniyorsanız ne yapabilirsiniz? min() ve max() size en küçük ve en büyük değerleri verir. Bir başka güçlü araç, medyanın genelleştirilmiş biçimi olan quantile() fonksiyonudur: quantile(x, 0.25), x içindeki değerlerin %25’inden büyük olan değeri bulur; quantile(x, 0.5) medyana eşdeğerdir; quantile(x, 0.95) ise değerlerin %95’inden büyük olan değeri bulur.
flights verisinde en büyük değer yerine gecikmelerin %95’lik kantiline bakmak isteyebilirsiniz; çünkü bu ölçü, oldukça uç olabilen en gecikmiş %5’lik uçuşları yok sayar.
flights |>
  group_by(year, month, day) |>
  summarize(
    max = max(dep_delay, na.rm = TRUE),
    q95 = quantile(dep_delay, 0.95, na.rm = TRUE),
    .groups = "drop"
  )
#> # A tibble: 365 × 5
#>    year month   day   max   q95
#>   <int> <int> <int> <dbl> <dbl>
#> 1  2013     1     1   853  70.1
#> 2  2013     1     2   379  85
#> 3  2013     1     3   291  68
#> 4  2013     1     4   288  60
#> 5  2013     1     5   327  41
#> 6  2013     1     6   202  51
#> # ℹ 359 more rows
13.6.3 Yayılım
Bazen verilerin büyük bölümünün nerede bulunduğundan çok ne kadar yayıldığıyla ilgilenirsiniz. Yaygın kullanılan iki özet, standart sapma sd(x) ve çeyrekler arası aralık IQR() fonksiyonudur. Muhtemelen zaten bildiğiniz için sd() fonksiyonunu burada açıklamayacağız; ancak IQR() sizin için yeni olabilir. quantile(x, 0.75) - quantile(x, 0.25) olarak hesaplanır ve verilerin ortadaki %50’sini içeren aralığı verir.
Bu ölçüyü flights verisindeki küçük bir tuhaflığı ortaya çıkarmak için kullanabiliriz. Havalimanları her zaman aynı yerde olduğundan kalkış ve varış noktaları arasındaki mesafenin yayılımının sıfır olmasını bekleyebilirsiniz. Ancak aşağıdaki kod EGE Havalimanı için verideki bir tuhaflığı ortaya çıkarır:
13.6.4 Dağılımlar
Yukarıda açıklanan tüm özet istatistiklerinin dağılımı tek bir sayıya indirgediğini unutmamak gerekir. Bu nedenle özünde bilgi kaybettirirler ve yanlış özeti seçerseniz gruplar arasındaki önemli farkları kolayca gözden kaçırabilirsiniz. Bu yüzden özet istatistiklerinize karar vermeden önce dağılımı görselleştirmek her zaman iyi bir fikirdir.
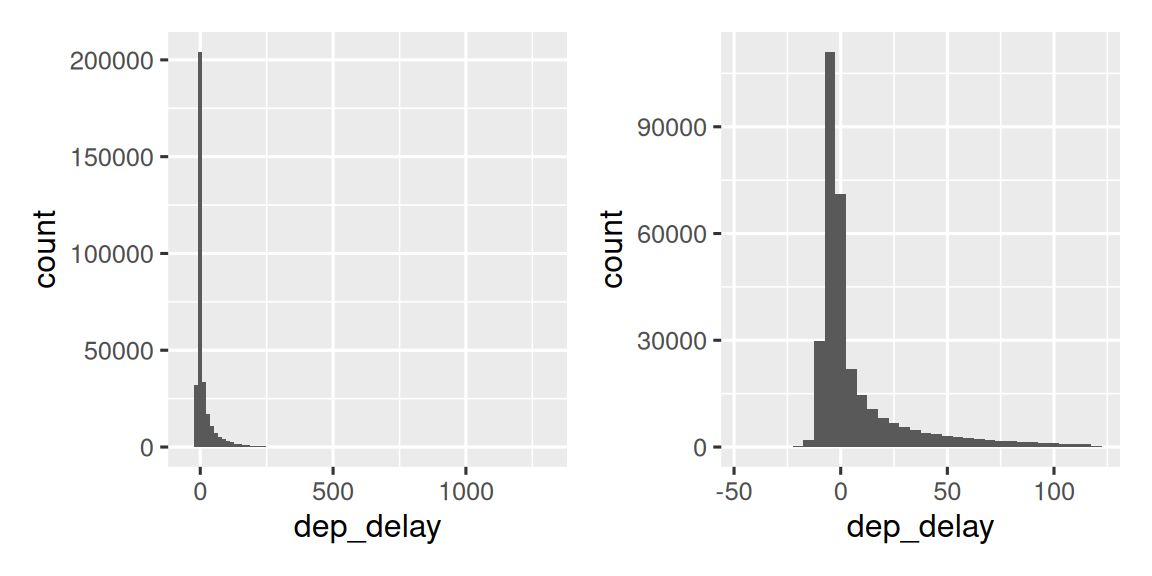
Şekil 13.3, kalkış gecikmelerinin genel dağılımını gösterir. Dağılım o kadar çarpıktır ki verilerin büyük bölümünü görebilmek için yakınlaştırmamız gerekir. Bu durum, ortalamanın iyi bir özet olma olasılığının düşük olduğunu ve bunun yerine medyanı tercih edebileceğimizi düşündürür.
Alt grupların dağılımlarının bütünün dağılımına benzeyip benzemediğini denetlemek de iyi bir fikirdir. Aşağıdaki grafikte her gün için bir tane olmak üzere 365 dep_delay frekans poligonu üst üste çizilmiştir. Dağılımlar ortak bir örüntü izliyor gibi görünür; bu da her gün için aynı özeti kullanmanın uygun olduğunu düşündürür.
flights |>
  filter(dep_delay < 120) |>
  ggplot(aes(x = dep_delay, group = interaction(day, month))) +
  geom_freqpoly(binwidth = 5, alpha = 1/5)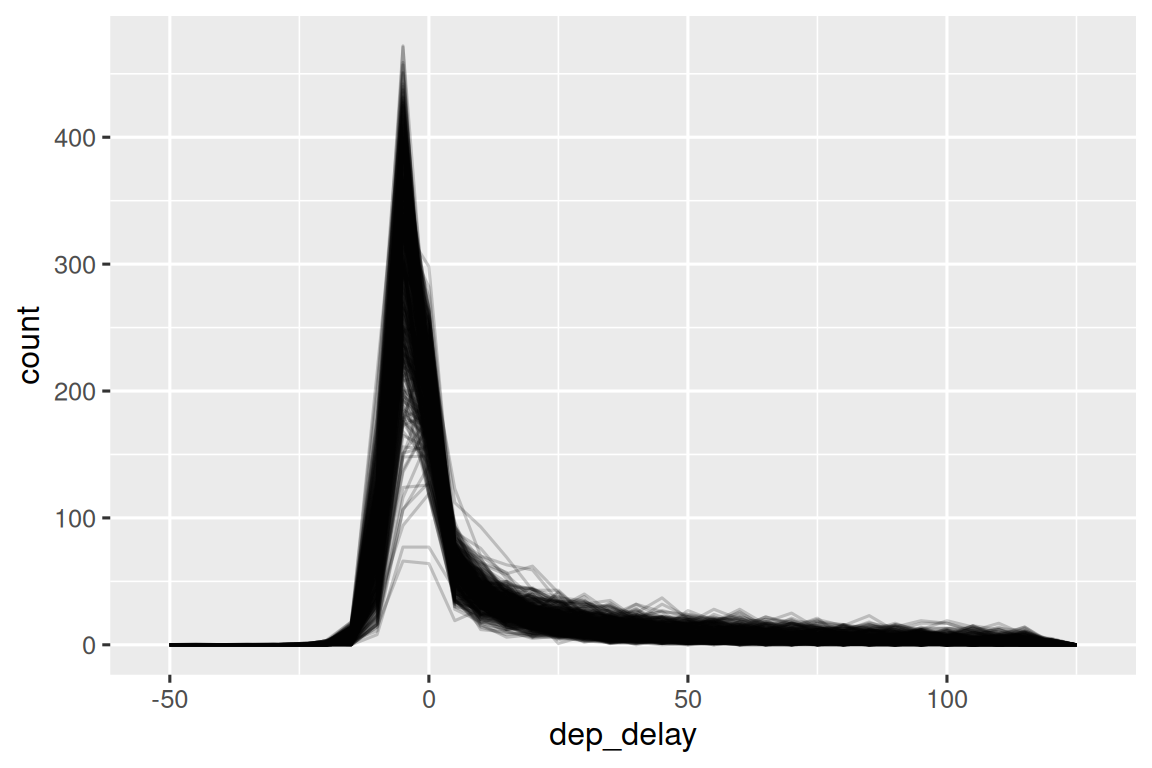
Çalıştığınız verilere özel özetler geliştirmekten çekinmeyin. Bu örnekte erken ve geç kalkan uçuşları ayrı ayrı özetleyebilir veya değerler son derece çarpık olduğundan logaritmik dönüşüm deneyebilirsiniz. Son olarak Bölüm 3.6 bölümünde öğrendiklerinizi unutmayın: sayısal özetler oluştururken her gruptaki gözlem sayısını eklemek iyi bir fikirdir.
13.6.5 Konumlar
Sayısal vektörler için yararlı olan, ancak diğer tüm değer türleriyle de çalışan son bir özet türü vardır: belirli bir konumdaki değeri first(x), last(x) ve nth(x, n) ile çıkarmak.
Örneğin her günün ilk, beşinci ve son kalkışını bulabiliriz:
flights |>
  group_by(year, month, day) |>
  summarize(
    first_dep = first(dep_time, na_rm = TRUE),
    fifth_dep = nth(dep_time, 5, na_rm = TRUE),
    last_dep = last(dep_time, na_rm = TRUE)
  )
#> `summarise()` has regrouped the output.
#> ℹ Summaries were computed grouped by year, month, and day.
#> ℹ Output is grouped by year and month.
#> ℹ Use `summarise(.groups = "drop_last")` to silence this message.
#> ℹ Use `summarise(.by = c(year, month, day))` for per-operation grouping
#>   (`?dplyr::dplyr_by`) instead.
#> # A tibble: 365 × 6
#> # Groups:   year, month [12]
#>    year month   day first_dep fifth_dep last_dep
#>   <int> <int> <int>     <int>     <int>    <int>
#> 1  2013     1     1       517       554     2356
#> 2  2013     1     2        42       535     2354
#> 3  2013     1     3        32       520     2349
#> 4  2013     1     4        25       531     2358
#> 5  2013     1     5        14       534     2357
#> 6  2013     1     6        16       555     2355
#> # ℹ 359 more rows
(Not: dplyr fonksiyonları, fonksiyon ve argüman adlarının bileşenlerini ayırmak için _ kullandığından bu fonksiyonlarda na.rm yerine na_rm kullanılır.)
Bölüm 27.2 bölümünde yeniden ele alacağımız [ operatörünü biliyorsanız bu fonksiyonlara gerçekten ihtiyaç olup olmadığını merak edebilirsiniz. Bunları kullanmanın üç nedeni vardır: belirtilen konum yoksa default ile varsayılan bir değer verebilir, order_by ile satır sırasını yerel olarak değiştirebilir ve na_rm ile eksik değerleri kaldırabilirsiniz.
Belirli konumlardaki değerleri çıkarmak, sıralara göre filtrelemeyi tamamlayan bir yöntemdir. Filtreleme, her gözlem ayrı bir satırda olmak üzere tüm değişkenleri verir:
flights |>
  group_by(year, month, day) |>
  mutate(r = min_rank(sched_dep_time)) |>
  filter(r %in% c(1, max(r)))
#> # A tibble: 1,195 × 20
#> # Groups:   year, month, day [365]
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1     2353           2359        -6      425            445
#> 3  2013     1     1     2353           2359        -6      418            442
#> 4  2013     1     1     2356           2359        -3      425            437
#> 5  2013     1     2       42           2359        43      518            442
#> 6  2013     1     2      458            500        -2      703            650
#> # ℹ 1,189 more rows
#> # ℹ 12 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
13.6.6 mutate() ile kullanım
Adlarından anlaşılacağı gibi özet fonksiyonları genellikle summarize() ile birlikte kullanılır. Ancak Bölüm 13.4.1 bölümünde ele aldığımız geri dönüşüm kuralları sayesinde, özellikle grup içinde bir tür standartlaştırma yapmak istediğinizde mutate() ile de yararlı biçimde kullanılabilirler. Örneğin:
-
x / sum(x), toplam içindeki oranı hesaplar. -
(x - mean(x)) / sd(x), Z puanını hesaplar; ortalamayı 0, standart sapmayı 1 olacak biçimde standartlaştırır. -
(x - min(x)) / (max(x) - min(x)), değerleri [0, 1] aralığına standartlaştırır. -
x / first(x), ilk gözleme dayalı bir endeks hesaplar.
13.6.7 Alıştırmalar
Bir uçuş grubunun tipik gecikme özelliklerini değerlendirmek için en az beş farklı yöntem düşünün.
mean()ne zaman yararlıdır?median()ne zaman yararlıdır? Ne zaman başka bir ölçü kullanmak isteyebilirsiniz? Varış gecikmesini mi yoksa kalkış gecikmesini mi kullanmalısınız?planesverisinden neden yararlanmak isteyebilirsiniz?Hava hızında en büyük değişkenliği hangi varış noktaları gösterir?
EGE’nin macerasını daha ayrıntılı araştırmak için bir grafik oluşturun. Havalimanının konum değiştirdiğine ilişkin bir kanıt bulabilir misiniz? Farkı açıklayabilecek başka bir değişken bulabilir misiniz?
13.7 Özet
Sayılarla çalışmaya yönelik birçok aracı zaten biliyordunuz; bu bölümü okuduktan sonra artık bunları R’da nasıl kullanacağınızı da biliyorsunuz. Ayrıca sıralar ve kaydırmalar gibi çoğunlukla, ancak yalnızca değil, sayısal vektörlere uygulanan bazı yararlı genel dönüştürmeleri öğrendiniz. Son olarak çeşitli sayısal özetleri incelediniz ve göz önünde bulundurmanız gereken bazı istatistiksel güçlükleri ele aldınız.
Sonraki iki bölümde stringr paketiyle karakter dizileri üzerinde çalışmayı derinlemesine inceleyeceğiz. Karakter dizileri geniş bir konu olduğu için iki bölüme ayrılmıştır: biri karakter dizilerinin temellerini, diğeri düzenli ifadeleri ele alır.
ggplot2, yaygın durumlar için
cut_interval(),cut_number()vecut_width()yardımcılarını sunar. Bu fonksiyonların ggplot2 içinde bulunması kuşkusuz biraz tuhaftır; ancak histogram hesaplamalarında kullanışlıdırlar ve tidyverse’in diğer bileşenlerinden önce yazılmışlardır.↩︎