26 İterasyon
26.1 Giriş
Bu bölümde aynı işlemi farklı nesneler üzerinde tekrar tekrar gerçekleştirmeyi sağlayan iterasyon araçlarını öğreneceksiniz. R’da iterasyon genellikle diğer programlama dillerinden oldukça farklı görünür; çünkü büyük bir bölümü örtüktür ve kendiliğinden gerçekleşir. Örneğin R’da sayısal bir x vektörünü iki katına çıkarmak isterseniz yalnızca 2 * x yazabilirsiniz. Diğer dillerin çoğunda bir tür for döngüsü kullanarak x içindeki her öğeyi açıkça iki katına çıkarmanız gerekir.
Bu kitap size aynı işlemi birden çok “şey” için gerçekleştiren az sayıda ancak güçlü araç sundu:
-
facet_wrap()vefacet_grid()her alt küme için bir grafik çizer. -
group_by()ilesummarize()her alt küme için özet istatistikleri hesaplar. -
unnest_wider()veunnest_longer()liste sütununun her öğesi için yeni satırlar ve sütunlar oluşturur.
Artık başka fonksiyonları girdi olarak alan fonksiyonların çevresinde kurulduğu için genellikle fonksiyonel programlama araçları denen daha genel araçları öğrenme zamanı. Fonksiyonel programlamayı öğrenmek kolayca soyut bir yöne kayabilir; ancak bu bölümde üç yaygın göreve odaklanarak konuyu somut tutacağız: birden çok sütunu değiştirme, birden çok dosyayı okuma ve birden çok nesneyi kaydetme.
26.1.1 Ön koşullar
Bu bölümde tidyverse’in temel üyeleri olan dplyr ve purrr’ın sağladığı araçlara odaklanacağız. dplyr’ı daha önce gördünüz, ancak purrr yeni. Bu bölümde yalnızca birkaç purrr fonksiyonu kullanacağız; yine de programlama becerilerinizi geliştirirken keşfetmeye değer harika bir pakettir.
26.2 Birden çok sütunu değiştirme
Aşağıdaki basit tibble’a sahip olduğunuzu, gözlem sayısını ve her sütunun medyanını hesaplamak istediğinizi düşünün.
Bunu kopyala-yapıştır ile yapabilirsiniz:
Bu, hiçbir şeyi ikiden fazla kez kopyalayıp yapıştırmama genel kuralımızı çiğner; onlarca, hatta yüzlerce sütununuz varsa işlemin çok zahmetli olacağını tahmin edebilirsiniz. Bunun yerine across() kullanabilirsiniz:
across() fonksiyonunun aşağıdaki kısımlarda ayrıntılı olarak ele alacağımız özellikle önemli üç argümanı vardır. across() fonksiyonunu her kullandığınızda ilk ikisini kullanırsınız: İlk argüman .cols, hangi sütunlar üzerinde iterasyon yapmak istediğinizi; ikinci argüman .fns ise her sütunla ne yapılacağını belirtir. Özellikle across() fonksiyonunu mutate() ile kullandığınızda önemli olan çıktı sütunu adları üzerinde ek denetime ihtiyaç duyarsanız .names argümanını kullanabilirsiniz. Ayrıca filter() ile çalışan iki önemli çeşidi, if_any() ve if_all() fonksiyonlarını ele alacağız.
26.2.1 .cols ile sütun seçme
across() fonksiyonunun ilk argümanı .cols, dönüştürülecek sütunları seçer. Bu argüman select() ile aynı belirtimleri kullanır (Bölüm 3.3.2); dolayısıyla sütunları adlarına göre seçmek için starts_with() ve ends_with() gibi fonksiyonlardan yararlanabilirsiniz.
across() için özellikle kullanışlı iki ek seçim tekniği vardır: everything() ve where(). everything() doğrudandır: Gruplama sütunları dışındaki tüm sütunları seçer:
set.seed(1014)
df <- tibble(
  grp = sample(2, 10, replace = TRUE),
  a = rnorm(10),
  b = rnorm(10),
  c = rnorm(10),
  d = rnorm(10)
)

df |>
  group_by(grp) |>
  summarize(across(everything(), median))
#> # A tibble: 2 × 5
#>     grp      a      b       c       d
#>   <int>  <dbl>  <dbl>   <dbl>   <dbl>
#> 1     1 -0.244 -0.522 -0.0974 -0.251
#> 2     2 -0.247  0.468  0.112   0.0700
Gruplama sütunlarının (burada grp) across() içine dahil edilmediğine dikkat edin; çünkü summarize() bunları otomatik olarak korur.
where() sütunları türlerine göre seçmenizi sağlar:
-
where(is.numeric)tüm sayısal sütunları seçer. -
where(is.character)tüm karakter dizisi sütunlarını seçer. -
where(is.Date)tüm tarih sütunlarını seçer. -
where(is.POSIXct)tüm tarih-saat sütunlarını seçer. -
where(is.logical)tüm mantıksal sütunları seçer.
Diğer seçicilerde olduğu gibi bunları Boole cebiriyle birleştirebilirsiniz. Örneğin !where(is.numeric) sayısal olmayan tüm sütunları, starts_with("a") & where(is.logical) ise adı “a” ile başlayan tüm mantıksal sütunları seçer.
26.2.2 Tek bir fonksiyon çağırma
across() fonksiyonunun ikinci argümanı her sütunun nasıl dönüştürüleceğini tanımlar. Yukarıdaki gibi basit durumlarda bu, var olan tek bir fonksiyon olur. Bu, R’ın oldukça özel bir özelliğidir: Bir fonksiyonu (median, mean, str_flatten, …) başka bir fonksiyona (across) aktarırız. R’ı fonksiyonel bir programlama dili yapan özelliklerden biri budur.
Bu fonksiyonu kendimiz çağırmadığımızı, across() çağırabilsin diye ona aktardığımızı unutmamak önemlidir. Bu nedenle fonksiyon adının ardından hiçbir zaman () gelmemelidir. Unutursanız hata alırsınız:
df |>
  group_by(grp) |>
  summarize(across(everything(), median()))
#> Error in `summarize()`:
#> ℹ In argument: `across(everything(), median())`.
#> Caused by error in `median.default()`:
#> ! argument "x" is missing, with no default
Bu hata fonksiyonu girdisiz çağırdığınız için oluşur; örneğin:
median()
#> Error in `median.default()`:
#> ! argument "x" is missing, with no default
26.2.3 Birden çok fonksiyon çağırma
Daha karmaşık durumlarda ek argümanlar sağlamak ya da birden çok dönüşüm gerçekleştirmek isteyebilirsiniz. Bu sorunu basit bir örnekle ele alalım: Verilerimizde bazı eksik değerler varsa ne olur? median() bu eksik değerleri yayarak istediğimizden kötü bir çıktı verir:
set.seed(1014)
rnorm_na <- function(n, n_na, mean = 0, sd = 1) {
  sample(c(rnorm(n - n_na, mean = mean, sd = sd), rep(NA, n_na)))
}

df_miss <- tibble(
  a = rnorm_na(5, 1),
  b = rnorm_na(5, 1),
  c = rnorm_na(5, 2),
  d = rnorm(5)
)
df_miss |>
  summarize(
    across(a:d, median),
    n = n()
  )
#> # A tibble: 1 × 5
#>       a     b     c     d     n
#>   <dbl> <dbl> <dbl> <dbl> <int>
#> 1    NA    NA    NA 0.413     5
Bu eksik değerleri kaldırmak için median() fonksiyonuna na.rm = TRUE aktarabilsek iyi olurdu. Bunu yapmak için median() fonksiyonunu doğrudan çağırmak yerine onu istediğimiz argümanlarla çağıran yeni bir fonksiyon oluşturmamız gerekir:
Bu biraz uzundur; dolayısıyla R kullanışlı bir kısayol sunar: Bu tür tek kullanımlık ya da anonim1 fonksiyonlarda function yerine \ kullanabilirsiniz2:
Her iki durumda da across() fiilen aşağıdaki koda genişler:
Eksik değerleri median() hesabından çıkardığımızda tam olarak kaç değerin kaldırıldığını bilmek iyi olurdu. Bunu across() fonksiyonuna iki fonksiyon sağlayarak bulabiliriz: biri medyanı hesaplar, diğeri eksik değerleri sayar. .fns argümanına adlandırılmış bir liste vererek birden çok fonksiyon sağlarsınız:
df_miss |>
  summarize(
    across(a:d, list(
      median = \(x) median(x, na.rm = TRUE),
      n_miss = \(x) sum(is.na(x))
    )),
    n = n()
  )
#> # A tibble: 1 × 9
#>   a_median a_n_miss b_median b_n_miss c_median c_n_miss d_median d_n_miss
#>      <dbl>    <int>    <dbl>    <int>    <dbl>    <int>    <dbl>    <int>
#> 1   -0.703        1   -0.265        1   -0.522        2    0.413        0
#> # ℹ 1 more variable: n <int>
Dikkatle bakarsanız sütunların, .col özgün sütunun ve .fn fonksiyonun adı olacak biçimde {.col}_{.fn} gibi bir glue belirtimiyle (Bölüm 14.3.2) adlandırıldığını sezebilirsiniz. Bu bir rastlantı değildir! Sonraki kısımda öğreneceğiniz gibi kendi glue belirtiminizi sağlamak için .names argümanını kullanabilirsiniz.
26.2.4 Sütun adları
across() sonucu .names argümanında sağlanan belirtime göre adlandırılır. Fonksiyon adının önce gelmesini istersek kendi belirtimimizi sağlayabiliriz3:
df_miss |>
  summarize(
    across(
      a:d,
      list(
        median = \(x) median(x, na.rm = TRUE),
        n_miss = \(x) sum(is.na(x))
      ),
      .names = "{.fn}_{.col}"
    ),
    n = n(),
  )
#> # A tibble: 1 × 9
#>   median_a n_miss_a median_b n_miss_b median_c n_miss_c median_d n_miss_d
#>      <dbl>    <int>    <dbl>    <int>    <dbl>    <int>    <dbl>    <int>
#> 1   -0.703        1   -0.265        1   -0.522        2    0.413        0
#> # ℹ 1 more variable: n <int>
.names argümanı özellikle across() fonksiyonunu mutate() ile kullandığınızda önemlidir. Varsayılan olarak across() çıktısına girdilerle aynı adlar verilir. Bu, mutate() içindeki across() çağrısının var olan sütunları değiştireceği anlamına gelir. Örneğin burada NA değerlerini 0 ile değiştirmek için coalesce() kullanırız:
Bunun yerine yeni sütunlar oluşturmak isterseniz çıktıya yeni adlar vermek için .names argümanını kullanabilirsiniz:
df_miss |>
  mutate(
    across(a:d, \(x) coalesce(x, 0), .names = "{.col}_na_zero")
  )
#> # A tibble: 5 × 8
#>          a      b      c        d a_na_zero b_na_zero c_na_zero d_na_zero
#>      <dbl>  <dbl>  <dbl>    <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#> 1 -0.00557 -0.283 -1.86  -0.783    -0.00557    -0.283    -1.86   -0.783
#> 2  0.255   -0.247 -0.522 -0.00289   0.255      -0.247    -0.522  -0.00289
#> 3 -1.40    -0.554  0.512  0.413    -1.40       -0.554     0.512   0.413
#> 4 -2.44    -0.244 NA      0.724    -2.44       -0.244     0       0.724
#> 5 NA       NA     NA      2.35      0           0         0       2.35
26.2.5 Süzme
across(), summarize() ve mutate() için çok uygundur; ancak birden çok koşulu genellikle | ya da & ile birleştirdiğinizden filter() ile kullanılması daha zordur. across() fonksiyonunun birden çok mantıksal sütun oluşturmaya yardımcı olabileceği açıktır; peki sonra ne olacak? Bu nedenle dplyr, across() fonksiyonunun if_any() ve if_all() adlı iki çeşidini sağlar:
# df_miss |> filter(is.na(a) | is.na(b) | is.na(c) | is.na(d)) ile aynı
df_miss |> filter(if_any(a:d, is.na))
#> # A tibble: 2 × 4
#>       a      b     c     d
#>   <dbl>  <dbl> <dbl> <dbl>
#> 1 -2.44 -0.244    NA 0.724
#> 2 NA    NA        NA 2.35

# df_miss |> filter(is.na(a) & is.na(b) & is.na(c) & is.na(d)) ile aynı
df_miss |> filter(if_all(a:d, is.na))
#> # A tibble: 0 × 4
#> # ℹ 4 variables: a <dbl>, b <dbl>, c <dbl>, d <dbl>
26.2.6 Fonksiyonların içinde across()
across() birden çok sütun üzerinde işlem yapmanızı sağladığı için programlamada özellikle kullanışlıdır. Örneğin Jacob Scott, tüm tarih sütunlarını yıl, ay ve gün sütunlarına genişletmek üzere çeşitli lubridate fonksiyonlarını bir araya getiren bu küçük yardımcıyı kullanır:
expand_dates <- function(df) {
  df |>
    mutate(
      across(where(is.Date), list(year = year, month = month, day = mday))
    )
}

df_date <- tibble(
  name = c("Amy", "Bob"),
  date = ymd(c("2009-08-03", "2010-01-16"))
)

df_date |>
  expand_dates()
#> # A tibble: 2 × 5
#>   name  date       date_year date_month date_day
#>   <chr> <date>         <dbl>      <dbl>    <int>
#> 1 Amy   2009-08-03      2009          8        3
#> 2 Bob   2010-01-16      2010          1       16
across() fonksiyonunun ilk argümanı tidy seçimi kullandığından tek bir argümanda birden çok sütun sağlamak da kolaydır; Bölüm 25.3.2 bölümünde ele aldığımız gibi yalnızca bu argümanı sarmalamayı hatırlamanız gerekir. Örneğin bu fonksiyon varsayılan olarak sayısal sütunların ortalamalarını hesaplar. Ancak ikinci argümanı sağlayarak yalnızca seçtiğiniz sütunları özetleyebilirsiniz:
summarize_means <- function(df, summary_vars = where(is.numeric)) {
  df |>
    summarize(
      across({{ summary_vars }}, \(x) mean(x, na.rm = TRUE)),
      n = n(),
      .groups = "drop"
    )
}
diamonds |>
  group_by(cut) |>
  summarize_means()
#> # A tibble: 5 × 9
#>   cut       carat depth table price     x     y     z     n
#>   <ord>     <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <int>
#> 1 Fair      1.05   64.0  59.1 4359.  6.25  6.18  3.98  1610
#> 2 Good      0.849  62.4  58.7 3929.  5.84  5.85  3.64  4906
#> 3 Very Good 0.806  61.8  58.0 3982.  5.74  5.77  3.56 12082
#> 4 Premium   0.892  61.3  58.7 4584.  5.97  5.94  3.65 13791
#> 5 Ideal     0.703  61.7  56.0 3458.  5.51  5.52  3.40 21551

diamonds |>
  group_by(cut) |>
  summarize_means(c(carat, x:z))
#> # A tibble: 5 × 6
#>   cut       carat     x     y     z     n
#>   <ord>     <dbl> <dbl> <dbl> <dbl> <int>
#> 1 Fair      1.05   6.25  6.18  3.98  1610
#> 2 Good      0.849  5.84  5.85  3.64  4906
#> 3 Very Good 0.806  5.74  5.77  3.56 12082
#> 4 Premium   0.892  5.97  5.94  3.65 13791
#> 5 Ideal     0.703  5.51  5.52  3.40 21551
26.2.7 pivot_longer() ile karşılaştırma
Devam etmeden önce across() ile pivot_longer() arasındaki ilginç bir bağlantıya dikkat çekmekte yarar var (Bölüm 5.3). Birçok durumda önce verileri döndürüp ardından işlemleri sütuna göre değil gruba göre yaparak aynı hesaplamaları gerçekleştirebilirsiniz. Örneğin bu çok fonksiyonlu özeti ele alın:
Verileri uzun biçime döndürüp ardından özetleyerek aynı değerleri hesaplayabiliriz:
long <- df |>
  pivot_longer(a:d) |>
  group_by(name) |>
  summarize(
    median = median(value),
    mean = mean(value)
  )
long
#> # A tibble: 4 × 3
#>   name   median    mean
#>   <chr>   <dbl>   <dbl>
#> 1 a     -0.246  -0.0426
#> 2 b      0.155  -0.0656
#> 3 c      0.0480 -0.0297
#> 4 d     -0.193  -0.200
across() ile aynı yapıyı istiyorsanız yeniden döndürebilirsiniz:
long |>
  pivot_wider(
    names_from = name,
    values_from = c(median, mean),
    names_vary = "slowest",
    names_glue = "{name}_{.value}"
  )
#> # A tibble: 1 × 8
#>   a_median  a_mean b_median  b_mean c_median  c_mean d_median d_mean
#>      <dbl>   <dbl>    <dbl>   <dbl>    <dbl>   <dbl>    <dbl>  <dbl>
#> 1   -0.246 -0.0426    0.155 -0.0656   0.0480 -0.0297   -0.193 -0.200
Bu, bilinmesi yararlı bir tekniktir; çünkü bazen across() ile şu anda çözülemeyen bir problemle karşılaşırsınız: Aynı anda hesaplama yapmak istediğiniz sütun grupları olduğunda. Örneğin veri çerçevemizin hem değerleri hem ağırlıkları içerdiğini ve ağırlıklı ortalama hesaplamak istediğimizi düşünün:
Şu anda bunu across() ile yapmanın bir yolu yoktur4, ancak pivot_longer() ile oldukça kolaydır:
df_long <- df_paired |>
  pivot_longer(
    everything(),
    names_to = c("group", ".value"),
    names_sep = "_"
  )
df_long
#> # A tibble: 40 × 3
#>   group    val   wts
#>   <chr>  <dbl> <dbl>
#> 1 a     -1.40  0.290
#> 2 b     -1.86  0.461
#> 3 c      0.935 0.528
#> 4 d      2.76  0.709
#> 5 a      0.255 0.678
#> 6 b     -0.522 0.315
#> # ℹ 34 more rows

df_long |>
  group_by(group) |>
  summarize(mean = weighted.mean(val, wts))
#> # A tibble: 4 × 2
#>   group    mean
#>   <chr>   <dbl>
#> 1 a     -0.207
#> 2 b     -0.237
#> 3 c      0.0208
#> 4 d      0.0655
Gerekirse bunu pivot_wider() ile yeniden özgün biçimine döndürebilirsiniz.
26.2.8 Alıştırmalar
-
Aşağıdakileri yaparak
across()becerilerinizi geliştirin:palmerpenguins::penguinsveri kümesinin her sütunundaki benzersiz değer sayısını hesaplayın.mtcarsveri kümesindeki her sütunun ortalamasını hesaplayın.diamondsveri kümesinicut,clarityvecolordeğişkenlerine göre gruplandırın; ardından gözlem sayısını ve her sayısal sütunun ortalamasını hesaplayın.
across()içinde bir fonksiyon listesi kullanır, ancak fonksiyonları adlandırmazsanız ne olur? Çıktı nasıl adlandırılır?expand_dates()fonksiyonunu genişletildikten sonra tarih sütunlarını otomatik olarak kaldıracak biçimde düzenleyin. Herhangi bir argümanı sarmalamanız gerekiyor mu?-
Bu fonksiyondaki işlem hattının her adımının ne yaptığını açıklayın.
where()fonksiyonunun hangi özel özelliğinden yararlanıyoruz?
26.3 Birden çok dosyayı okuma
Önceki kısımda bir dönüşümü birden çok sütunda yinelemek için dplyr::across() kullanmayı öğrendiniz. Bu kısımda bir dizindeki her dosya üzerinde işlem yapmak için purrr::map() kullanmayı öğreneceksiniz. Önce gereksinimi ortaya koyalım: Okumak istediğiniz Excel hesap çizelgeleriyle dolu bir dizininiz olduğunu düşünün5. Bunu kopyala-yapıştır ile yapabilirsiniz:
data2019 <- readxl::read_excel("data/y2019.xlsx")
data2020 <- readxl::read_excel("data/y2020.xlsx")
data2021 <- readxl::read_excel("data/y2021.xlsx")
data2022 <- readxl::read_excel("data/y2022.xlsx")
Ardından tümünü birleştirmek için dplyr::bind_rows() kullanabilirsiniz:
data <- bind_rows(data2019, data2020, data2021, data2022)Özellikle yalnızca dört değil yüzlerce dosyanız varsa bunun kısa sürede zahmetli olacağını tahmin edebilirsiniz. Aşağıdaki kısımlar bu tür bir görevi nasıl otomatikleştireceğinizi gösterir. Üç temel adım vardır: Bir dizindeki tüm dosyaları listelemek için list.files(), her birini bir listeye okumak için purrr::map(), ardından bunları tek bir veri çerçevesinde birleştirmek için purrr::list_rbind() kullanmak. Sonrasında her dosyaya tamamen aynı işlemi uygulayamadığınız, heterojenliğin arttığı durumları nasıl ele alabileceğinizi tartışacağız.
26.3.1 Bir dizindeki dosyaları listeleme
Adından anlaşılacağı gibi list.files() bir dizindeki dosyaları listeler. Neredeyse her zaman üç argüman kullanırsınız:
İlk argüman
path, aranacak dizindir.pattern, dosya adlarını süzmek için kullanılan düzenli ifadedir. En yaygın örüntü, belirli bir uzantıya sahip tüm dosyaları bulmak için[.]xlsx$veya[.]csv$gibi bir ifadedir.full.names, dizin adının çıktıya dahil edilip edilmeyeceğini belirler. Neredeyse her zaman bununTRUEolmasını istersiniz.
Örneğimizi somutlaştırmak için bu kitapta gapminder paketindeki verileri içeren 12 Excel hesap çizelgesinden oluşan bir klasör bulunur. Bu klasörü https://github.com/hadley/r4ds/tree/main/data/gapminder adresinde bulabilirsiniz. Her dosya 142 ülkenin bir yıllık verilerini içerir. Uygun bir list.files() çağrısıyla tümünü listeleyebiliriz:
paths <- list.files("data/gapminder", pattern = "[.]xlsx$", full.names = TRUE)
paths
#>  [1] "data/gapminder/1952.xlsx" "data/gapminder/1957.xlsx"
#>  [3] "data/gapminder/1962.xlsx" "data/gapminder/1967.xlsx"
#>  [5] "data/gapminder/1972.xlsx" "data/gapminder/1977.xlsx"
#>  [7] "data/gapminder/1982.xlsx" "data/gapminder/1987.xlsx"
#>  [9] "data/gapminder/1992.xlsx" "data/gapminder/1997.xlsx"
#> [11] "data/gapminder/2002.xlsx" "data/gapminder/2007.xlsx"
26.3.2 Listeler
Bu 12 yola sahip olduğumuza göre 12 veri çerçevesi elde etmek için read_excel() fonksiyonunu 12 kez çağırabiliriz:
gapminder_1952 <- readxl::read_excel("data/gapminder/1952.xlsx")
gapminder_1957 <- readxl::read_excel("data/gapminder/1957.xlsx")
gapminder_1962 <- readxl::read_excel("data/gapminder/1962.xlsx")
 ...,
gapminder_2007 <- readxl::read_excel("data/gapminder/2007.xlsx")
Ancak her çalışma sayfasını kendi değişkenine koymak, birkaç adım sonra onlarla çalışmayı zorlaştıracaktır. Bunun yerine tümünü tek bir nesneye koyarsak çalışmak daha kolay olur. Liste bu iş için kusursuz bir araçtır:
files <- list(
  readxl::read_excel("data/gapminder/1952.xlsx"),
  readxl::read_excel("data/gapminder/1957.xlsx"),
  readxl::read_excel("data/gapminder/1962.xlsx"),
  ...,
  readxl::read_excel("data/gapminder/2007.xlsx")
)
Bu veri çerçeveleri artık bir listede olduğuna göre içlerinden birini nasıl alırsınız? i. öğeyi çıkarmak için files[[i]] kullanabilirsiniz:
files[[3]]
#> # A tibble: 142 × 5
#>   country     continent lifeExp      pop gdpPercap
#>   <chr>       <chr>       <dbl>    <dbl>     <dbl>
#> 1 Afghanistan Asia         32.0 10267083      853.
#> 2 Albania     Europe       64.8  1728137     2313.
#> 3 Algeria     Africa       48.3 11000948     2551.
#> 4 Angola      Africa       34    4826015     4269.
#> 5 Argentina   Americas     65.1 21283783     7133.
#> 6 Australia   Oceania      70.9 10794968    12217.
#> # ℹ 136 more rows
[[ işlecine Bölüm 27.3 bölümünde daha ayrıntılı döneceğiz.
26.3.3 purrr::map() ve list_rbind()
Bu veri çerçevelerini bir listede “elle” toplama kodunu yazmak, temelde dosyaları tek tek okuyan kodu yazmak kadar zahmetlidir. Neyse ki paths vektörümüzden daha iyi yararlanmak için purrr::map() kullanabiliriz. map(), across() fonksiyonuna benzer; ancak veri çerçevesinin her sütununda değil, bir vektörün her öğesinde işlem yapar. map(x, f) aşağıdakinin kısa yazımıdır:
list(
  f(x[[1]]),
  f(x[[2]]),
  ...,
  f(x[[n]])
)
Dolayısıyla 12 veri çerçevesinden oluşan bir liste elde etmek için map() kullanabiliriz:
files <- map(paths, readxl::read_excel)
length(files)
#> [1] 12

files[[1]]
#> # A tibble: 142 × 5
#>   country     continent lifeExp      pop gdpPercap
#>   <chr>       <chr>       <dbl>    <dbl>     <dbl>
#> 1 Afghanistan Asia         28.8  8425333      779.
#> 2 Albania     Europe       55.2  1282697     1601.
#> 3 Algeria     Africa       43.1  9279525     2449.
#> 4 Angola      Africa       30.0  4232095     3521.
#> 5 Argentina   Americas     62.5 17876956     5911.
#> 6 Australia   Oceania      69.1  8691212    10040.
#> # ℹ 136 more rows
(Bu da str() ile pek kısa görüntülenmeyen bir veri yapısıdır; dolayısıyla RStudio’ya yükleyip View() ile incelemek isteyebilirsiniz.)
Artık veri çerçeveleri listesini tek bir veri çerçevesinde birleştirmek için purrr::list_rbind() kullanabiliriz:
list_rbind(files)
#> # A tibble: 1,704 × 5
#>   country     continent lifeExp      pop gdpPercap
#>   <chr>       <chr>       <dbl>    <dbl>     <dbl>
#> 1 Afghanistan Asia         28.8  8425333      779.
#> 2 Albania     Europe       55.2  1282697     1601.
#> 3 Algeria     Africa       43.1  9279525     2449.
#> 4 Angola      Africa       30.0  4232095     3521.
#> 5 Argentina   Americas     62.5 17876956     5911.
#> 6 Australia   Oceania      69.1  8691212    10040.
#> # ℹ 1,698 more rows
Ya da iki adımı bir işlem hattında aynı anda yapabiliriz:
paths |>
  map(readxl::read_excel) |>
  list_rbind()
Peki read_excel() fonksiyonuna ek argümanlar aktarmak istersek ne olur? across() ile kullandığımız tekniğin aynısını kullanırız. Örneğin n_max = 1 ile verilerin ilk birkaç satırına göz atmak çoğu zaman kullanışlıdır:
paths |>
  map(\(path) readxl::read_excel(path, n_max = 1)) |>
  list_rbind()
#> # A tibble: 12 × 5
#>   country     continent lifeExp      pop gdpPercap
#>   <chr>       <chr>       <dbl>    <dbl>     <dbl>
#> 1 Afghanistan Asia         28.8  8425333      779.
#> 2 Afghanistan Asia         30.3  9240934      821.
#> 3 Afghanistan Asia         32.0 10267083      853.
#> 4 Afghanistan Asia         34.0 11537966      836.
#> 5 Afghanistan Asia         36.1 13079460      740.
#> 6 Afghanistan Asia         38.4 14880372      786.
#> # ℹ 6 more rows
Bu, bir şeyin eksik olduğunu açıkça gösterir: Değer tek tek dosyalarda değil dosya yolunda kaydedildiği için year sütunu yoktur. Sırada bu sorunu ele alacağız.
26.3.4 Dosya yolundaki veriler
Bazen dosyanın adı başlı başına veridir. Bu örnekte dosya adı, tek tek dosyalarda başka bir yerde kaydedilmeyen yılı içerir. Bu sütunu son veri çerçevesine almak için iki şey yapmamız gerekir:
Önce yollar vektörünü adlandırırız. Bunu yapmanın en kolay yolu, bir fonksiyon alabilen set_names() fonksiyonudur. Burada tam yoldan yalnızca dosya adını çıkarmak için basename() kullanırız:
paths |> set_names(basename)
#>                  1952.xlsx                  1957.xlsx
#> "data/gapminder/1952.xlsx" "data/gapminder/1957.xlsx"
#>                  1962.xlsx                  1967.xlsx
#> "data/gapminder/1962.xlsx" "data/gapminder/1967.xlsx"
#>                  1972.xlsx                  1977.xlsx
#> "data/gapminder/1972.xlsx" "data/gapminder/1977.xlsx"
#>                  1982.xlsx                  1987.xlsx
#> "data/gapminder/1982.xlsx" "data/gapminder/1987.xlsx"
#>                  1992.xlsx                  1997.xlsx
#> "data/gapminder/1992.xlsx" "data/gapminder/1997.xlsx"
#>                  2002.xlsx                  2007.xlsx
#> "data/gapminder/2002.xlsx" "data/gapminder/2007.xlsx"
Bu adlar tüm map fonksiyonları tarafından otomatik olarak taşınır; dolayısıyla veri çerçeveleri listesi aynı adlara sahip olur:
files <- paths |>
  set_names(basename) |>
  map(readxl::read_excel)
Bu durumda map() çağrısı aşağıdakinin kısa yazımı olur:
files <- list(
  "1952.xlsx" = readxl::read_excel("data/gapminder/1952.xlsx"),
  "1957.xlsx" = readxl::read_excel("data/gapminder/1957.xlsx"),
  "1962.xlsx" = readxl::read_excel("data/gapminder/1962.xlsx"),
  ...,
  "2007.xlsx" = readxl::read_excel("data/gapminder/2007.xlsx")
)
Öğeleri adlarına göre çıkarmak için [[ işlecini de kullanabilirsiniz:
files[["1962.xlsx"]]
#> # A tibble: 142 × 5
#>   country     continent lifeExp      pop gdpPercap
#>   <chr>       <chr>       <dbl>    <dbl>     <dbl>
#> 1 Afghanistan Asia         32.0 10267083      853.
#> 2 Albania     Europe       64.8  1728137     2313.
#> 3 Algeria     Africa       48.3 11000948     2551.
#> 4 Angola      Africa       34    4826015     4269.
#> 5 Argentina   Americas     65.1 21283783     7133.
#> 6 Australia   Oceania      70.9 10794968    12217.
#> # ℹ 136 more rows
Ardından list_rbind() fonksiyonunun names_to argümanıyla adları year adlı yeni bir sütuna kaydetmesini söyler, karakter dizisindeki sayıyı çıkarmak için readr::parse_number() kullanırız.
paths |>
  set_names(basename) |>
  map(readxl::read_excel) |>
  list_rbind(names_to = "year") |>
  mutate(year = parse_number(year))
#> # A tibble: 1,704 × 6
#>    year country     continent lifeExp      pop gdpPercap
#>   <dbl> <chr>       <chr>       <dbl>    <dbl>     <dbl>
#> 1  1952 Afghanistan Asia         28.8  8425333      779.
#> 2  1952 Albania     Europe       55.2  1282697     1601.
#> 3  1952 Algeria     Africa       43.1  9279525     2449.
#> 4  1952 Angola      Africa       30.0  4232095     3521.
#> 5  1952 Argentina   Americas     62.5 17876956     5911.
#> 6  1952 Australia   Oceania      69.1  8691212    10040.
#> # ℹ 1,698 more rows
Daha karmaşık durumlarda dizin adında saklanan başka değişkenler bulunabilir veya dosya adı birden çok veri parçası içerebilir. Bu durumda tam yolu kaydetmek için argümansız set_names(), ardından bunları kullanışlı sütunlara dönüştürmek için tidyr::separate_wider_delim() ve benzeri fonksiyonları kullanın.
paths |>
  set_names() |>
  map(readxl::read_excel) |>
  list_rbind(names_to = "year") |>
  separate_wider_delim(year, delim = "/", names = c(NA, "dir", "file")) |>
  separate_wider_delim(file, delim = ".", names = c("file", "ext"))
#> # A tibble: 1,704 × 8
#>   dir       file  ext   country     continent lifeExp      pop gdpPercap
#>   <chr>     <chr> <chr> <chr>       <chr>       <dbl>    <dbl>     <dbl>
#> 1 gapminder 1952  xlsx  Afghanistan Asia         28.8  8425333      779.
#> 2 gapminder 1952  xlsx  Albania     Europe       55.2  1282697     1601.
#> 3 gapminder 1952  xlsx  Algeria     Africa       43.1  9279525     2449.
#> 4 gapminder 1952  xlsx  Angola      Africa       30.0  4232095     3521.
#> 5 gapminder 1952  xlsx  Argentina   Americas     62.5 17876956     5911.
#> 6 gapminder 1952  xlsx  Australia   Oceania      69.1  8691212    10040.
#> # ℹ 1,698 more rows
26.3.5 Çalışmanızı kaydetme
Düzenli ve güzel bir veri çerçevesine ulaşmak için tüm bu zorlu çalışmayı yaptığınıza göre çalışmanızı kaydetmenin tam zamanıdır:
gapminder <- paths |>
  set_names(basename) |>
  map(readxl::read_excel) |>
  list_rbind(names_to = "year") |>
  mutate(year = parse_number(year))

write_csv(gapminder, "gapminder.csv")
Gelecekte bu probleme döndüğünüzde tek bir CSV dosyasını okuyabilirsiniz. Bölüm 22.4 bölümünde ele alındığı gibi büyük ve daha zengin veri kümeleri için Parquet kullanmak .csv biçiminden daha iyi bir seçim olabilir.
Bir projede çalışıyorsanız bu tür veri hazırlama işlerini yapan dosyaya 0-cleanup.R gibi bir ad vermenizi öneririz. Dosya adındaki 0, bu dosyanın her şeyden önce çalıştırılması gerektiğini gösterir.
Girdi veri dosyalarınız zaman içinde değişiyorsa veri temizleme kodunuzu girdi dosyalarından biri değiştirildiğinde otomatik olarak yeniden çalışacak biçimde ayarlamak için targets gibi bir araç öğrenmeyi düşünebilirsiniz.
26.3.6 Çok sayıda basit iterasyon
Burada verileri doğrudan diskten yükledik ve düzenli bir veri kümesi elde edecek kadar şanslıydık. Çoğu durumda biraz daha düzenleme yapmanız gerekir ve iki temel seçeneğiniz vardır: Karmaşık bir fonksiyonla tek tur iterasyon ya da basit fonksiyonlarla birden çok tur iterasyon yapabilirsiniz. Deneyimlerimize göre çoğu kişi önce tek bir karmaşık iterasyona yönelir; ancak birden çok basit iterasyon yapmak çoğu zaman daha iyidir.
Örneğin bir grup dosyayı okumak, eksik değerleri süzmek, verileri döndürmek ve ardından birleştirmek istediğinizi düşünün. Probleme yaklaşmanın bir yolu, bir dosya alıp tüm bu adımları uygulayan fonksiyon yazmak ve sonra map() fonksiyonunu bir kez çağırmaktır:
process_file <- function(path) {
  df <- read_csv(path)

  df |>
    filter(!is.na(id)) |>
    mutate(id = tolower(id)) |>
    pivot_longer(jan:dec, names_to = "month")
}

paths |>
  map(process_file) |>
  list_rbind()
Alternatif olarak process_file() fonksiyonunun her adımını tüm dosyalara uygulayabilirsiniz:
paths |>
  map(read_csv) |>
  map(\(df) df |> filter(!is.na(id))) |>
  map(\(df) df |> mutate(id = tolower(id))) |>
  map(\(df) df |> pivot_longer(jan:dec, names_to = "month")) |>
  list_rbind()
Diğer dosyalara geçmeden önce ilk dosyayı kusursuz hâle getirmeye saplanmanızı önlediği için bu yaklaşımı öneriyoruz. Düzenleme ve temizleme sırasında tüm verileri dikkate alarak bütüncül düşünme ve daha kaliteli bir sonuç elde etme olasılığınızı artırırsınız.
Bu örnekte tüm veri çerçevelerini daha erken birleştirerek yapabileceğiniz başka bir eniyileme vardır. Ardından olağan dplyr davranışından yararlanabilirsiniz:
paths |>
  map(read_csv) |>
  list_rbind() |>
  filter(!is.na(id)) |>
  mutate(id = tolower(id)) |>
  pivot_longer(jan:dec, names_to = "month")
26.3.7 Heterojen veriler
Ne yazık ki veri çerçeveleri bazen o kadar heterojen olur ki list_rbind() ya başarısız olur ya da pek kullanışlı olmayan bir veri çerçevesi üretir; bu nedenle map() fonksiyonundan doğrudan list_rbind() fonksiyonuna geçmek mümkün olmaz. Bu durumda da işe tüm dosyaları yükleyerek başlamak yararlıdır:
files <- paths |>
  map(readxl::read_excel)
Ardından veri bilimi becerilerinizle inceleyebilmeniz için veri çerçevelerinin yapısını yakalamak çok kullanışlı bir stratejidir. Bunu yapmanın bir yolu, her sütun için bir satır içeren tibble döndüren bu kullanışlı df_types fonksiyonudur6:
df_types <- function(df) {
  tibble(
    col_name = names(df),
    col_type = map_chr(df, vctrs::vec_ptype_full),
    n_miss = map_int(df, \(x) sum(is.na(x)))
  )
}

df_types(gapminder)
#> # A tibble: 6 × 3
#>   col_name  col_type  n_miss
#>   <chr>     <chr>      <int>
#> 1 year      double         0
#> 2 country   character      0
#> 3 continent character      0
#> 4 lifeExp   double         0
#> 5 pop       double         0
#> 6 gdpPercap double         0
Ardından bu fonksiyonu tüm dosyalara uygulayabilir ve farklılıkların nerede olduğunu görmeyi kolaylaştırmak için verileri döndürebilirsiniz. Örneğin bu, üzerinde çalıştığımız gapminder hesap çizelgelerinin tümünün oldukça homojen olduğunu doğrulamayı kolaylaştırır:
files |>
  map(df_types) |>
  list_rbind(names_to = "file_name") |>
  select(-n_miss) |>
  pivot_wider(names_from = col_name, values_from = col_type)
#> # A tibble: 12 × 6
#>   file_name country   continent lifeExp pop    gdpPercap
#>   <chr>     <chr>     <chr>     <chr>   <chr>  <chr>
#> 1 1952.xlsx character character double  double double
#> 2 1957.xlsx character character double  double double
#> 3 1962.xlsx character character double  double double
#> 4 1967.xlsx character character double  double double
#> 5 1972.xlsx character character double  double double
#> 6 1977.xlsx character character double  double double
#> # ℹ 6 more rows
Dosyalar heterojen biçimlere sahipse onları başarıyla birleştirmeden önce daha fazla işlem yapmanız gerekebilir. Ne yazık ki bunu kendi başınıza çözmeniz gerekecek; ancak map_if() ve map_at() hakkında bilgi edinmek isteyebilirsiniz. map_if() bir listenin öğelerini değerlerine, map_at() ise adlarına göre seçerek değiştirmenizi sağlar.
26.3.8 Başarısızlıkları ele alma
Bazen verilerinizin yapısı o kadar değişken olabilir ki tüm dosyaları tek bir komutla okuyamazsınız. Bu durumda map() fonksiyonunun dezavantajlarından biriyle karşılaşırsınız: Ya bütünüyle başarılı olur ya da bütünüyle başarısız olur. map() bir dizindeki tüm dosyaları başarıyla okur ya da hata verip hiçbir dosyayı okumaz. Bu can sıkıcıdır: Tek bir başarısızlık neden diğer tüm başarılı sonuçlara erişmenizi engellesin?
Neyse ki purrr bu sorunu ele alan bir yardımcı sunar: possibly(). possibly(), fonksiyon işleci olarak bilinen bir araçtır: Bir fonksiyon alır ve değiştirilmiş davranışa sahip bir fonksiyon döndürür. Özellikle possibly(), hata veren bir fonksiyonu belirttiğiniz değeri döndüren bir fonksiyona dönüştürür:
files <- paths |>
  map(possibly(\(path) readxl::read_excel(path), NULL))

data <- files |> list_rbind()
Birçok tidyverse fonksiyonu gibi list_rbind() de NULL değerlerini otomatik olarak yok saydığından bu yaklaşım burada özellikle iyi çalışır.
Artık kolayca okunabilen tüm verilere sahipsiniz; bazı dosyaların neden yüklenemediğini ve bunlar için ne yapılacağını belirleyen zor bölümü ele alma zamanı. Başarısız olan yolları alarak başlayın:
failed <- map_vec(files, is.null)
paths[failed]
#> character(0)
Ardından her başarısız dosya için içe aktarma fonksiyonunu yeniden çağırın ve neyin yanlış gittiğini belirleyin.
26.4 Birden çok çıktıyı kaydetme
Önceki kısımda birden çok dosyayı tek bir nesneye okumak için kullanışlı olan map() fonksiyonunu öğrendiniz. Bu kısımda bunun bir bakıma tersi olan problemi inceleyeceğiz: Bir ya da daha fazla R nesnesini alıp bir ya da daha fazla dosyaya nasıl kaydedebilirsiniz? Bu problemi üç örnekle inceleyeceğiz:
- Birden çok veri çerçevesini tek bir veritabanına kaydetme.
- Birden çok veri çerçevesini birden çok
.csvdosyasına kaydetme. - Birden çok grafiği birden çok
.pngdosyasına kaydetme.
26.4.1 Veritabanına yazma
Bazen aynı anda birçok dosyayla çalışırken tüm verilerinizi bir kerede belleğe sığdırmak mümkün olmaz ve map(files, read_csv) kullanamazsınız. Bu sorunu ele almanın bir yolu, dbplyr ile yalnızca ihtiyaç duyduğunuz bölümlere erişebilmek için verilerinizi bir veritabanına yüklemektir.
Şanslıysanız kullandığınız veritabanı paketi bir yollar vektörü alıp tümünü veritabanına yükleyen kullanışlı bir fonksiyon sağlar. duckdb’nin duckdb_read_csv() fonksiyonu buna örnektir:
con <- DBI::dbConnect(duckdb::duckdb())
duckdb::duckdb_read_csv(con, "gapminder", paths)
Bu burada iyi çalışırdı; ancak CSV dosyalarımız değil, Excel hesap çizelgelerimiz var. Bu nedenle işlemi “elle” yapmamız gerekecek. Elle yapmayı öğrenmek, çok sayıda CSV dosyanız olduğunda ve çalıştığınız veritabanında tümünü yükleyen tek bir fonksiyon bulunmadığında da size yardımcı olacaktır.
İşe verilerle dolduracağımız bir tablo oluşturarak başlamamız gerekir. Bunu yapmanın en kolay yolu, istediğimiz tüm sütunları ancak verilerin yalnızca bir örneğini içeren sahte bir veri çerçevesi, yani şablon oluşturmaktır. gapminder verileri için tek bir dosyayı okuyup yılı ekleyerek bu şablonu oluşturabiliriz:
template <- readxl::read_excel(paths[[1]])
template$year <- 1952
template
#> # A tibble: 142 × 6
#>   country     continent lifeExp      pop gdpPercap  year
#>   <chr>       <chr>       <dbl>    <dbl>     <dbl> <dbl>
#> 1 Afghanistan Asia         28.8  8425333      779.  1952
#> 2 Albania     Europe       55.2  1282697     1601.  1952
#> 3 Algeria     Africa       43.1  9279525     2449.  1952
#> 4 Angola      Africa       30.0  4232095     3521.  1952
#> 5 Argentina   Americas     62.5 17876956     5911.  1952
#> 6 Australia   Oceania      69.1  8691212    10040.  1952
#> # ℹ 136 more rows
Artık veritabanına bağlanıp şablonumuzu veritabanı tablosuna dönüştürmek için DBI::dbCreateTable() kullanabiliriz:
con <- DBI::dbConnect(duckdb::duckdb())
#> duckdb keeps downloaded extensions and secrets in a temporary directory:
#> ℹ /tmp/RtmpZVcZa2/duckdb
#> This is removed when the R session ends.
#> • Extensions are re-downloaded each session.
#> • Secrets are lost.
#> ℹ Run duckdb(shared_home = TRUE) (or create ~/.duckdb) to keep them (suitable for most users).
#> ℹ Run duckdb(shared_home = FALSE) to accept the temporary directory (and silence this message).
#> ℹ See ?duckdb_storage for details and alternatives.
DBI::dbCreateTable(con, "gapminder", template)
dbCreateTable() template içindeki verileri değil, yalnızca değişken adlarını ve türlerini kullanır. Dolayısıyla gapminder tablosunu şimdi incelerseniz boş olduğunu, ancak ihtiyaç duyduğumuz değişkenlere beklediğimiz türlerle sahip olduğunu görürsünüz:
con |> tbl("gapminder")
#> # A query:  ?? x 6
#> # Database: DuckDB 1.5.5 [unknown@Linux 6.17.0-1022-azure:R 4.6.1/:memory:]
#> # ℹ 6 variables: country <chr>, continent <chr>, lifeExp <dbl>, pop <dbl>,
#> #   gdpPercap <dbl>, year <dbl>
Sırada tek bir dosya yolunu alan, dosyayı R’a okuyan ve sonucu gapminder tablosuna ekleyen bir fonksiyona ihtiyacımız var. Bunu read_excel() ile DBI::dbAppendTable() fonksiyonlarını birleştirerek yapabiliriz:
append_file <- function(path) {
  df <- readxl::read_excel(path)
  df$year <- parse_number(basename(path))

  DBI::dbAppendTable(con, "gapminder", df)
}
Artık paths içindeki her öğe için append_file() fonksiyonunu bir kez çağırmamız gerekir. Bunu map() ile elbette yapabiliriz:
paths |> map(append_file)Ancak append_file() çıktısıyla ilgilenmediğimiz için map() yerine walk() kullanmak biraz daha uygundur. walk(), map() ile tamamen aynı işi yapar ancak çıktıyı atar:
paths |> walk(append_file)Artık tablomuzda tüm verilerin bulunup bulunmadığını görebiliriz:
26.4.2 CSV dosyaları yazma
Her grup için bir tane olmak üzere birden çok CSV dosyası yazmak istediğimizde de aynı temel ilke geçerlidir. ggplot2::diamonds verilerini alıp her clarity değeri için bir CSV dosyası kaydetmek istediğimizi düşünelim. Önce bu ayrı veri kümelerini oluşturmamız gerekir. Bunu yapmanın birçok yolu vardır; ancak özellikle sevdiğimiz yöntem group_nest() fonksiyonudur.
by_clarity <- diamonds |>
  group_nest(clarity)

by_clarity
#> # A tibble: 8 × 2
#>   clarity               data
#>   <ord>   <list<tibble[,9]>>
#> 1 I1               [741 × 9]
#> 2 SI2            [9,194 × 9]
#> 3 SI1           [13,065 × 9]
#> 4 VS2           [12,258 × 9]
#> 5 VS1            [8,171 × 9]
#> 6 VVS2           [5,066 × 9]
#> # ℹ 2 more rows
Bu bize sekiz satırlı ve iki sütunlu yeni bir tibble verir. clarity gruplama değişkenimizdir; data ise clarity değişkeninin her benzersiz değeri için bir tibble içeren liste sütunudur:
by_clarity$data[[1]]
#> # A tibble: 741 × 9
#>   carat cut       color depth table price     x     y     z
#>   <dbl> <ord>     <ord> <dbl> <dbl> <int> <dbl> <dbl> <dbl>
#> 1  0.32 Premium   E      60.9    58   345  4.38  4.42  2.68
#> 2  1.17 Very Good J      60.2    61  2774  6.83  6.9   4.13
#> 3  1.01 Premium   F      61.8    60  2781  6.39  6.36  3.94
#> 4  1.01 Fair      E      64.5    58  2788  6.29  6.21  4.03
#> 5  0.96 Ideal     F      60.7    55  2801  6.37  6.41  3.88
#> 6  1.04 Premium   G      62.2    58  2801  6.46  6.41  4
#> # ℹ 735 more rows
Buradayken mutate() ve str_glue() kullanarak çıktı dosyasının adını veren bir sütun oluşturalım:
by_clarity <- by_clarity |>
  mutate(path = str_glue("diamonds-{clarity}.csv"))

by_clarity
#> # A tibble: 8 × 3
#>   clarity               data path
#>   <ord>   <list<tibble[,9]>> <glue>
#> 1 I1               [741 × 9] diamonds-I1.csv
#> 2 SI2            [9,194 × 9] diamonds-SI2.csv
#> 3 SI1           [13,065 × 9] diamonds-SI1.csv
#> 4 VS2           [12,258 × 9] diamonds-VS2.csv
#> 5 VS1            [8,171 × 9] diamonds-VS1.csv
#> 6 VVS2           [5,066 × 9] diamonds-VVS2.csv
#> # ℹ 2 more rows
Bu veri çerçevelerini elle kaydedecek olsaydık şuna benzer bir kod yazabilirdik:
Bu, önceki map() kullanımlarımızdan biraz farklıdır; çünkü yalnızca bir değil, değişen iki argüman vardır. Bu nedenle hem ilk hem ikinci argümanı değiştiren yeni bir fonksiyona, map2() fonksiyonuna ihtiyacımız vardır. Yine çıktıyla ilgilenmediğimiz için map2() yerine walk2() isteriz. Sonuç şöyledir:
walk2(by_clarity$data, by_clarity$path, write_csv)26.4.3 Grafikleri kaydetme
Çok sayıda grafik oluşturmak için aynı temel yaklaşımı kullanabiliriz. Önce istediğimiz grafiği çizen bir fonksiyon oluşturalım:
carat_histogram <- function(df) {
  ggplot(df, aes(x = carat)) + geom_histogram(binwidth = 0.1)
}

carat_histogram(by_clarity$data[[1]])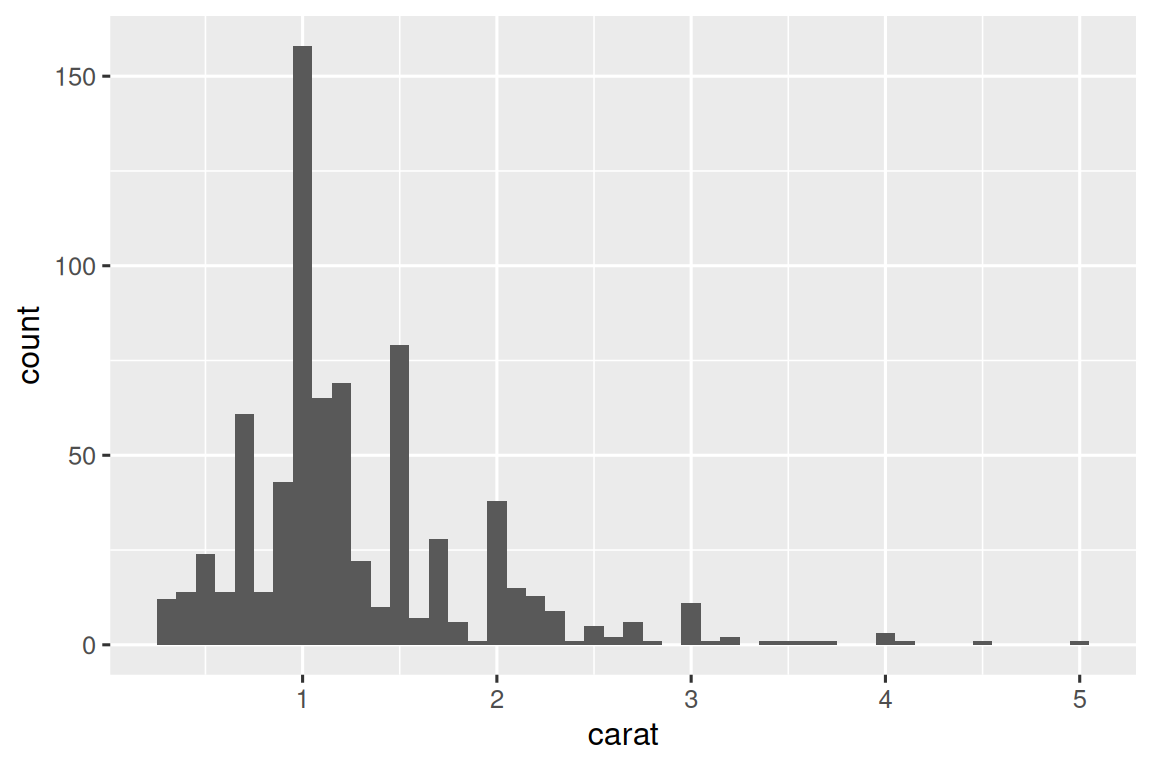
Artık çok sayıda grafikten7 ve bunların kaydedileceği dosya yollarından oluşan bir liste oluşturmak için map() kullanabiliriz:
Ardından her grafiği kaydetmek için ggsave() ile walk2() kullanın:
Bu, aşağıdakinin kısa yazımıdır:
26.5 Özet
Bu bölümde veri bilimi yaparken sık karşılaşılan üç problemi çözmek için açık iterasyonu nasıl kullanacağınızı gördünüz: birden çok sütunu işlemek, birden çok dosyayı okumak ve birden çok çıktıyı kaydetmek. Genel olarak iterasyon bir süper güçtür: Doğru iterasyon tekniğini biliyorsanız tek bir problemi çözmekten tüm problemleri çözmeye kolayca geçebilirsiniz. Bu bölümdeki tekniklerde ustalaştıktan sonra Advanced R kitabının Functionals bölümünü okuyarak ve purrr web sitesine başvurarak daha fazlasını öğrenmenizi önemle öneririz.
Diğer dillerdeki iterasyon hakkında çok şey biliyorsanız for döngüsünü ele almamamıza şaşırabilirsiniz. Bunun nedeni R’ın veri çözümleme yöneliminin iterasyon yapma biçimimizi değiştirmesidir: Çoğu durumda her sütun ya da grup üzerinde işlem yapmak için var olan bir kalıptan yararlanabilirsiniz. Bunu yapamadığınızda ise çoğu zaman listenin her öğesi üzerinde işlem yapan map() gibi bir fonksiyonel programlama aracını kullanabilirsiniz. Ancak doğal ortamında karşınıza çıkan kodlarda for döngülerini göreceksiniz; bu nedenle bazı önemli temel R araçlarını ele alacağımız sonraki bölümde bunları öğreneceksiniz.
Anonimdir; çünkü
<-ile ona açıkça bir ad vermedik. Programcıların bunun için kullandığı bir başka terim “lambda fonksiyonu”dur.↩︎Eski kodlarda
~ .x + 1biçiminde bir sözdizimi görebilirsiniz. Bu, anonim fonksiyon yazmanın başka bir yoludur; ancak yalnızca tidyverse fonksiyonları içinde çalışır ve her zaman.xdeğişken adını kullanır. Artık temel R sözdizimi olan\(x) x + 1kullanımını öneriyoruz.↩︎Şu anda sütunların sırasını doğrudan değiştiremezsiniz; ancak daha sonra
relocate()veya benzeri bir fonksiyonla yeniden sıralayabilirsiniz.↩︎Belki bir gün olacaktır; ancak şu anda nasıl yapılacağını göremiyoruz.↩︎
Bunun yerine aynı biçime sahip CSV dosyalarından oluşan bir dizininiz olsaydı Bölüm 7.4 bölümündeki tekniği kullanabilirdiniz.↩︎
Nasıl çalıştığını açıklamayacağız; ancak kullanılan fonksiyonların belgelerine bakarsanız çözebilmeniz gerekir.↩︎
Basit bir animasyon elde etmek için
by_clarity$plotnesnesini yazdırabilirsiniz;plotsiçindeki her öğe için bir grafik elde edersiniz. NOT: Bu bende gerçekleşmedi.↩︎