19 Birleştirmeler
19.1 Giriş
Bir veri analizinin yalnızca tek bir veri çerçevesi içermesi nadirdir. Genellikle birden çok veri çerçeveniz vardır ve ilgilendiğiniz soruları yanıtlamak için bunları birleştirmeniz gerekir. Bu bölüm iki önemli birleştirme türünü tanıtacak:
- Başka bir veri çerçevesindeki eşleşen gözlemlerden bir veri çerçevesine yeni değişkenler ekleyen dönüştürücü birleştirmeler.
- Bir veri çerçevesindeki gözlemleri başka bir veri çerçevesindeki gözlemle eşleşip eşleşmediklerine göre süzen filtreleyici birleştirmeler.
Bir birleştirmede iki veri çerçevesini bağlamak için kullanılan değişkenler olan anahtarları ele alarak başlayacağız. Kuramı nycflights13 paketindeki veri kümelerinin anahtarlarını inceleyerek pekiştirecek, ardından bu bilgiyi veri çerçevelerini birleştirmek için kullanacağız. Sonra satırlar üzerindeki etkilerine odaklanarak birleştirmelerin nasıl çalıştığını ele alacağız. Varsayılan eşitlik ilişkisinden daha esnek anahtar eşleştirme yöntemleri sunan eşitsizlik birleştirmeleri ailesini tartışarak bitireceğiz.
19.1.1 Ön koşullar
Bu bölümde dplyr’ın birleştirme fonksiyonlarını kullanarak nycflights13 paketindeki birbiriyle ilişkili beş veri kümesini inceleyeceğiz.
19.2 Anahtarlar
Birleştirmeleri anlamak için önce iki tablonun, her tablodaki birer anahtar aracılığıyla nasıl bağlanabildiğini anlamanız gerekir. Bu bölümde iki anahtar türünü öğrenecek ve nycflights13 paketinin veri kümelerinde her ikisinin örneklerini göreceksiniz. Ayrıca anahtarlarınızın geçerli olup olmadığını denetlemeyi ve tablonuzda anahtar yoksa ne yapacağınızı öğreneceksiniz.
19.2.1 Birincil ve yabancı anahtarlar
Her birleştirme bir anahtar çifti içerir: birincil anahtar ve yabancı anahtar. Birincil anahtar, her gözlemi benzersiz biçimde tanımlayan bir değişken veya değişken kümesidir. Birden çok değişken gerektiğinde anahtara bileşik anahtar denir. Örneğin nycflights13 içinde:
-
airlinesher hava yolu şirketi hakkında iki bilgi kaydeder: taşıyıcı kodu ve tam adı. Bir hava yolu şirketini iki harfli taşıyıcı koduyla tanımlayabilirsiniz; dolayısıylacarrierbirincil anahtardır.airlines #> # A tibble: 16 × 2 #> carrier name #> <chr> <chr> #> 1 9E Endeavor Air Inc. #> 2 AA American Airlines Inc. #> 3 AS Alaska Airlines Inc. #> 4 B6 JetBlue Airways #> 5 DL Delta Air Lines Inc. #> 6 EV ExpressJet Airlines Inc. #> # ℹ 10 more rows -
airportsher havaalanı hakkında veri kaydeder. Her havaalanını üç harfli koduyla tanımlayabilirsiniz; dolayısıylafaabirincil anahtardır.airports #> # A tibble: 1,458 × 8 #> faa name lat lon alt tz dst #> <chr> <chr> <dbl> <dbl> <dbl> <dbl> <chr> #> 1 04G Lansdowne Airport 41.1 -80.6 1044 -5 A #> 2 06A Moton Field Municipal Airport 32.5 -85.7 264 -6 A #> 3 06C Schaumburg Regional 42.0 -88.1 801 -6 A #> 4 06N Randall Airport 41.4 -74.4 523 -5 A #> 5 09J Jekyll Island Airport 31.1 -81.4 11 -5 A #> 6 0A9 Elizabethton Municipal Airpo… 36.4 -82.2 1593 -5 A #> # ℹ 1,452 more rows #> # ℹ 1 more variable: tzone <chr> -
planesher uçak hakkında veri kaydeder. Bir uçağı kuyruk numarasıyla tanımlayabilirsiniz; dolayısıylatailnumbirincil anahtardır.planes #> # A tibble: 3,322 × 9 #> tailnum year type manufacturer model engines #> <chr> <int> <chr> <chr> <chr> <int> #> 1 N10156 2004 Fixed wing multi… EMBRAER EMB-145XR 2 #> 2 N102UW 1998 Fixed wing multi… AIRBUS INDUSTR… A320-214 2 #> 3 N103US 1999 Fixed wing multi… AIRBUS INDUSTR… A320-214 2 #> 4 N104UW 1999 Fixed wing multi… AIRBUS INDUSTR… A320-214 2 #> 5 N10575 2002 Fixed wing multi… EMBRAER EMB-145LR 2 #> 6 N105UW 1999 Fixed wing multi… AIRBUS INDUSTR… A320-214 2 #> # ℹ 3,316 more rows #> # ℹ 3 more variables: seats <int>, speed <int>, engine <chr> -
weatherkalkış havaalanlarındaki hava durumu verilerini kaydeder. Her gözlemi konum ve zaman birleşimiyle tanımlayabilirsiniz; dolayısıylaoriginvetime_hourbileşik birincil anahtardır.weather #> # A tibble: 26,115 × 15 #> origin year month day hour temp dewp humid wind_dir #> <chr> <int> <int> <int> <int> <dbl> <dbl> <dbl> <dbl> #> 1 EWR 2013 1 1 1 39.0 26.1 59.4 270 #> 2 EWR 2013 1 1 2 39.0 27.0 61.6 250 #> 3 EWR 2013 1 1 3 39.0 28.0 64.4 240 #> 4 EWR 2013 1 1 4 39.9 28.0 62.2 250 #> 5 EWR 2013 1 1 5 39.0 28.0 64.4 260 #> 6 EWR 2013 1 1 6 37.9 28.0 67.2 240 #> # ℹ 26,109 more rows #> # ℹ 6 more variables: wind_speed <dbl>, wind_gust <dbl>, …
Yabancı anahtar, başka bir tablodaki birincil anahtara karşılık gelen değişken ya da değişken kümesidir. Örneğin:
-
flights$tailnum,planes$tailnumbirincil anahtarına karşılık gelen yabancı anahtardır. -
flights$carrier,airlines$carrierbirincil anahtarına karşılık gelen yabancı anahtardır. -
flights$origin,airports$faabirincil anahtarına karşılık gelen yabancı anahtardır. -
flights$dest,airports$faabirincil anahtarına karşılık gelen yabancı anahtardır. -
flights$origin-flights$time_hour,weather$origin-weather$time_hourbileşik birincil anahtarına karşılık gelen bileşik yabancı anahtardır.
Bu ilişkiler Şekil 19.1 üzerinde görsel olarak özetlenmiştir.
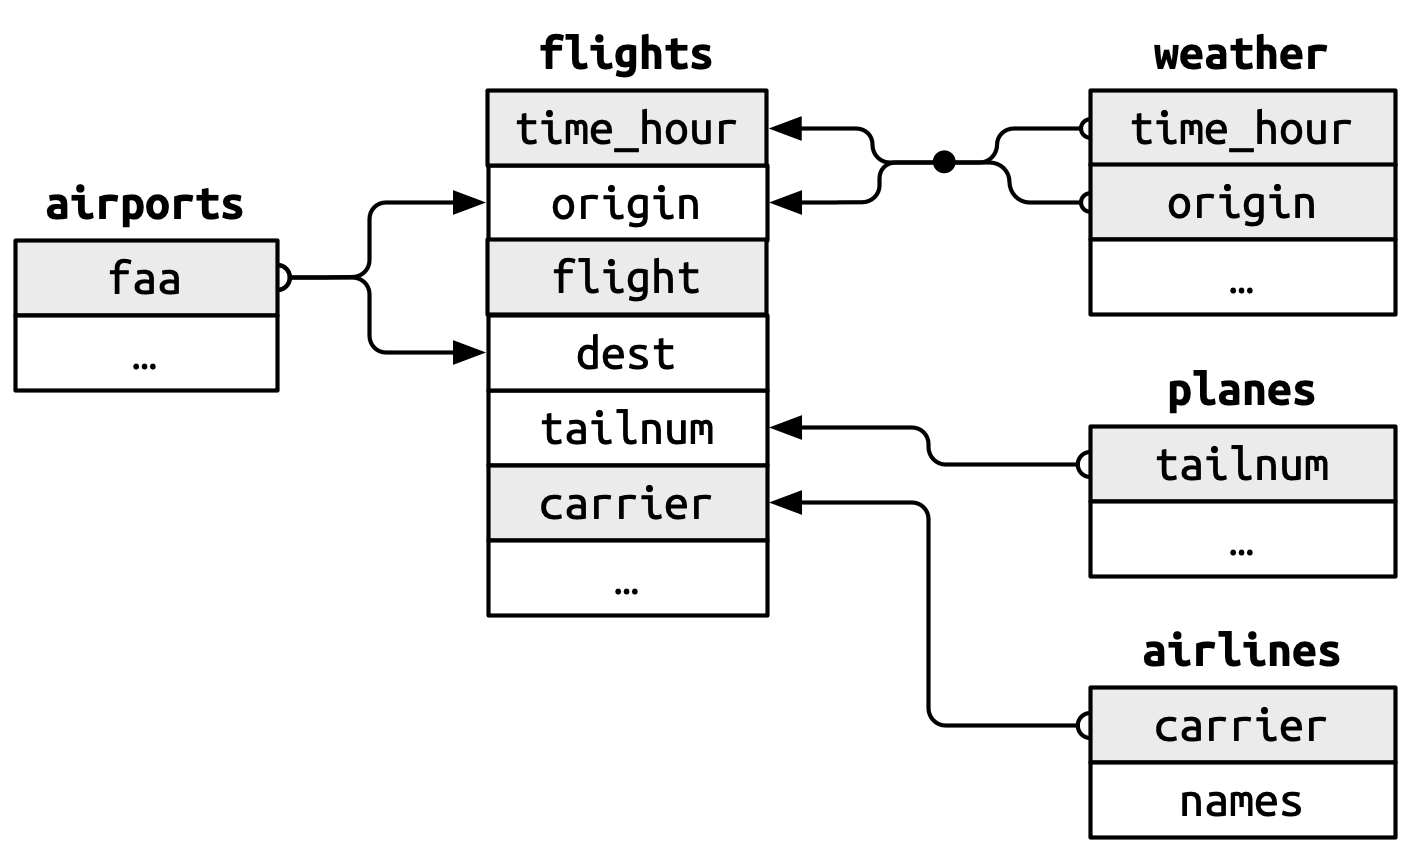
Bu anahtarların tasarımında güzel bir özellik fark edeceksiniz: Birincil ve yabancı anahtarlar neredeyse her zaman aynı adlara sahiptir; birazdan göreceğiniz gibi bu, birleştirme işlerinizi çok kolaylaştırır. Ters yöndeki ilişkiyi de belirtmekte yarar var: Birden çok tabloda kullanılan neredeyse her değişken adı her yerde aynı anlama gelir. Yalnızca bir istisna vardır: year, flights içinde kalkış yılını, planes içinde üretim yılını belirtir. Tabloları gerçekten birleştirmeye başladığımızda bu önemli olacaktır.
19.2.2 Birincil anahtarları denetleme
Her tablodaki birincil anahtarları belirlediğimize göre her gözlemi gerçekten benzersiz biçimde tanımladıklarını doğrulamak iyi bir uygulamadır. Bunun bir yolu birincil anahtarları count() ile sayıp n değerinin birden büyük olduğu girdileri aramaktır. Bu işlem hem planes hem de weather verisinin sorunsuz göründüğünü ortaya çıkarır:
Birincil anahtarlarınızdaki eksik değerleri de denetlemelisiniz; bir değer eksikse gözlemi tanımlayamaz!
planes |>
  filter(is.na(tailnum))
#> # A tibble: 0 × 9
#> # ℹ 9 variables: tailnum <chr>, year <int>, type <chr>, manufacturer <chr>,
#> #   model <chr>, engines <int>, seats <int>, speed <int>, engine <chr>

weather |>
  filter(is.na(time_hour) | is.na(origin))
#> # A tibble: 0 × 15
#> # ℹ 15 variables: origin <chr>, year <int>, month <int>, day <int>,
#> #   hour <int>, temp <dbl>, dewp <dbl>, humid <dbl>, wind_dir <dbl>, …
19.2.3 Vekil anahtarlar
Şimdiye kadar flights verisinin birincil anahtarından söz etmedik. Onu yabancı anahtar olarak kullanan veri çerçevesi bulunmadığı için burada çok önemli değildir; ancak gözlemleri başkalarına tanımlayabileceğimiz bir yol olduğunda onlarla çalışmak kolaylaştığından yine de düşünmeye değerdir.
Biraz düşünüp deneme yaptıktan sonra her uçuşu birlikte benzersiz biçimde tanımlayan üç değişken bulunduğunu belirledik:
Yinelenen değerlerin bulunmaması time_hour-carrier-flight birleşimini otomatik olarak birincil anahtar yapar mı? Bu kesinlikle iyi bir başlangıçtır ancak yeterli değildir. Örneğin rakım ve enlem airports için iyi bir birincil anahtar mıdır?
Bir havaalanını rakımı ve enlemiyle tanımlamak açıkça kötü bir fikirdir; genel olarak bir değişken birleşiminin iyi bir birincil anahtar olup olmadığını yalnızca verilerden anlamak mümkün değildir. Ancak uçuşlarda time_hour, carrier ve flight birleşimi makul görünür; çünkü aynı uçuş numarasına sahip birden çok uçuşun aynı anda havada olması hava yolu şirketi ve müşterileri için gerçekten kafa karıştırıcı olurdu.
Bununla birlikte satır numarasını kullanarak basit ve sayısal bir vekil anahtar eklemek daha iyi olabilir:
flights2 <- flights |>
  mutate(id = row_number(), .before = 1)
flights2
#> # A tibble: 336,776 × 20
#>      id  year month   day dep_time sched_dep_time dep_delay arr_time
#>   <int> <int> <int> <int>    <int>          <int>     <dbl>    <int>
#> 1     1  2013     1     1      517            515         2      830
#> 2     2  2013     1     1      533            529         4      850
#> 3     3  2013     1     1      542            540         2      923
#> 4     4  2013     1     1      544            545        -1     1004
#> 5     5  2013     1     1      554            600        -6      812
#> 6     6  2013     1     1      554            558        -4      740
#> # ℹ 336,770 more rows
#> # ℹ 12 more variables: sched_arr_time <int>, arr_delay <dbl>, …
Vekil anahtarlar diğer insanlarla iletişim kurarken özellikle yararlı olabilir: Birine 2013-01-03 tarihinde saat 09.00’da kalkan UA430’a bakmasını söylemektense 2001 numaralı uçuşa bakmasını söylemek çok daha kolaydır.
19.2.4 Alıştırmalar
Şekil 19.1 üzerinde
weatherileairportsarasındaki ilişkiyi çizmeyi unuttuk. Bu ilişki nedir ve diyagramda nasıl görünmelidir?weatheryalnızca New York’taki üç kalkış havaalanına ilişkin bilgi içerir. ABD’deki tüm havaalanlarının hava durumu kayıtlarını içerseydiflightsile hangi ek bağlantıyı kurardı?year,month,day,hourveorigindeğişkenleriweatheriçin neredeyse bileşik bir anahtar oluşturur ancak bir saatte yinelenen gözlemler vardır. Bu saatin özelliğini bulabilir misiniz?Yılın bazı günlerinin özel olduğunu ve bu günlerde normalden daha az kişinin uçtuğunu biliyoruz (ör. Noel arifesi ve Noel günü). Bu verileri bir veri çerçevesi olarak nasıl gösterebilirsiniz? Birincil anahtar ne olurdu? Mevcut veri çerçevelerine nasıl bağlanırdı?
Lahman paketindeki
Batting,PeopleveSalariesveri çerçeveleri arasındaki bağlantıları gösteren bir diyagram çizin.People,ManagersveAwardsManagersarasındaki ilişkiyi gösteren başka bir diyagram çizin.Batting,PitchingveFieldingveri çerçeveleri arasındaki ilişkiyi nasıl tanımlarsınız?
19.3 Temel birleştirmeler
Veri çerçevelerinin anahtarlar aracılığıyla nasıl bağlandığını anladığınıza göre flights veri kümesini daha iyi anlamak için birleştirmeleri kullanmaya başlayabiliriz. dplyr altı birleştirme fonksiyonu sağlar: left_join(), inner_join(), right_join(), full_join(), semi_join() ve anti_join(). Hepsi aynı arayüze sahiptir: Bir veri çerçevesi çifti (x ve y) alıp bir veri çerçevesi döndürür. Çıktıdaki satır ve sütunların sırasını esas olarak x belirler.
Bu bölümde bir dönüştürücü birleştirme olan left_join() ile iki filtreleyici birleştirme olan semi_join() ve anti_join() kullanımını öğreneceksiniz. Sonraki bölümde bu fonksiyonların tam olarak nasıl çalıştığını ve kalan inner_join(), right_join() ile full_join() fonksiyonlarını öğreneceksiniz.
19.3.1 Dönüştürücü birleştirmeler
Dönüştürücü birleştirme, iki veri çerçevesindeki değişkenleri birleştirmenizi sağlar: Önce gözlemleri anahtarlarına göre eşleştirir, ardından değişkenleri bir veri çerçevesinden diğerine kopyalar. Birleştirme fonksiyonları mutate() gibi değişkenleri sağa eklediğinden veri kümenizde çok sayıda değişken varsa yenilerini göremezsiniz. Bu örneklerde yalnızca altı değişken içeren daha dar bir veri kümesi oluşturarak neler olduğunu görmeyi kolaylaştıracağız1:
flights2 <- flights |>
  select(year, time_hour, origin, dest, tailnum, carrier)
flights2
#> # A tibble: 336,776 × 6
#>    year time_hour           origin dest  tailnum carrier
#>   <int> <dttm>              <chr>  <chr> <chr>   <chr>
#> 1  2013 2013-01-01 05:00:00 EWR    IAH   N14228  UA
#> 2  2013 2013-01-01 05:00:00 LGA    IAH   N24211  UA
#> 3  2013 2013-01-01 05:00:00 JFK    MIA   N619AA  AA
#> 4  2013 2013-01-01 05:00:00 JFK    BQN   N804JB  B6
#> 5  2013 2013-01-01 06:00:00 LGA    ATL   N668DN  DL
#> 6  2013 2013-01-01 05:00:00 EWR    ORD   N39463  UA
#> # ℹ 336,770 more rows
Dört tür dönüştürücü birleştirme vardır ancak neredeyse her zaman kullanacağınız bir tanesi öne çıkar: left_join(). Özeldir; çünkü çıktı her zaman üzerine birleştirme yaptığınız x veri çerçevesiyle aynı satırlara sahip olur2. left_join() fonksiyonunun temel kullanım amacı ek üst veri eklemektir. Örneğin flights2 verisine hava yolu şirketinin tam adını eklemek için left_join() kullanabiliriz:
flights2 |>
  left_join(airlines)
#> Joining with `by = join_by(carrier)`
#> # A tibble: 336,776 × 7
#>    year time_hour           origin dest  tailnum carrier name
#>   <int> <dttm>              <chr>  <chr> <chr>   <chr>   <chr>
#> 1  2013 2013-01-01 05:00:00 EWR    IAH   N14228  UA      United Air Lines In…
#> 2  2013 2013-01-01 05:00:00 LGA    IAH   N24211  UA      United Air Lines In…
#> 3  2013 2013-01-01 05:00:00 JFK    MIA   N619AA  AA      American Airlines I…
#> 4  2013 2013-01-01 05:00:00 JFK    BQN   N804JB  B6      JetBlue Airways
#> 5  2013 2013-01-01 06:00:00 LGA    ATL   N668DN  DL      Delta Air Lines Inc.
#> 6  2013 2013-01-01 05:00:00 EWR    ORD   N39463  UA      United Air Lines In…
#> # ℹ 336,770 more rows
Ya da her uçak kalktığında sıcaklığı ve rüzgâr hızını bulabiliriz:
flights2 |>
  left_join(weather |> select(origin, time_hour, temp, wind_speed))
#> Joining with `by = join_by(time_hour, origin)`
#> # A tibble: 336,776 × 8
#>    year time_hour           origin dest  tailnum carrier  temp wind_speed
#>   <int> <dttm>              <chr>  <chr> <chr>   <chr>   <dbl>      <dbl>
#> 1  2013 2013-01-01 05:00:00 EWR    IAH   N14228  UA       39.0       12.7
#> 2  2013 2013-01-01 05:00:00 LGA    IAH   N24211  UA       39.9       15.0
#> 3  2013 2013-01-01 05:00:00 JFK    MIA   N619AA  AA       39.0       15.0
#> 4  2013 2013-01-01 05:00:00 JFK    BQN   N804JB  B6       39.0       15.0
#> 5  2013 2013-01-01 06:00:00 LGA    ATL   N668DN  DL       39.9       16.1
#> 6  2013 2013-01-01 05:00:00 EWR    ORD   N39463  UA       39.0       12.7
#> # ℹ 336,770 more rows
Veya uçan uçağın boyutunu öğrenebiliriz:
flights2 |>
  left_join(planes |> select(tailnum, type, engines, seats))
#> Joining with `by = join_by(tailnum)`
#> # A tibble: 336,776 × 9
#>    year time_hour           origin dest  tailnum carrier type
#>   <int> <dttm>              <chr>  <chr> <chr>   <chr>   <chr>
#> 1  2013 2013-01-01 05:00:00 EWR    IAH   N14228  UA      Fixed wing multi en…
#> 2  2013 2013-01-01 05:00:00 LGA    IAH   N24211  UA      Fixed wing multi en…
#> 3  2013 2013-01-01 05:00:00 JFK    MIA   N619AA  AA      Fixed wing multi en…
#> 4  2013 2013-01-01 05:00:00 JFK    BQN   N804JB  B6      Fixed wing multi en…
#> 5  2013 2013-01-01 06:00:00 LGA    ATL   N668DN  DL      Fixed wing multi en…
#> 6  2013 2013-01-01 05:00:00 EWR    ORD   N39463  UA      Fixed wing multi en…
#> # ℹ 336,770 more rows
#> # ℹ 2 more variables: engines <int>, seats <int>left_join(), x içindeki bir satır için eşleşme bulamadığında yeni değişkenleri eksik değerlerle doldurur. Örneğin N3ALAA kuyruk numaralı uçak hakkında bilgi olmadığından type, engines ve seats eksik olacaktır:
flights2 |>
  filter(tailnum == "N3ALAA") |>
  left_join(planes |> select(tailnum, type, engines, seats))
#> Joining with `by = join_by(tailnum)`
#> # A tibble: 63 × 9
#>    year time_hour           origin dest  tailnum carrier type  engines seats
#>   <int> <dttm>              <chr>  <chr> <chr>   <chr>   <chr>   <int> <int>
#> 1  2013 2013-01-01 06:00:00 LGA    ORD   N3ALAA  AA      <NA>       NA    NA
#> 2  2013 2013-01-02 18:00:00 LGA    ORD   N3ALAA  AA      <NA>       NA    NA
#> 3  2013 2013-01-03 06:00:00 LGA    ORD   N3ALAA  AA      <NA>       NA    NA
#> 4  2013 2013-01-07 19:00:00 LGA    ORD   N3ALAA  AA      <NA>       NA    NA
#> 5  2013 2013-01-08 17:00:00 JFK    ORD   N3ALAA  AA      <NA>       NA    NA
#> 6  2013 2013-01-16 06:00:00 LGA    ORD   N3ALAA  AA      <NA>       NA    NA
#> # ℹ 57 more rows
Bölümün geri kalanında bu soruna birkaç kez döneceğiz.
19.3.2 Birleştirme anahtarlarını belirtme
left_join() varsayılan olarak iki veri çerçevesinde de bulunan tüm değişkenleri birleştirme anahtarı olarak kullanır; buna doğal birleştirme denir. Bu yararlı bir sezgisel yöntemdir ancak her zaman işe yaramaz. Örneğin flights2 ile eksiksiz planes veri kümesini birleştirmeye çalışırsak ne olur?
flights2 |>
  left_join(planes)
#> Joining with `by = join_by(year, tailnum)`
#> # A tibble: 336,776 × 13
#>    year time_hour           origin dest  tailnum carrier type  manufacturer
#>   <int> <dttm>              <chr>  <chr> <chr>   <chr>   <chr> <chr>
#> 1  2013 2013-01-01 05:00:00 EWR    IAH   N14228  UA      <NA>  <NA>
#> 2  2013 2013-01-01 05:00:00 LGA    IAH   N24211  UA      <NA>  <NA>
#> 3  2013 2013-01-01 05:00:00 JFK    MIA   N619AA  AA      <NA>  <NA>
#> 4  2013 2013-01-01 05:00:00 JFK    BQN   N804JB  B6      <NA>  <NA>
#> 5  2013 2013-01-01 06:00:00 LGA    ATL   N668DN  DL      <NA>  <NA>
#> 6  2013 2013-01-01 05:00:00 EWR    ORD   N39463  UA      <NA>  <NA>
#> # ℹ 336,770 more rows
#> # ℹ 5 more variables: model <chr>, engines <int>, seats <int>, …
Birleştirmemiz tailnum ve year değişkenlerini bileşik anahtar olarak kullanmaya çalıştığı için çok sayıda eksik eşleşme elde ederiz. Hem flights hem de planes bir year sütununa sahiptir ancak bunlar farklı anlamlara gelir: flights$year uçuşun gerçekleştiği, planes$year ise uçağın üretildiği yıldır. Yalnızca tailnum üzerinden birleştirmek istediğimiz için join_by() ile açık bir belirtim sağlamamız gerekir:
flights2 |>
  left_join(planes, join_by(tailnum))
#> # A tibble: 336,776 × 14
#>   year.x time_hour           origin dest  tailnum carrier year.y
#>    <int> <dttm>              <chr>  <chr> <chr>   <chr>    <int>
#> 1   2013 2013-01-01 05:00:00 EWR    IAH   N14228  UA        1999
#> 2   2013 2013-01-01 05:00:00 LGA    IAH   N24211  UA        1998
#> 3   2013 2013-01-01 05:00:00 JFK    MIA   N619AA  AA        1990
#> 4   2013 2013-01-01 05:00:00 JFK    BQN   N804JB  B6        2012
#> 5   2013 2013-01-01 06:00:00 LGA    ATL   N668DN  DL        1991
#> 6   2013 2013-01-01 05:00:00 EWR    ORD   N39463  UA        2012
#> # ℹ 336,770 more rows
#> # ℹ 7 more variables: type <chr>, manufacturer <chr>, model <chr>, …
Çıktıda year değişkenlerinin, değişkenin x mi yoksa y argümanından mı geldiğini belirten bir sonekle (year.x ve year.y) ayırt edildiğine dikkat edin. Varsayılan sonekleri suffix argümanıyla geçersiz kılabilirsiniz.
join_by(tailnum), join_by(tailnum == tailnum) ifadesinin kısa biçimidir. Bu uzun biçimi iki nedenle bilmek önemlidir. İlk olarak iki tablo arasındaki ilişkiyi tanımlar: Anahtarlar eşit olmalıdır. Bu nedenle bu birleştirme türüne çoğunlukla eşitlik birleştirmesi denir. Eşitsizlik birleştirmelerini Bölüm 19.5 bölümünde öğreneceksiniz.
İkinci olarak her tabloda farklı birleştirme anahtarlarını bu biçimde belirtirsiniz. Örneğin flight2 ve airports tablolarını dest ya da origin üzerinden iki şekilde birleştirebilirsiniz:
flights2 |>
  left_join(airports, join_by(dest == faa))
#> # A tibble: 336,776 × 13
#>    year time_hour           origin dest  tailnum carrier name
#>   <int> <dttm>              <chr>  <chr> <chr>   <chr>   <chr>
#> 1  2013 2013-01-01 05:00:00 EWR    IAH   N14228  UA      George Bush Interco…
#> 2  2013 2013-01-01 05:00:00 LGA    IAH   N24211  UA      George Bush Interco…
#> 3  2013 2013-01-01 05:00:00 JFK    MIA   N619AA  AA      Miami Intl
#> 4  2013 2013-01-01 05:00:00 JFK    BQN   N804JB  B6      <NA>
#> 5  2013 2013-01-01 06:00:00 LGA    ATL   N668DN  DL      Hartsfield Jackson …
#> 6  2013 2013-01-01 05:00:00 EWR    ORD   N39463  UA      Chicago Ohare Intl
#> # ℹ 336,770 more rows
#> # ℹ 6 more variables: lat <dbl>, lon <dbl>, alt <dbl>, tz <dbl>, …

flights2 |>
  left_join(airports, join_by(origin == faa))
#> # A tibble: 336,776 × 13
#>    year time_hour           origin dest  tailnum carrier name
#>   <int> <dttm>              <chr>  <chr> <chr>   <chr>   <chr>
#> 1  2013 2013-01-01 05:00:00 EWR    IAH   N14228  UA      Newark Liberty Intl
#> 2  2013 2013-01-01 05:00:00 LGA    IAH   N24211  UA      La Guardia
#> 3  2013 2013-01-01 05:00:00 JFK    MIA   N619AA  AA      John F Kennedy Intl
#> 4  2013 2013-01-01 05:00:00 JFK    BQN   N804JB  B6      John F Kennedy Intl
#> 5  2013 2013-01-01 06:00:00 LGA    ATL   N668DN  DL      La Guardia
#> 6  2013 2013-01-01 05:00:00 EWR    ORD   N39463  UA      Newark Liberty Intl
#> # ℹ 336,770 more rows
#> # ℹ 6 more variables: lat <dbl>, lon <dbl>, alt <dbl>, tz <dbl>, …
Eski kodlarda birleştirme anahtarlarının karakter vektörüyle belirtildiği farklı bir yöntem görebilirsiniz:
-
by = "x",join_by(x)ifadesine karşılık gelir. -
by = c("a" = "x"),join_by(a == x)ifadesine karşılık gelir.
Artık mevcut olduğuna göre daha açık ve esnek bir belirtim sunduğu için join_by() fonksiyonunu tercih ediyoruz.
inner_join(), right_join() ve full_join(), left_join() ile aynı arayüze sahiptir. Aralarındaki fark korudukları satırlardır: Sol birleştirme x içindeki, sağ birleştirme y içindeki, tam birleştirme x veya y içindeki tüm satırları; iç birleştirme ise yalnızca hem x hem de y içinde bulunan satırları korur. Bu konuya daha sonra ayrıntılı olarak döneceğiz.
19.3.3 Filtreleyici birleştirmeler
Tahmin edebileceğiniz gibi filtreleyici birleştirmenin temel işi satırları süzmektir. İki türü vardır: yarı birleştirmeler ve karşıt birleştirmeler. Yarı birleştirmeler, x içinde olup y içinde eşleşmesi bulunan tüm satırları korur. Örneğin airports veri kümesini yalnızca kalkış havaalanlarını gösterecek biçimde süzmek için yarı birleştirme kullanabiliriz:
airports |>
  semi_join(flights2, join_by(faa == origin))
#> # A tibble: 3 × 8
#>   faa   name                  lat   lon   alt    tz dst   tzone
#>   <chr> <chr>               <dbl> <dbl> <dbl> <dbl> <chr> <chr>
#> 1 EWR   Newark Liberty Intl  40.7 -74.2    18    -5 A     America/New_York
#> 2 JFK   John F Kennedy Intl  40.6 -73.8    13    -5 A     America/New_York
#> 3 LGA   La Guardia           40.8 -73.9    22    -5 A     America/New_York
Ya da yalnızca varış havaalanlarını:
airports |>
  semi_join(flights2, join_by(faa == dest))
#> # A tibble: 101 × 8
#>   faa   name                     lat    lon   alt    tz dst   tzone
#>   <chr> <chr>                  <dbl>  <dbl> <dbl> <dbl> <chr> <chr>
#> 1 ABQ   Albuquerque Internati…  35.0 -107.   5355    -7 A     America/Denver
#> 2 ACK   Nantucket Mem           41.3  -70.1    48    -5 A     America/New_Yo…
#> 3 ALB   Albany Intl             42.7  -73.8   285    -5 A     America/New_Yo…
#> 4 ANC   Ted Stevens Anchorage…  61.2 -150.    152    -9 A     America/Anchor…
#> 5 ATL   Hartsfield Jackson At…  33.6  -84.4  1026    -5 A     America/New_Yo…
#> 6 AUS   Austin Bergstrom Intl   30.2  -97.7   542    -6 A     America/Chicago
#> # ℹ 95 more rows
Karşıt birleştirmeler bunun tersidir: x içinde olup y içinde eşleşmesi bulunmayan tüm satırları döndürür. Bölüm 18.3 bölümünün konusu olan, verilerde örtük biçimde eksik değerleri bulmak için yararlıdır. Örtük eksik değerler NA olarak görünmez, yalnızca yokluklarıyla var olur. Örneğin eşleşen varış havaalanı bulunmayan uçuşlara bakarak airports içinde eksik satırları bulabiliriz:
Ya da hangi tailnum değerlerinin planes içinde eksik olduğunu bulabiliriz:
19.3.4 Alıştırmalar
Yıl boyunca en kötü gecikmelerin yaşandığı 48 saati bulun. Bunu
weatherverileriyle karşılaştırın. Herhangi bir örüntü görüyor musunuz?-
Aşağıdaki kodla en popüler 10 varış noktasını bulduğunuzu düşünün:
Bu varış noktalarına giden tüm uçuşları nasıl bulabilirsiniz?
Her kalkan uçuş için o saate karşılık gelen hava durumu verisi var mı?
planesiçinde eşleşen kaydı bulunmayan kuyruk numaralarının ortak özelliği nedir? (İpucu: Sorunların yaklaşık %90’ını tek bir değişken açıklar.)planesverisine, her uçağı uçurmuş olan tümcarrierdeğerlerini listeleyen bir sütun ekleyin. Her uçak tek bir hava yolu şirketi tarafından uçurulduğu için uçak ile hava yolu arasında örtük bir ilişki olmasını bekleyebilirsiniz. Önceki bölümlerde öğrendiğiniz araçlarla bu hipotezi doğrulayın veya reddedin.flightsverisine hem kalkış hem de varış havaalanlarının enlem ve boylamını ekleyin. Sütunları birleştirmeden önce mi sonra mı yeniden adlandırmak daha kolaydır?-
Varış noktasına göre ortalama gecikmeyi hesaplayın, ardından gecikmelerin uzamsal dağılımını gösterebilmek için
airportsveri çerçevesiyle birleştirin. ABD haritasını çizmenin kolay bir yolu şöyledir:airports |> semi_join(flights, join_by(faa == dest)) |> ggplot(aes(x = lon, y = lat)) + borders("state") + geom_point() + coord_quickmap()Her havaalanının ortalama gecikmesini göstermek için noktaların
sizeveyacolorözelliğini kullanabilirsiniz. 13 Haziran 2013’te ne oldu? Gecikmelerin haritasını çizin ve ardından hava durumuyla karşılaştırmak için Google’ı kullanın.
19.4 Birleştirmeler nasıl çalışır?
Birleştirmeleri birkaç kez kullandığınıza göre x içindeki her satırın y içindeki satırlarla nasıl eşleştiğine odaklanarak çalışma biçimleri hakkında daha fazla bilgi edinmenin zamanı geldi. Aşağıda tanımlanan ve Şekil 19.2 üzerinde gösterilen basit tibble’ları kullanarak birleştirmelerin görsel gösterimini tanıtmakla başlayacağız. Bu örneklerde key adlı tek bir anahtar ve tek bir değer sütunu (val_x ile val_y) kullanacağız ancak fikirlerin tümü birden çok anahtar ve değere genellenebilir.
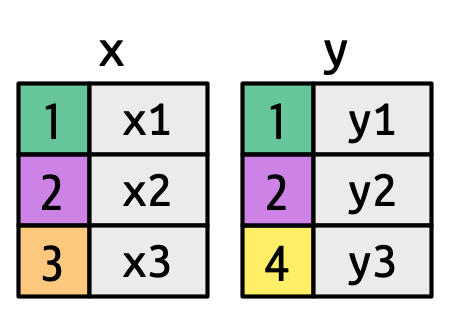
key sütunları arka plan rengini anahtar değerine eşler. Gri sütunlar birleştirmeye eşlik eden “değer” sütunlarını temsil eder.
Şekil 19.3 görsel gösterimimizin temelini tanıtır. x ve y arasındaki tüm olası eşleşmeleri, x ve y içindeki her satırdan çizilen çizgilerin kesişimi olarak gösterir. Çıktıdaki satır ve sütunları esas olarak x belirlediğinden x tablosu yataydır ve çıktıyla hizalanır.
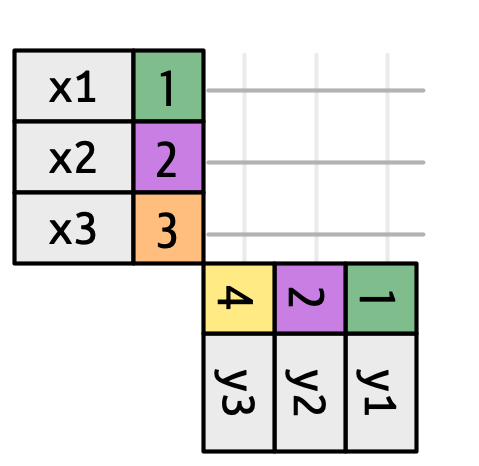
Belirli bir birleştirme türünü açıklamak için eşleşmeleri noktalarla gösteririz. Eşleşmeler anahtarı, x değerlerini ve y değerlerini içeren yeni veri çerçevesindeki çıktı satırlarını belirler. Örneğin Şekil 19.4, satırların yalnızca anahtarlar eşitse korunduğu bir iç birleştirmeyi gösterir.
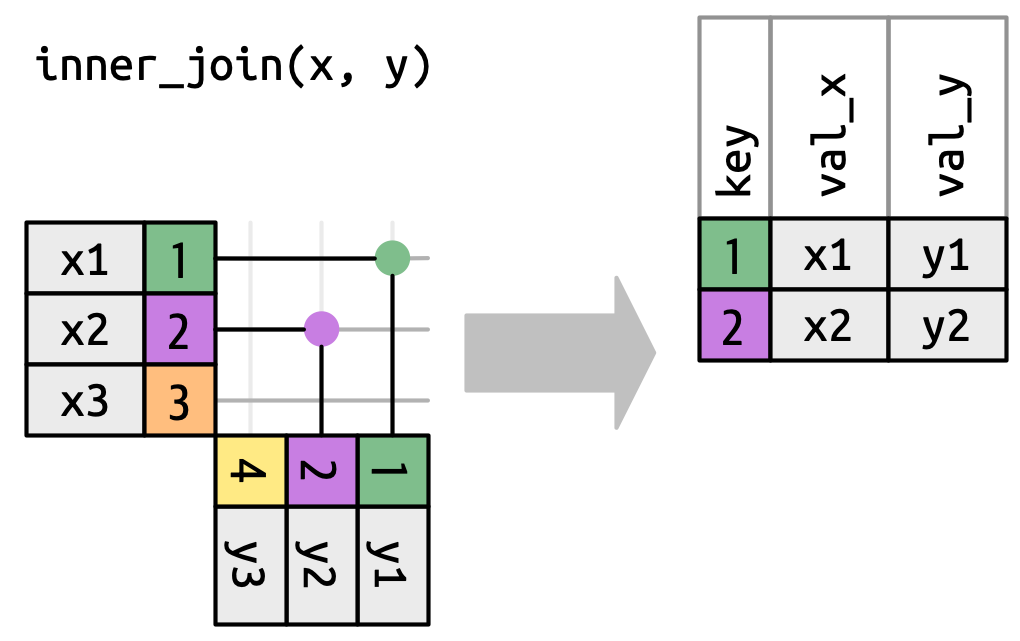
x içindeki her satırı y içinde aynı key değerine sahip satırla eşleştirir. Her eşleşme çıktıda bir satır olur.
En az bir veri çerçevesinde görünen gözlemleri koruyan dış birleştirmeleri açıklamak için aynı ilkeleri uygulayabiliriz. Bu birleştirmeler her veri çerçevesine ek bir “sanal” gözlem ekleyerek çalışır. Bu gözlem, başka hiçbir anahtar eşleşmediğinde eşleşen bir anahtara ve NA ile doldurulmuş değerlere sahiptir. Üç tür dış birleştirme vardır:
-
Sol birleştirme,
xiçindeki tüm gözlemleri korur (Şekil 19.5).xiçindeki her satır, gerekirseyiçindekiNAsatırıyla eşleşebildiği için çıktıda korunur.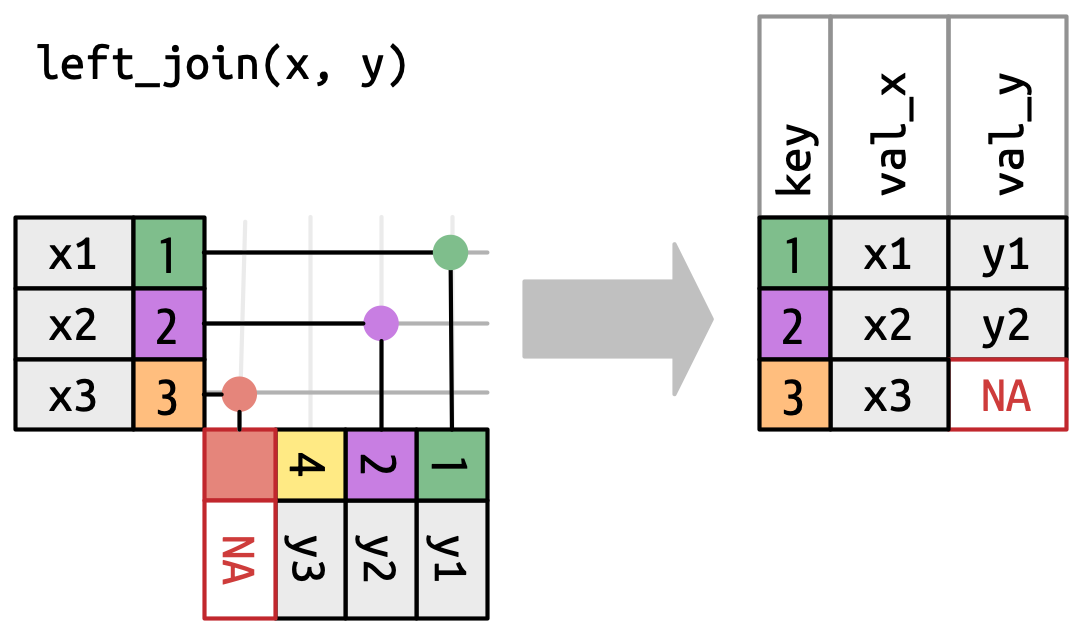
Şekil 19.5: xiçindeki her satırın çıktıda yer aldığı sol birleştirmenin görsel gösterimi. -
Sağ birleştirme,
yiçindeki tüm gözlemleri korur (Şekil 19.6).yiçindeki her satır, gerekirsexiçindekiNAsatırıyla eşleşebildiği için çıktıda korunur. Çıktı yine mümkün olduğuncaxile eşleşir;yiçindeki ek satırlar sona eklenir.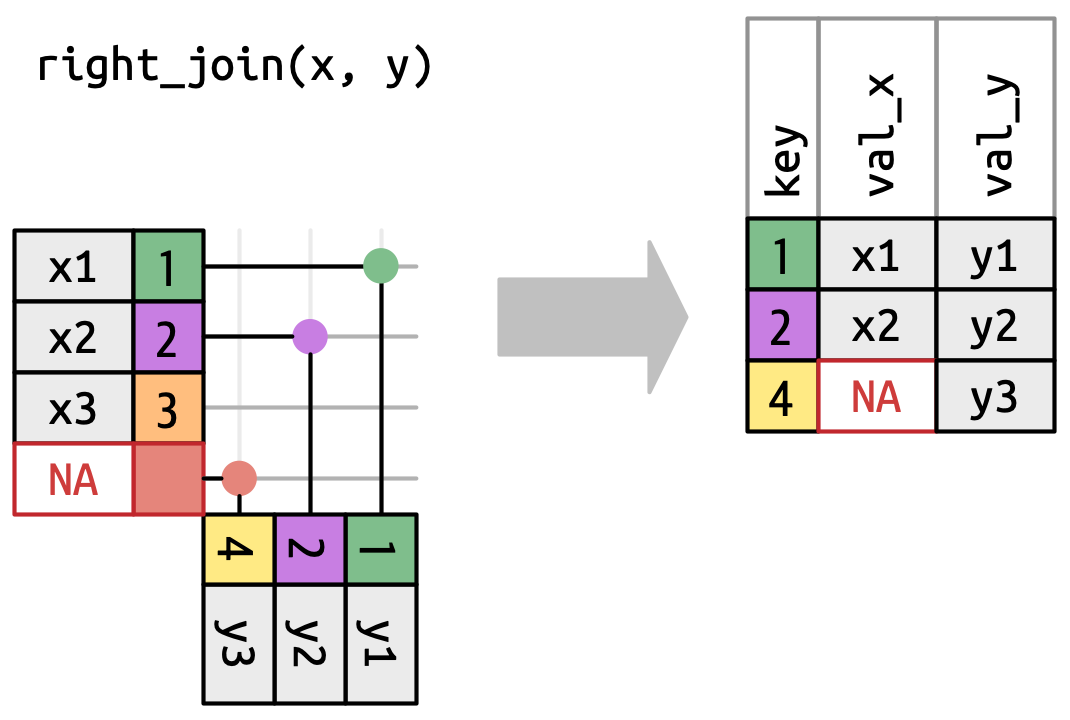
Şekil 19.6: yiçindeki her satırın çıktıda yer aldığı sağ birleştirmenin görsel gösterimi. -
Tam birleştirme,
xveyayiçinde görünen tüm gözlemleri korur (Şekil 19.7). Hemxhem dey, gerektiğinde eşleşecek birNAsatırına sahip olduğundan ikisindeki her satır çıktıya eklenir. Çıktı yinexiçindeki tüm satırlarla başlar ve eşleşmeyenysatırlarıyla devam eder.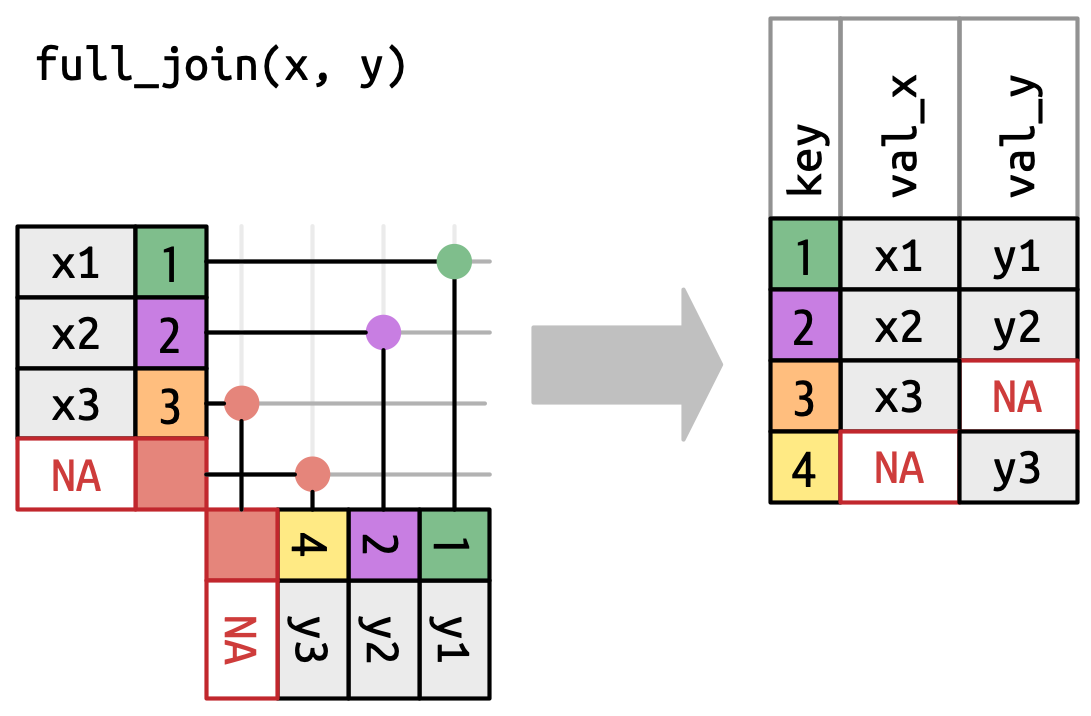
Şekil 19.7: xveyiçindeki her satırın çıktıda yer aldığı tam birleştirmenin görsel gösterimi.
Dış birleştirme türlerinin farkını göstermenin bir başka yolu Şekil 19.8 üzerindeki gibi Venn diyagramı kullanmaktır. Ancak hangi satırların korunduğunu anımsatsa da sütunlara ne olduğunu gösteremediği için bu çok iyi bir gösterim değildir.
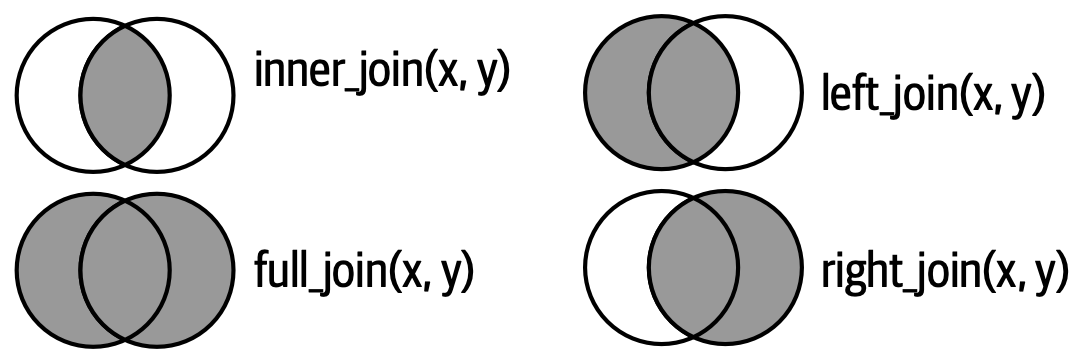
Burada gösterilenler, anahtarlar eşitse satırların eşleştiği eşitlik birleştirmeleridir. Eşitlik birleştirmeleri en yaygın tür olduğundan genellikle eşitlik nitelemesini atlayıp “eşitlik iç birleştirmesi” yerine yalnızca “iç birleştirme” diyeceğiz. Eşitsizlik birleştirmelerine Bölüm 19.5 bölümünde döneceğiz.
19.4.1 Satır eşleştirme
Şimdiye kadar x içindeki bir satırın y içinde sıfır veya bir satırla eşleşmesi durumunda ne olduğunu inceledik. Birden çok satırla eşleşirse ne olur? Neler olduğunu anlamak için önce inner_join() fonksiyonuna odaklanıp ardından Şekil 19.9 üzerindeki resmi çizelim.
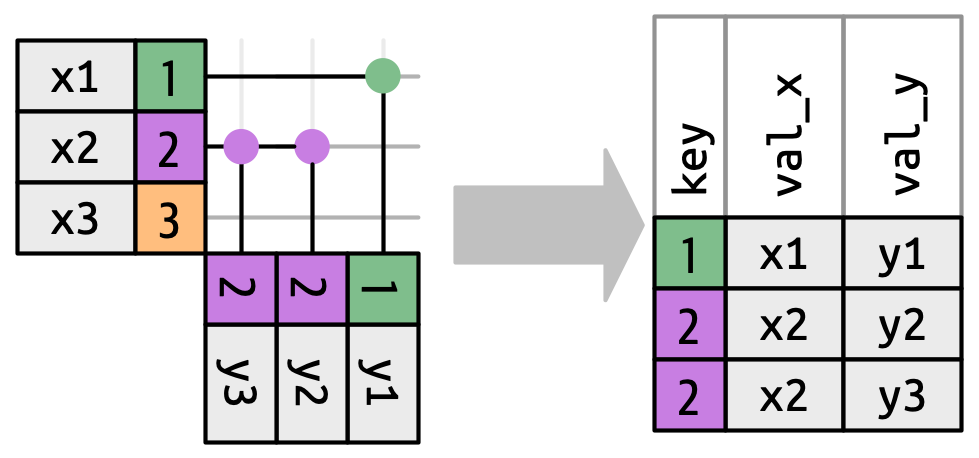
x içindeki bir satırın eşleşebileceği üç yol. x1, y içinde bir; x2, iki; x3 ise sıfır satırla eşleşir. x ve çıktıda üçer satır bulunmasına rağmen satırlar arasında doğrudan karşılık olmadığına dikkat edin.
x içindeki bir satır için üç olası sonuç vardır:
- Hiçbir şeyle eşleşmezse kaldırılır.
-
yiçinde 1 satırla eşleşirse korunur. -
yiçinde 1’den çok satırla eşleşirse her eşleşme için bir kez yinelenir.
İlke olarak bu, çıktı satırlarıyla x satırları arasında garantili bir karşılık olmadığı anlamına gelir; ancak uygulamada nadiren sorun yaratır. Bununla birlikte satır sayısında bileşimsel bir patlamaya yol açabilen özellikle tehlikeli bir durum vardır. Aşağıdaki iki tabloyu birleştirdiğinizi düşünün:
df1 içindeki ilk satır df2 içinde yalnızca bir satırla eşleşirken ikinci ve üçüncü satırların ikisi de iki satırla eşleşir. Buna bazen many-to-many birleştirme denir ve dplyr’ın uyarı vermesine yol açar:
df1 |>
  inner_join(df2, join_by(key))
#> Warning in inner_join(df1, df2, join_by(key)): Detected an unexpected many-to-many relationship between `x` and `y`.
#> ℹ Row 2 of `x` matches multiple rows in `y`.
#> ℹ Row 2 of `y` matches multiple rows in `x`.
#> ℹ If a many-to-many relationship is expected, set `relationship =
#>   "many-to-many"` to silence this warning.
#> # A tibble: 5 × 3
#>     key val_x val_y
#>   <dbl> <chr> <chr>
#> 1     1 x1    y1
#> 2     2 x2    y2
#> 3     2 x2    y3
#> 4     2 x3    y2
#> 5     2 x3    y3
Bunu bilerek yapıyorsanız uyarıda önerildiği gibi relationship = "many-to-many" ayarını kullanabilirsiniz.
19.4.2 Filtreleyici birleştirmeler
Eşleşme sayısı filtreleyici birleştirmelerin davranışını da belirler. Yarı birleştirme, Şekil 19.10 üzerinde olduğu gibi x içinde olup y içinde bir veya daha fazla eşleşmesi bulunan satırları korur. Karşıt birleştirme, Şekil 19.11 üzerinde olduğu gibi x içinde olup y içinde sıfır satırla eşleşen satırları korur. İki durumda da yalnızca eşleşmenin varlığı önemlidir; kaç kez eşleştiği önemli değildir. Bu nedenle filtreleyici birleştirmeler, dönüştürücü birleştirmeler gibi satırları asla yinelemez.
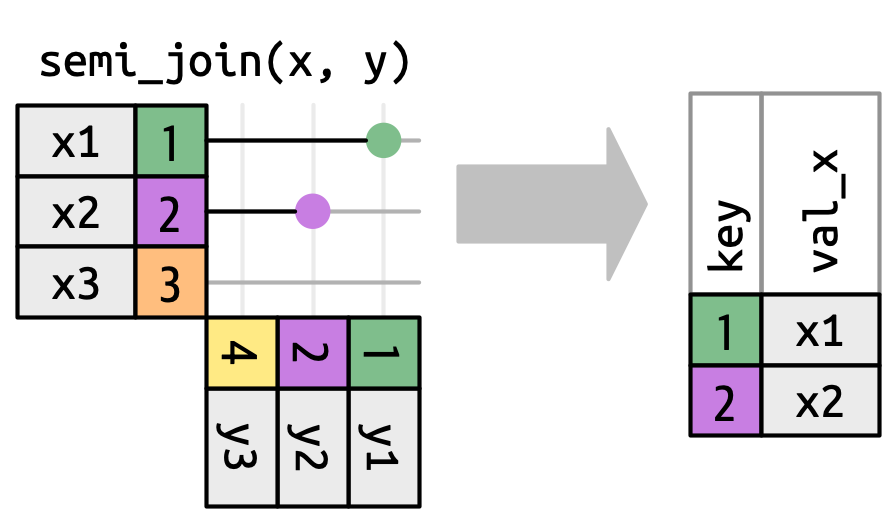
y içindeki değerler çıktıyı etkilemez.
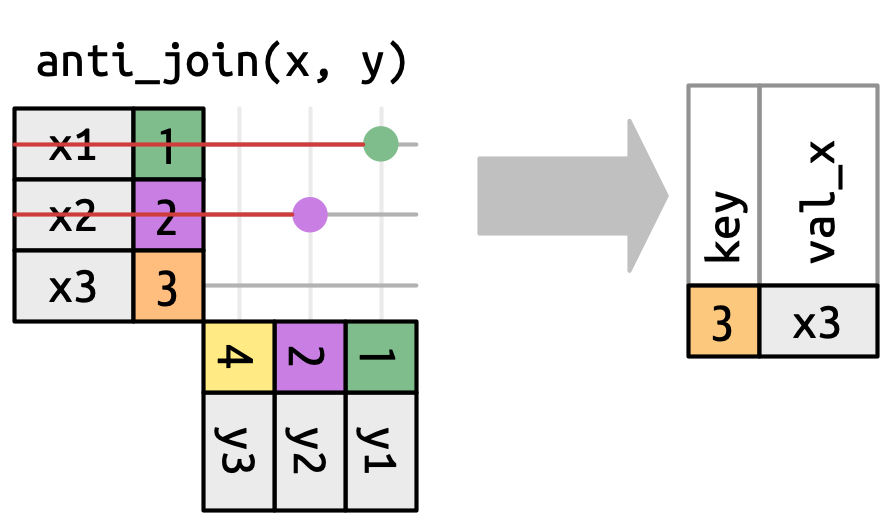
x içinde olup y içinde eşleşmesi bulunan satırları kaldırır.
19.5 Eşitsizlik birleştirmeleri
Şimdiye kadar yalnızca x anahtarı y anahtarına eşitse satırların eşleştiği eşitlik birleştirmelerini gördünüz. Şimdi bu kısıtlamayı gevşetip bir satır çiftinin eşleşip eşleşmediğini belirlemenin başka yollarını ele alacağız.
Ancak bunu yapmadan önce yukarıda yaptığımız bir basitleştirmeye dönmemiz gerekir. Eşitlik birleştirmelerinde x ve y anahtarları her zaman eşit olduğundan çıktıda yalnızca birini göstermemiz yeterlidir. keep = TRUE ile dplyr’dan iki anahtarı da korumasını isteyebiliriz; bunun sonucu aşağıdaki kodda ve Şekil 19.12 üzerinde yeniden çizilen inner_join() diyagramında görülür.
x |> inner_join(y, join_by(key == key), keep = TRUE)
#> # A tibble: 2 × 4
#>   key.x val_x key.y val_y
#>   <dbl> <chr> <dbl> <chr>
#> 1     1 x1        1 y1
#> 2     2 x2        2 y2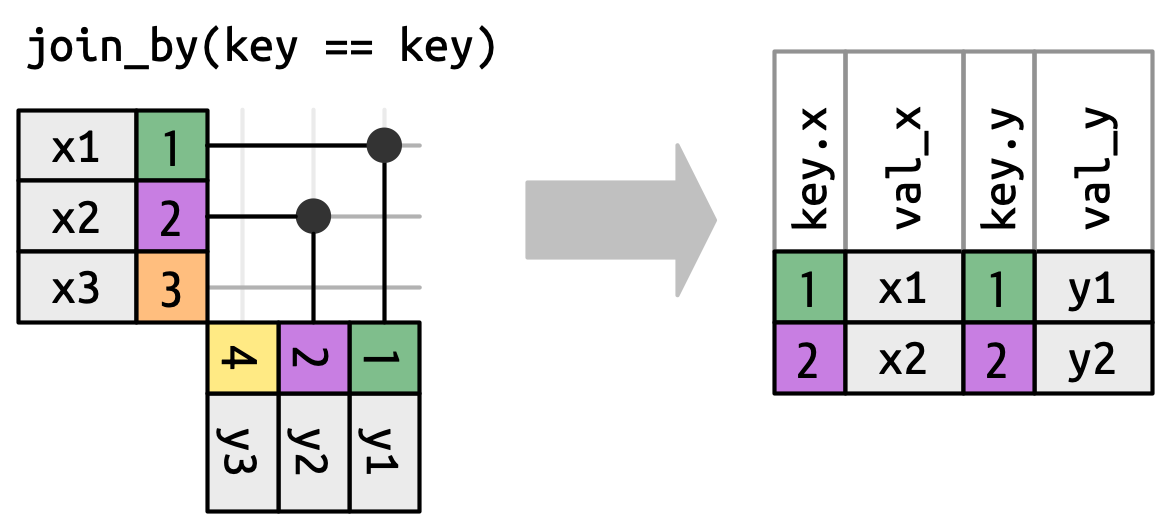
x hem de y anahtarlarını gösteren iç birleştirme.
Eşitlik birleştirmelerinden uzaklaştığımızda anahtar değerleri çoğunlukla farklı olacağından her zaman iki anahtarı da göstereceğiz. Örneğin yalnızca x$key ile y$key eşit olduğunda eşleştirmek yerine x$key, y$key değerinden büyük veya ona eşit olduğunda eşleştirebiliriz; sonuç Şekil 19.13 üzerinde gösterilmiştir. dplyr’ın birleştirme fonksiyonları eşitlik ve eşitsizlik birleştirmeleri arasındaki farkı anlar; dolayısıyla eşitsizlik birleştirmesi yaptığınızda her zaman iki anahtarı da gösterir.
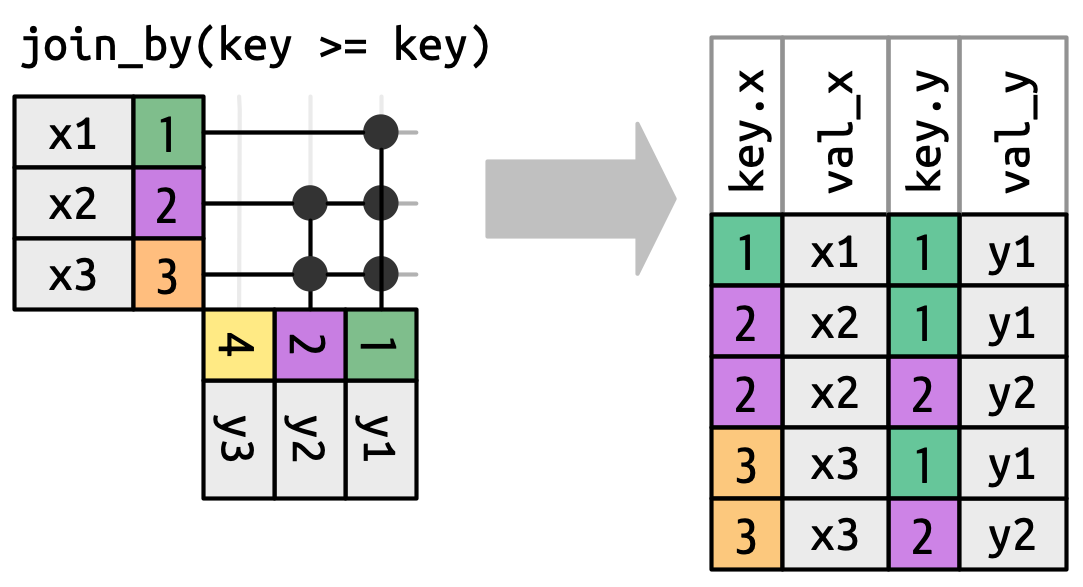
x anahtarının y anahtarından büyük veya ona eşit olması gereken bir eşitsizlik birleştirmesi. Birçok satır birden çok eşleşme üretir.
Eşitsizlik birleştirmesi pek açıklayıcı bir terim değildir; çünkü birleştirmenin ne olduğunu değil, ne olmadığını söyler. dplyr özellikle yararlı dört eşitsizlik birleştirmesi türü tanımlar:
- Çapraz birleştirmeler her satır çiftini eşleştirir.
-
Eşitsizlik birleştirmeleri
==yerine<,<=,>ve>=kullanır. - Kayan birleştirmeler (rolling join) eşitsizlik birleştirmelerine benzer ancak yalnızca en yakın eşleşmeyi bulur.
- Örtüşme birleştirmeleri, aralıklarla çalışmak için tasarlanmış özel bir eşitsizlik birleştirmesi türüdür.
Bunların her biri aşağıdaki bölümlerde daha ayrıntılı açıklanmaktadır.
19.5.1 Çapraz birleştirmeler
Çapraz birleştirme, Şekil 19.14 üzerinde olduğu gibi her şeyi eşleştirerek satırların Kartezyen çarpımını üretir. Bu, çıktının nrow(x) * nrow(y) satıra sahip olacağı anlamına gelir.
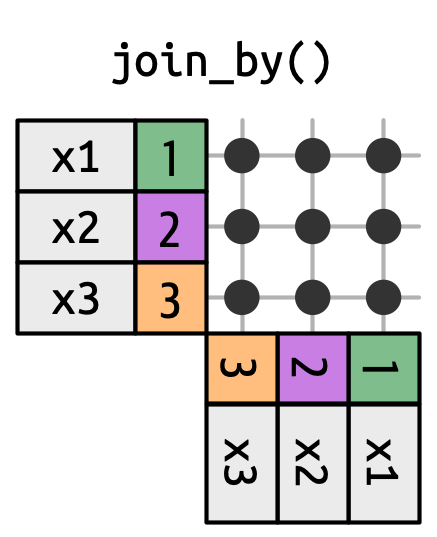
x içindeki her satırı y içindeki her satırla eşleştirir.
Çapraz birleştirmeler permütasyon üretirken yararlıdır. Örneğin aşağıdaki kod olası her ad çiftini üretir. df veri çerçevesini kendisiyle birleştirdiğimiz için buna bazen öz birleştirme denir. Her satırı eşleştirirken iç/sol/sağ/tam arasında fark olmadığından çapraz birleştirmeler farklı bir birleştirme fonksiyonu kullanır.
df <- tibble(name = c("John", "Simon", "Tracy", "Max"))
df |> cross_join(df)
#> # A tibble: 16 × 2
#>   name.x name.y
#>   <chr>  <chr>
#> 1 John   John
#> 2 John   Simon
#> 3 John   Tracy
#> 4 John   Max
#> 5 Simon  John
#> 6 Simon  Simon
#> # ℹ 10 more rows
19.5.2 Eşitsizlik birleştirmeleri
Eşitsizlik birleştirmeleri, Şekil 19.13 ve Şekil 19.15 üzerinde olduğu gibi olası eşleşme kümesini kısıtlamak için <, <=, >= veya > kullanır.
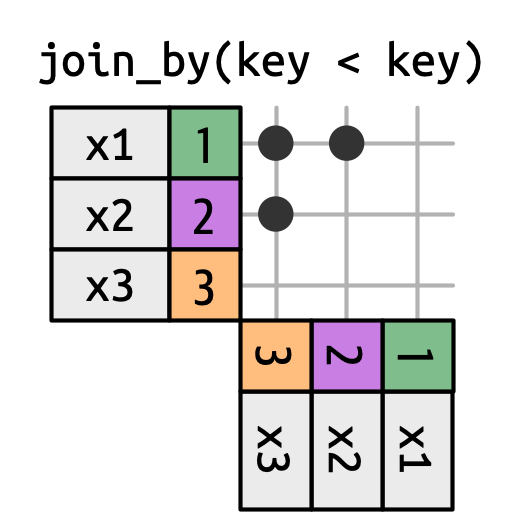
x anahtarının y anahtarından küçük olduğu satırlarda x ile yyi birleştiren eşitsizlik birleştirmesi. Sol üst köşede üçgen biçimi oluşturur.
Eşitsizlik birleştirmeleri son derece geneldir; öyle ki anlamlı ve belirli kullanım örnekleri bulmak zordur. Küçük ama yararlı bir teknik, çapraz birleştirmeyi kısıtlayarak tüm permütasyonlar yerine tüm kombinasyonları üretmektir:
df <- tibble(id = 1:4, name = c("John", "Simon", "Tracy", "Max"))

df |> inner_join(df, join_by(id < id))
#> # A tibble: 6 × 4
#>    id.x name.x  id.y name.y
#>   <int> <chr>  <int> <chr>
#> 1     1 John       2 Simon
#> 2     1 John       3 Tracy
#> 3     1 John       4 Max
#> 4     2 Simon      3 Tracy
#> 5     2 Simon      4 Max
#> 6     3 Tracy      4 Max
19.5.3 Kayan birleştirmeler
Kayan birleştirmeler, eşitsizliği sağlayan her satır yerine yalnızca en yakın satırı aldığınız özel bir eşitsizlik birleştirmesi türüdür (Şekil 19.16). closest() ekleyerek herhangi bir eşitsizlik birleştirmesini kayan birleştirmeye (rolling join) dönüştürebilirsiniz. Örneğin join_by(closest(x <= y)), x’ten büyük veya ona eşit en küçük y ile; join_by(closest(x > y)) ise xten küçük en büyük y ile eşleşir.
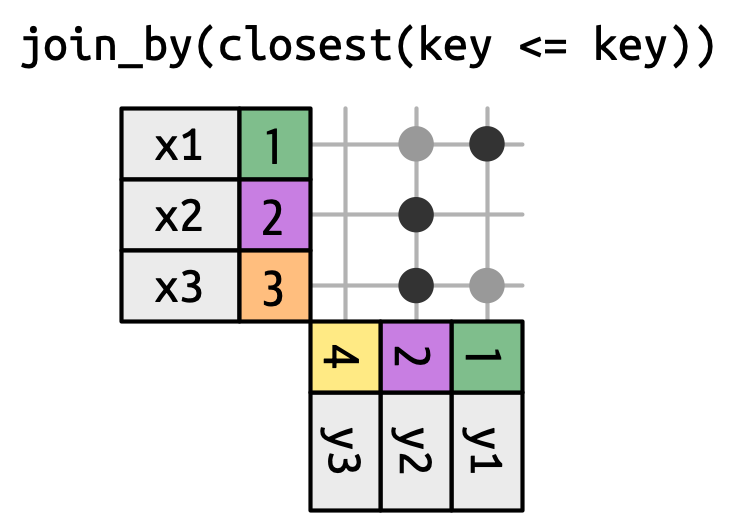
Kayan birleştirmeler, tam olarak hizalanmayan iki tarih tablonuz olduğunda ve örneğin 1. tabloda 2. tablodaki belirli bir tarihten önce (ya da sonra) gelen en yakın tarihi bulmak istediğinizde özellikle yararlıdır.
Örneğin ofisinizin parti planlama komisyonundan sorumlu olduğunuzu düşünün. Şirketiniz oldukça cimri olduğundan ayrı partiler yerine her çeyrekte yalnızca bir parti düzenliyorsunuz. Partinin ne zaman yapılacağını belirleyen kurallar biraz karmaşıktır: Partiler her zaman pazartesi günü yapılır; birçok kişi tatilde olduğundan ocak ayının ilk haftası atlanır ve 2022’nin üçüncü çeyreğinin ilk pazartesi günü 4 Temmuz olduğundan bir hafta ertelenmesi gerekir. Bu kurallar şu parti günlerini verir:
Şimdi çalışanların doğum günlerinden oluşan bir tablonuz olduğunu düşünün:
set.seed(123)
employees <- tibble(
  name = sample(babynames::babynames$name, 100),
  birthday = ymd("2022-01-01") + (sample(365, 100, replace = TRUE) - 1)
)
employees
#> # A tibble: 100 × 2
#>   name     birthday
#>   <chr>    <date>
#> 1 Kemba    2022-01-22
#> 2 Orean    2022-06-26
#> 3 Kirstyn  2022-02-11
#> 4 Amparo   2022-11-11
#> 5 Belen    2022-03-25
#> 6 Rayshaun 2022-01-11
#> # ℹ 94 more rows
Her çalışan için doğum gününden önceki (veya doğum günündeki) son parti tarihini bulmak istiyoruz. Bunu kayan birleştirmeyle ifade edebiliriz:
employees |>
  left_join(parties, join_by(closest(birthday >= party)))
#> # A tibble: 100 × 4
#>   name     birthday       q party
#>   <chr>    <date>     <int> <date>
#> 1 Kemba    2022-01-22     1 2022-01-10
#> 2 Orean    2022-06-26     2 2022-04-04
#> 3 Kirstyn  2022-02-11     1 2022-01-10
#> 4 Amparo   2022-11-11     4 2022-10-03
#> 5 Belen    2022-03-25     1 2022-01-10
#> 6 Rayshaun 2022-01-11     1 2022-01-10
#> # ℹ 94 more rows
Ancak bu yaklaşımın bir sorunu vardır: 10 Ocak’tan önce doğan kişiler partiye atanmaz:
Bu sorunu çözmek için örtüşme birleştirmelerini kullanarak farklı bir yaklaşım izlememiz gerekir.
19.5.4 Örtüşme birleştirmeleri
Örtüşme birleştirmeleri, aralıklarla çalışmayı kolaylaştırmak için eşitsizlik birleştirmelerini kullanan üç yardımcı sağlar:
-
between(x, y_lower, y_upper),x >= y_lower, x <= y_upperifadesinin kısa biçimidir. -
within(x_lower, x_upper, y_lower, y_upper),x_lower >= y_lower, x_upper <= y_upperifadesinin kısa biçimidir. -
overlaps(x_lower, x_upper, y_lower, y_upper),x_lower <= y_upper, x_upper >= y_lowerifadesinin kısa biçimidir.
Nasıl kullanıldıklarını görmek için doğum günü örneğine devam edelim. Yukarıda kullandığımız stratejinin bir sorunu vardır: 1-9 Ocak arasındaki doğum günlerinden önce parti yoktur. Bu nedenle her partinin kapsadığı tarih aralıklarını açıkça belirtmek ve bu erken doğum günleri için özel bir durum tanımlamak daha iyi olabilir:
parties <- tibble(
  q = 1:4,
  party = ymd(c("2022-01-10", "2022-04-04", "2022-07-11", "2022-10-03")),
  start = ymd(c("2022-01-01", "2022-04-04", "2022-07-11", "2022-10-03")),
  end = ymd(c("2022-04-03", "2022-07-11", "2022-10-02", "2022-12-31"))
)
parties
#> # A tibble: 4 × 4
#>       q party      start      end
#>   <int> <date>     <date>     <date>
#> 1     1 2022-01-10 2022-01-01 2022-04-03
#> 2     2 2022-04-04 2022-04-04 2022-07-11
#> 3     3 2022-07-11 2022-07-11 2022-10-02
#> 4     4 2022-10-03 2022-10-03 2022-12-31
Hadley veri girişinde umutsuz derecede kötü olduğu için parti dönemlerinin örtüşmediğini de denetlemek istedi. Bunu yapmanın bir yolu, herhangi bir başlangıç-bitiş aralığının başka bir aralıkla örtüşüp örtüşmediğini öz birleştirmeyle denetlemektir:
parties |>
  inner_join(parties, join_by(overlaps(start, end, start, end), q < q)) |>
  select(start.x, end.x, start.y, end.y)
#> # A tibble: 1 × 4
#>   start.x    end.x      start.y    end.y
#>   <date>     <date>     <date>     <date>
#> 1 2022-04-04 2022-07-11 2022-07-11 2022-10-02
Eyvah, bir örtüşme var; sorunu düzeltip devam edelim:
Artık her çalışanı partisiyle eşleştirebiliriz. Herhangi bir çalışanın partiye atanıp atanmadığını hızla öğrenmek istediğimiz için burası unmatched = "error" kullanmak için iyi bir yerdir.
employees |>
  inner_join(parties, join_by(between(birthday, start, end)), unmatched = "error")
#> # A tibble: 100 × 6
#>   name     birthday       q party      start      end
#>   <chr>    <date>     <int> <date>     <date>     <date>
#> 1 Kemba    2022-01-22     1 2022-01-10 2022-01-01 2022-04-03
#> 2 Orean    2022-06-26     2 2022-04-04 2022-04-04 2022-07-10
#> 3 Kirstyn  2022-02-11     1 2022-01-10 2022-01-01 2022-04-03
#> 4 Amparo   2022-11-11     4 2022-10-03 2022-10-03 2022-12-31
#> 5 Belen    2022-03-25     1 2022-01-10 2022-01-01 2022-04-03
#> 6 Rayshaun 2022-01-11     1 2022-01-10 2022-01-01 2022-04-03
#> # ℹ 94 more rows
19.5.5 Alıştırmalar
-
Bu eşitlik birleştirmesinde anahtarlara ne olduğunu açıklayabilir misiniz? Neden farklılar?
x |> full_join(y, join_by(key == key))
#> # A tibble: 4 × 3
#>     key val_x val_y
#>   <dbl> <chr> <chr>
#> 1     1 x1    y1
#> 2     2 x2    y2
#> 3     3 x3    <NA>
#> 4     4 <NA>  y3

x |> full_join(y, join_by(key == key), keep = TRUE)
#> # A tibble: 4 × 4
#>   key.x val_x key.y val_y
#>   <dbl> <chr> <dbl> <chr>
#> 1     1 x1        1 y1
#> 2     2 x2        2 y2
#> 3     3 x3       NA <NA>
#> 4    NA <NA>      4 y3
Herhangi bir parti döneminin başka bir parti dönemiyle örtüşüp örtüşmediğini bulurken
join_by()içinde nedenq < qkullandık? Bu eşitsizliği kaldırırsanız ne olur?
19.6 Özet
Bu bölümde iki veri çerçevesindeki verileri birleştirmek için dönüştürücü ve filtreleyici birleştirmeleri kullanmayı öğrendiniz. Bu sırada anahtarları belirlemeyi ve birincil ile yabancı anahtarlar arasındaki farkı öğrendiniz. Ayrıca birleştirmelerin nasıl çalıştığını ve çıktının kaç satıra sahip olacağını nasıl bulacağınızı artık biliyorsunuz. Son olarak eşitsizlik birleştirmelerinin gücüne göz atıp birkaç ilginç kullanım örneği gördünüz.
Bu bölüm, kitabın ayrı sütunlar ve tibble’larla kullanabileceğiniz araçlara odaklanan “Dönüştürme” kısmını tamamlıyor. Mantıksal vektörler, sayılar ve eksiksiz tablolarla çalışmak için dplyr ve temel R fonksiyonlarını; karakter dizileri için stringr, tarih-saatler için lubridate ve faktörler için forcats fonksiyonlarını öğrendiniz.
Kitabın sonraki kısmında çeşitli veri türlerini düzenli biçimde R’a içe aktarma hakkında daha fazla bilgi edineceksiniz.