15 Düzenli ifadeler
15.1 Giriş
Bölüm 14 bölümünde karakter dizileriyle çalışmaya yönelik birçok yararlı fonksiyon öğrendiniz. Bu bölümde, karakter dizilerindeki kalıpları tanımlamak için özlü ve güçlü bir dil sunan düzenli ifadeleri kullanan fonksiyonlara odaklanacağız. “Düzenli ifade” biraz uzun bir terim olduğundan çoğu kişi bunu “regex”1 veya “regexp” olarak kısaltır.
Bölüm, düzenli ifadelerin temelleri ve veri analizi için en yararlı stringr fonksiyonlarıyla başlar. Ardından kalıplara ilişkin bilginizi genişleterek yedi önemli konuyu ele alacağız: kaçış, sabitleme, karakter sınıfları, kısayol sınıfları, niceleyiciler, işlem önceliği ve gruplama. Sonra stringr fonksiyonlarının çalışabildiği diğer kalıp türlerinden ve düzenli ifadelerin işleyişini ayarlayan çeşitli “bayraklardan” söz edeceğiz. Son olarak tidyverse ve temel R içinde regex kullanabileceğiniz diğer yerleri gözden geçireceğiz.
15.1.1 Ön koşullar
Bu bölümde temel tidyverse üyeleri olan stringr ve tidyr paketlerindeki düzenli ifade fonksiyonlarının yanı sıra babynames paketindeki verileri kullanacağız.
Temel fikri kavramanız için bölüm boyunca çok basit satır içi örnekleri, bebek adı verilerini ve stringr paketindeki üç karakter vektörünü birlikte kullanacağız:
-
fruit, 80 meyvenin adını içerir. -
words, yaygın kullanılan 980 İngilizce sözcük içerir. -
sentences, 720 kısa cümle içerir.
15.2 Kalıpların temelleri
Regex kalıplarının nasıl çalıştığını öğrenmek için str_view() kullanacağız. Önceki bölümde karakter dizisiyle yazdırılan gösterimi arasındaki farkı anlamak için kullandığımız str_view() fonksiyonuna şimdi ikinci argüman olarak bir düzenli ifade vereceğiz. Bu durumda str_view() yalnızca karakter vektörünün eşleşen elemanlarını gösterir, her eşleşmeyi <> ile çevreler ve mümkün olduğunda mavi renkle vurgular.
En basit kalıplar, kendileriyle birebir eşleşen harf ve sayılardan oluşur:
str_view(fruit, "berry")
#>  [6] │ bil<berry>
#>  [7] │ black<berry>
#> [10] │ blue<berry>
#> [11] │ boysen<berry>
#> [19] │ cloud<berry>
#> [21] │ cran<berry>
#> ... and 8 more
Harf ve sayılar birebir eşleşir ve değişmez karakterler olarak adlandırılır. ., +, *, [, ] ve ? gibi çoğu noktalama işaretinin özel anlamları vardır2 ve bunlara metakarakterler (metacharacters) denir. Örneğin . herhangi bir karakterle3 eşleşir; dolayısıyla "a.", “a” harfinin ardından başka bir karakter gelen her karakter dizisiyle eşleşir:
Ya da “a” harfini, ardından üç harfi ve sonra “e” harfini içeren tüm meyveleri bulabiliriz:
str_view(fruit, "a...e")
#>  [1] │ <apple>
#>  [7] │ bl<ackbe>rry
#> [48] │ mand<arine>
#> [51] │ nect<arine>
#> [62] │ pine<apple>
#> [64] │ pomegr<anate>
#> ... and 2 moreNiceleyiciler, bir kalıbın kaç kez eşleşebileceğini belirler:
-
?, kalıbı isteğe bağlı kılar; kalıp 0 veya 1 kez eşleşir. -
+, kalıbın yinelenmesini sağlar; kalıp en az bir kez eşleşir. -
*, kalıbın isteğe bağlı olmasını veya yinelenmesini sağlar; kalıp 0 dâhil herhangi bir sayıda eşleşir.
# ab?, "a" ve isteğe bağlı olarak onu izleyen "b" ile eşleşir.
str_view(c("a", "ab", "abb"), "ab?")
#> [1] │ <a>
#> [2] │ <ab>
#> [3] │ <ab>b

# ab+, "a" ve onu izleyen en az bir "b" ile eşleşir.
str_view(c("a", "ab", "abb"), "ab+")
#> [2] │ <ab>
#> [3] │ <abb>

# ab*, "a" ve onu izleyen herhangi bir sayıda "b" ile eşleşir.
str_view(c("a", "ab", "abb"), "ab*")
#> [1] │ <a>
#> [2] │ <ab>
#> [3] │ <abb>
Karakter sınıfları [] ile tanımlanır ve bir karakter kümesiyle eşleşmenizi sağlar. Örneğin [abcd], “a”, “b”, “c” veya “d” ile eşleşir. Başa ^ ekleyerek eşleşmeyi tersine de çevirebilirsiniz: [^abcd], “a”, “b”, “c” ve “d” dışındaki her şeyle eşleşir. Bu fikirden yararlanarak iki yanında ünlü harf bulunan “x” veya iki yanında ünsüz harf bulunan “y” içeren sözcükleri bulabiliriz:
Bir veya daha fazla alternatif kalıp arasından seçim yapmak için alternatif operatörü | kullanılabilir. Örneğin aşağıdaki kalıplar “apple”, “melon” veya “nut” içeren ya da yinelenen bir ünlüye sahip meyveleri arar.
str_view(fruit, "apple|melon|nut")
#>  [1] │ <apple>
#> [13] │ canary <melon>
#> [20] │ coco<nut>
#> [52] │ <nut>
#> [62] │ pine<apple>
#> [72] │ rock <melon>
#> ... and 1 more
str_view(fruit, "aa|ee|ii|oo|uu")
#>  [9] │ bl<oo>d orange
#> [33] │ g<oo>seberry
#> [47] │ lych<ee>
#> [66] │ purple mangost<ee>n
Düzenli ifadeler son derece özlüdür ve çok sayıda noktalama işareti kullanır; bu nedenle ilk başta bunaltıcı ve okunması zor görünebilir. Endişelenmeyin; alıştırma yaptıkça gelişecek ve basit kalıplar kısa sürede doğal gelmeye başlayacak. Bu süreci bazı yararlı stringr fonksiyonlarıyla alıştırma yaparak başlatalım.
15.3 Temel fonksiyonlar
Düzenli ifadelerin temellerini öğrendiğinize göre bunları bazı stringr ve tidyr fonksiyonlarıyla kullanalım. Bu bölümde bir eşleşmenin varlığını veya yokluğunu saptamayı, eşleşme sayısını hesaplamayı, eşleşmeyi sabit metinle değiştirmeyi ve bir kalıp kullanarak metin çıkarmayı öğreneceksiniz.
15.3.1 Eşleşmeleri saptama
str_detect(), kalıp karakter vektörünün bir elemanıyla eşleştiğinde TRUE, aksi durumda FALSE değerini içeren bir mantıksal vektör döndürür:
str_detect(c("a", "b", "c"), "[aeiou]")
#> [1]  TRUE FALSE FALSE
str_detect() başlangıç vektörüyle aynı uzunlukta bir mantıksal vektör döndürdüğünden filter() ile iyi çalışır. Örneğin bu kod, küçük “x” harfi içeren en popüler adları bulur:
babynames |>
  filter(str_detect(name, "x")) |>
  count(name, wt = n, sort = TRUE)
#> # A tibble: 974 × 2
#>   name           n
#>   <chr>      <int>
#> 1 Alexander 665492
#> 2 Alexis    399551
#> 3 Alex      278705
#> 4 Alexandra 232223
#> 5 Max       148787
#> 6 Alexa     123032
#> # ℹ 968 more rows
str_detect() fonksiyonunu sum() veya mean() ile eşleştirerek summarize() içinde de kullanabiliriz: sum(str_detect(x, pattern)) eşleşen gözlemlerin sayısını, mean(str_detect(x, pattern)) ise oranını verir. Örneğin aşağıdaki kod, “x” içeren bebek adlarının4 oranını yıllara göre hesaplar ve görselleştirir. Görünüşe göre bu adların popülerliği son zamanlarda çarpıcı biçimde artmış!
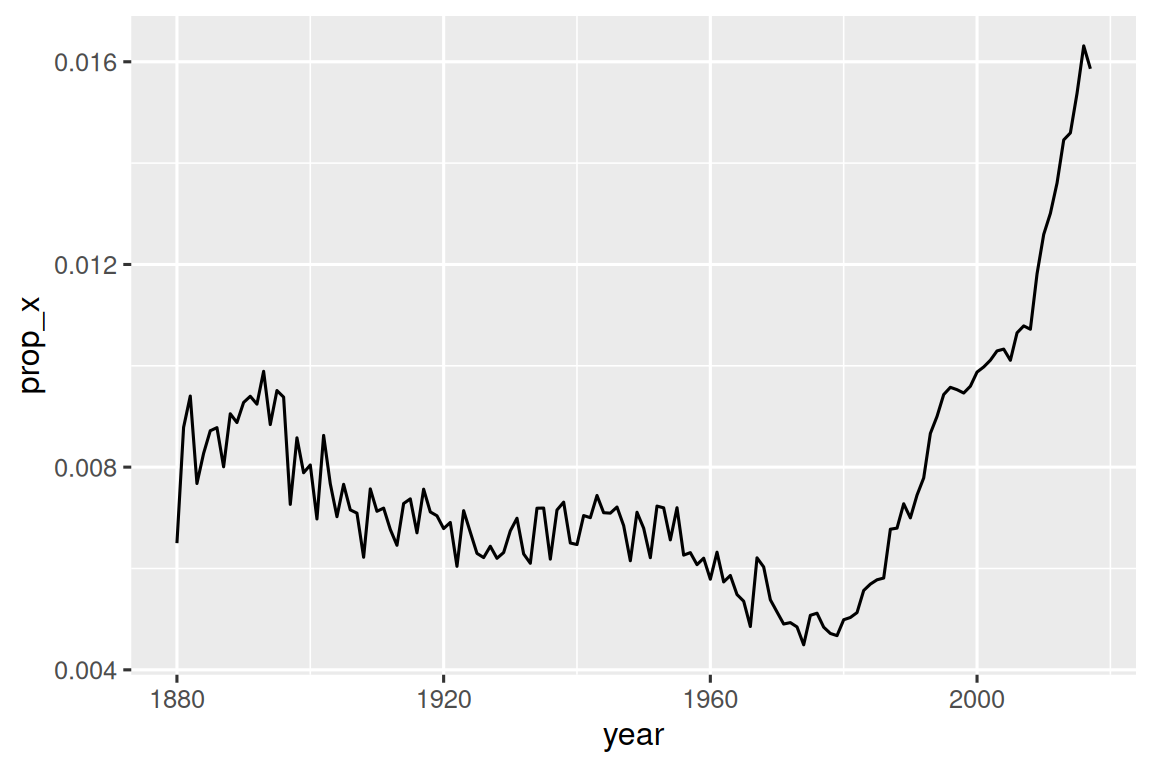
str_detect() ile yakından ilişkili iki fonksiyon vardır: str_subset() ve str_which(). str_subset() yalnızca eşleşen karakter dizilerini içeren bir karakter vektörü döndürür. str_which() ise eşleşen karakter dizilerinin konumlarını veren bir tam sayı vektörü döndürür.
15.3.2 Eşleşmeleri sayma
str_detect() fonksiyonundan sonraki karmaşıklık düzeyi str_count() fonksiyonudur: doğru veya yanlış sonucundan ziyade her karakter dizisindeki eşleşme sayısını verir.
Her eşleşmenin önceki eşleşmenin bittiği yerde başladığına, yani regex eşleşmelerinin hiçbir zaman örtüşmediğine dikkat edin. Örneğin "abababa" içinde "aba" kalıbı kaç kez eşleşir? Düzenli ifadelere göre yanıt üç değil, ikidir:
str_count() fonksiyonunu mutate() ile kullanmak doğaldır. Aşağıdaki örnek, her addaki ünlü ve ünsüz harflerin sayısını hesaplamak için str_count() fonksiyonunu karakter sınıflarıyla kullanır.
babynames |>
  count(name) |>
  mutate(
    vowels = str_count(name, "[aeiou]"),
    consonants = str_count(name, "[^aeiou]")
  )
#> # A tibble: 97,310 × 4
#>   name          n vowels consonants
#>   <chr>     <int>  <int>      <int>
#> 1 Aaban        10      2          3
#> 2 Aabha         5      2          3
#> 3 Aabid         2      2          3
#> 4 Aabir         1      2          3
#> 5 Aabriella     5      4          5
#> 6 Aada          1      2          2
#> # ℹ 97,304 more rows
Yakından bakarsanız hesaplamalarımızda bir sorun olduğunu fark edersiniz: “Aaban” üç “a” içerir, ancak özetimiz yalnızca iki ünlü bildirir. Bunun nedeni düzenli ifadelerin büyük-küçük harfe duyarlı olmasıdır. Bu sorunu üç yolla çözebiliriz:
- Büyük harfli ünlüleri karakter sınıfına ekleyin:
str_count(name, "[aeiouAEIOU]"). - Düzenli ifadeye büyük-küçük harfi yok saymasını söyleyin:
str_count(name, regex("[aeiou]", ignore_case = TRUE)). Bunu Bölüm 15.5.1 bölümünde daha ayrıntılı ele alacağız. - Adları küçük harfe dönüştürmek için
str_to_lower()kullanın:str_count(str_to_lower(name), "[aeiou]").
Karakter dizileriyle çalışırken bu yaklaşım çeşitliliği oldukça yaygındır: kalıbı karmaşıklaştırarak veya karakter dizisine ön işleme uygulayarak hedefe ulaşmanın çoğu zaman birden fazla yolu vardır. Bir yaklaşımda takılırsanız yöntemi değiştirip sorunu farklı bir açıdan ele almak genellikle yararlı olur.
Bu örnekte ada iki fonksiyon uyguladığımız için önce adı dönüştürmek daha kolaydır:
babynames |>
  count(name) |>
  mutate(
    name = str_to_lower(name),
    vowels = str_count(name, "[aeiou]"),
    consonants = str_count(name, "[^aeiou]")
  )
#> # A tibble: 97,310 × 4
#>   name          n vowels consonants
#>   <chr>     <int>  <int>      <int>
#> 1 aaban        10      3          2
#> 2 aabha         5      3          2
#> 3 aabid         2      3          2
#> 4 aabir         1      3          2
#> 5 aabriella     5      5          4
#> 6 aada          1      3          1
#> # ℹ 97,304 more rows
15.3.3 Değerleri değiştirme
Eşleşmeleri saptayıp saymanın yanı sıra str_replace() ve str_replace_all() ile değiştirebiliriz. str_replace() ilk eşleşmeyi, adından anlaşılacağı gibi str_replace_all() ise tüm eşleşmeleri değiştirir.
x <- c("apple", "pear", "banana")
str_replace_all(x, "[aeiou]", "-")
#> [1] "-ppl-"  "p--r"   "b-n-n-"
str_remove() ve str_remove_all(), str_replace(x, pattern, "") için kullanışlı kısayollardır:
x <- c("apple", "pear", "banana")
str_remove_all(x, "[aeiou]")
#> [1] "ppl" "pr"  "bnn"
Bu fonksiyonlar veri temizlerken doğal olarak mutate() ile eşleştirilir ve tutarsız biçimlendirme katmanlarını soymak için çoğu zaman art arda uygulanır.
15.3.4 Değişkenleri çıkarma
Ele alacağımız son fonksiyon, düzenli ifadeler kullanarak bir sütundaki verileri bir veya daha fazla yeni sütuna çıkarır: separate_wider_regex(). Bu fonksiyon, Bölüm 14.4.2 bölümünde öğrendiğiniz separate_wider_position() ve separate_wider_delim() fonksiyonlarının eşidir. Tek tek vektörler yerine veri çerçevelerinin sütunları üzerinde çalıştıkları için bu fonksiyonlar tidyr içinde yer alır.
Nasıl çalıştığını göstermek için basit bir veri kümesi oluşturalım. Burada babynames verilerinden türetilmiş, bazı kişilerin adını, cinsiyetini ve yaşını oldukça tuhaf bir biçimde içeren verilerimiz var5:
df <- tribble(
  ~str,
  "<Sheryl>-F_34",
  "<Kisha>-F_45",
  "<Brandon>-N_33",
  "<Sharon>-F_38",
  "<Penny>-F_58",
  "<Justin>-M_41",
  "<Patricia>-F_84",
)
Bu verileri separate_wider_regex() ile çıkarmak için her parçayla eşleşen bir düzenli ifade dizisi oluşturmamız yeterlidir. Bir parçanın içeriğinin çıktıda görünmesini istiyorsak ona bir ad veririz:
df |>
  separate_wider_regex(
    str,
    patterns = c(
      "<",
      name = "[A-Za-z]+",
      ">-",
      gender = ".",
      "_",
      age = "[0-9]+"
    )
  )
#> # A tibble: 7 × 3
#>   name    gender age
#>   <chr>   <chr>  <chr>
#> 1 Sheryl  F      34
#> 2 Kisha   F      45
#> 3 Brandon N      33
#> 4 Sharon  F      38
#> 5 Penny   F      58
#> 6 Justin  M      41
#> # ℹ 1 more row
Eşleşme başarısız olursa, separate_wider_delim() ve separate_wider_position() fonksiyonlarında olduğu gibi sorunu bulmak için too_few = "debug" kullanabilirsiniz.
15.3.5 Alıştırmalar
En fazla ünlü harf içeren bebek adı hangisidir? Ünlü harf oranı en yüksek olan ad hangisidir? İpucu: payda nedir?
"a/b/c/d/e"içindeki tüm eğik çizgileri ters eğik çizgilerle değiştirin. Tüm ters eğik çizgileri eğik çizgilerle değiştirerek dönüşümü geri almaya çalışırsanız ne olur? Bu sorunu birazdan ele alacağız.str_replace_all()kullanarakstr_to_lower()fonksiyonunun basit bir sürümünü oluşturun.Ülkenizde yaygın biçimde yazılan telefon numaralarıyla eşleşecek bir düzenli ifade oluşturun.
15.4 Kalıp ayrıntıları
Kalıp dilinin temellerini ve bunu bazı stringr ve tidyr fonksiyonlarıyla nasıl kullanacağınızı öğrendiğinize göre ayrıntılara inme zamanı. Önce normalde özel olarak yorumlanacak metakarakterlerle değişmez biçimde eşleşmenizi sağlayan kaçışla başlayacağız. Ardından karakter dizisinin başlangıcı veya sonuyla eşleşmenizi sağlayan sabitleyicileri öğreneceksiniz. Sonra bir kümedeki herhangi bir karakterle eşleşmeye yarayan karakter sınıflarını ve kısayollarını ayrıntılandıracağız. Bir kalıbın kaç kez eşleşebileceğini belirleyen niceleyicilerin son ayrıntılarını göreceksiniz. Ardından önemli, ancak karmaşık bir konu olan operatör önceliğini ve parantezleri ele alacağız. Son olarak kalıp bileşenlerini gruplamaya ilişkin bazı ayrıntılarla bitireceğiz.
Burada kullandığımız terimler her bileşenin teknik adıdır. Amaçlarını her zaman sezgisel biçimde anlatmasalar da daha sonra ayrıntılı bilgi aramak istediğinizde doğru terimleri bilmek çok yararlıdır.
15.4.1 Kaçış
Değişmez bir . ile eşleşmek için düzenli ifadeye metakarakteri6 değişmez olarak eşleştirmesini söyleyen bir kaçışa ihtiyacınız vardır. Karakter dizileri gibi regex’ler de kaçış için ters eğik çizgi kullanır. Dolayısıyla . ile eşleşmek için \. regex’i gerekir. Ne yazık ki bu durum bir sorun yaratır. Düzenli ifadeleri karakter dizileriyle temsil ederiz ve \ karakter dizilerinde de kaçış simgesi olarak kullanılır. Bu nedenle \. düzenli ifadesini oluşturmak için aşağıdaki örnekte olduğu gibi "\\." karakter dizisine ihtiyaç duyarız.
Bu kitapta düzenli ifadeleri genellikle \. örneğindeki gibi tırnak işaretleri olmadan yazacağız. Gerçekte ne yazacağınızı vurgulamamız gerektiğinde ise ifadeyi tırnak içine alıp "\\." örneğindeki gibi ek kaçışlar kullanacağız.
Düzenli ifadelerde \ kaçış karakteri olarak kullanılıyorsa değişmez bir \ ile nasıl eşleşirsiniz? Onu da kaçırmanız ve \\ düzenli ifadesini oluşturmanız gerekir. Bu düzenli ifadeyi oluşturmak için \ karakterinin yine kaçırılması gereken bir karakter dizisi kullanmalısınız. Dolayısıyla değişmez bir \ ile eşleşmek için "\\\\" yazmanız gerekir: Tek bir ters eğik çizgiyle eşleşmek için dört ters eğik çizgi!
Alternatif olarak Bölüm 14.2.2 bölümünde öğrendiğiniz ham karakter dizilerini kullanmayı daha kolay bulabilirsiniz. Bu yöntem bir kaçış katmanından kurtulmanızı sağlar:
str_view(x, r"{\\}")
#> [1] │ a<\>b
Değişmez bir ., $, |, *, +, ?, {, }, ( veya ) ile eşleşmeye çalışıyorsanız ters eğik çizgiyle kaçış kullanmanın bir alternatifi vardır: [.], [$], [|], … gibi bir karakter sınıfı kullanabilirsiniz. Bunların tümü değişmez değerlerle eşleşir.
15.4.2 Sabitleyiciler
Düzenli ifadeler varsayılan olarak bir karakter dizisinin herhangi bir bölümüyle eşleşir. Başlangıçta veya sonda eşleşmek istiyorsanız başlangıç için ^, son için $ kullanarak düzenli ifadeyi sabitlemeniz gerekir:
Dolar tutarlarını bu şekilde yazdığımız için $ işaretinin karakter dizisinin başlangıcıyla eşleşmesi gerektiğini düşünmek kolaydır; ancak düzenli ifadeler böyle çalışmaz.
Bir düzenli ifadenin yalnızca karakter dizisinin tamamıyla eşleşmesini sağlamak için onu hem ^ hem de $ ile sabitleyin:
Sözcükler arasındaki sınırla (yani bir sözcüğün başlangıcı veya sonuyla) \b kullanarak da eşleşebilirsiniz. Bu özellikle RStudio’nun bul ve değiştir aracını kullanırken yararlı olabilir. Örneğin sum() fonksiyonunun tüm kullanımlarını bulmak için summarize, summary, rowsum ve benzerleriyle eşleşmeden \bsum\b kalıbını arayabilirsiniz:
Sabitleyiciler tek başına kullanıldığında sıfır genişlikli bir eşleşme üretir:
Bu, tek başına kullanılan bir sabitleyiciyi değiştirdiğinizde ne olduğunu anlamanıza yardımcı olur:
str_replace_all("abc", c("$", "^", "\\b"), "--")
#> [1] "abc--"   "--abc"   "--abc--"
15.4.3 Karakter sınıfları
Bir karakter sınıfı ya da karakter kümesi, bir kümedeki herhangi bir karakterle eşleşmenizi sağlar. Yukarıda ele aldığımız gibi kendi kümelerinizi [] ile oluşturabilirsiniz: [abc], “a”, “b” veya “c” ile; [^abc] ise “a”, “b” ve “c” dışındaki herhangi bir karakterle eşleşir. ^ dışında [] içinde özel anlam taşıyan iki karakter daha vardır:
-
-bir aralık tanımlar; örneğin[a-z]herhangi bir küçük harfle,[0-9]ise herhangi bir rakamla eşleşir. -
\özel karakterleri kaçırır; dolayısıyla[\^\-\]],^,-veya]ile eşleşir.
İşte birkaç örnek:
x <- "abcd ABCD 12345 -!@#%."
str_view(x, "[abc]+")
#> [1] │ <abc>d ABCD 12345 -!@#%.
str_view(x, "[a-z]+")
#> [1] │ <abcd> ABCD 12345 -!@#%.
str_view(x, "[^a-z0-9]+")
#> [1] │ abcd< ABCD >12345< -!@#%.>

# [] içinde özel anlam taşıyan karakterlerle eşleşmek için
# kaçış kullanmanız gerekir.
str_view("a-b-c", "[a-c]")
#> [1] │ <a>-<b>-<c>
str_view("a-b-c", "[a\\-c]")
#> [1] │ <a><->b<-><c>
Bazı karakter sınıfları o kadar sık kullanılır ki kendilerine ait birer kısayolları vardır. Yeni satır dışındaki herhangi bir karakterle eşleşen . kısayolunu zaten gördünüz. Özellikle yararlı üç çift daha vardır7:
-
\dherhangi bir rakamla;\Drakam olmayan herhangi bir karakterle eşleşir. -
\sherhangi bir boşluk karakteriyle (ör. boşluk, sekme, yeni satır);\Sboşluk olmayan herhangi bir karakterle eşleşir. -
\wherhangi bir “sözcük” karakteriyle, yani harf veya rakamla;\W“sözcük olmayan” herhangi bir karakterle eşleşir.
Aşağıdaki kod, bu altı kısayolu harf, rakam ve noktalama işaretlerinden oluşan bir seçki üzerinde gösterir.
x <- "abcd ABCD 12345 -!@#%."
str_view(x, "\\d+")
#> [1] │ abcd ABCD <12345> -!@#%.
str_view(x, "\\D+")
#> [1] │ <abcd ABCD >12345< -!@#%.>
str_view(x, "\\s+")
#> [1] │ abcd< >ABCD< >12345< >-!@#%.
str_view(x, "\\S+")
#> [1] │ <abcd> <ABCD> <12345> <-!@#%.>
str_view(x, "\\w+")
#> [1] │ <abcd> <ABCD> <12345> -!@#%.
str_view(x, "\\W+")
#> [1] │ abcd< >ABCD< >12345< -!@#%.>
15.4.4 Niceleyiciler
Niceleyiciler, bir kalıbın kaç kez eşleşeceğini denetler. Bölüm 15.2 bölümünde ? (0 veya 1 eşleşme), + (1 ya da daha fazla eşleşme) ve * (0 ya da daha fazla eşleşme) işaretlerini öğrendiniz. Örneğin colou?r hem Amerikan hem de Britanya yazımıyla, \d+ bir ya da daha fazla rakamla, \s? ise isteğe bağlı tek bir boşluk karakteriyle eşleşir. Eşleşme sayısını {} ile kesin olarak da belirtebilirsiniz:
-
{n}tam olarak n kez eşleşir. -
{n,}en az n kez eşleşir. -
{n,m}n ile m kez arasında eşleşir.
15.4.5 Operatör önceliği ve parantezler
ab+ neyle eşleşir? “a” ve ardından gelen bir ya da daha fazla “b” ile mi, yoksa herhangi bir sayıda yinelenen “ab” ile mi? Peki ^a|b$ neyle eşleşir? Tam olarak a ya da b karakter dizisiyle mi, yoksa a ile başlayan veya b ile biten bir karakter dizisiyle mi?
Bu soruların yanıtını, okulda öğrenmiş olabileceğiniz işlem önceliği kurallarına benzer biçimde operatör önceliği belirler. * daha yüksek, + ise daha düşük önceliğe sahip olduğundan a + b * c ifadesinin (a + b) * c değil a + (b * c) ile eşdeğer olduğunu bilirsiniz: * işlemini + işleminden önce hesaplarsınız.
Benzer biçimde düzenli ifadelerin de kendi öncelik kuralları vardır: Niceleyicilerin önceliği yüksek, almaşık eşleşmenin önceliği düşüktür. Bu nedenle ab+, a(b+) ile; ^a|b$ ise (^a)|(b$) ile eşdeğerdir. Cebirde olduğu gibi olağan sırayı geçersiz kılmak için parantez kullanabilirsiniz. Ancak cebirden farklı olarak regex öncelik kurallarını hatırlamanız pek olası değildir; bu yüzden parantezleri bolca kullanmaktan çekinmeyin.
15.4.6 Gruplama ve yakalama
Parantezler operatör önceliğini geçersiz kılmanın yanında önemli bir etkiye daha sahiptir: Eşleşmenin alt bileşenlerini kullanmanıza olanak tanıyan yakalama grupları oluştururlar.
Bir yakalama grubunu kullanmanın ilk yolu, eşleşme içinde geri başvuruyla ona yeniden başvurmaktır: \1 ilk parantezdeki, \2 ikinci parantezdeki eşleşmeye başvurur ve bu şekilde devam eder. Örneğin aşağıdaki kalıp, yinelenen bir harf çifti içeren tüm meyveleri bulur:
str_view(fruit, "(..)\\1")
#>  [4] │ b<anan>a
#> [20] │ <coco>nut
#> [22] │ <cucu>mber
#> [41] │ <juju>be
#> [56] │ <papa>ya
#> [73] │ s<alal> berry
Bu kalıp ise aynı harf çiftiyle başlayıp biten tüm sözcükleri bulur:
str_view(words, "^(..).*\\1$")
#> [152] │ <church>
#> [217] │ <decide>
#> [617] │ <photograph>
#> [699] │ <require>
#> [739] │ <sense>
Geri başvuruları str_replace() içinde de kullanabilirsiniz. Örneğin bu kod, sentences içindeki ikinci ve üçüncü sözcüklerin sırasını değiştirir:
sentences |>
  str_replace("(\\w+) (\\w+) (\\w+)", "\\1 \\3 \\2") |>
  str_view()
#> [1] │ The canoe birch slid on the smooth planks.
#> [2] │ Glue sheet the to the dark blue background.
#> [3] │ It's to easy tell the depth of a well.
#> [4] │ These a days chicken leg is a rare dish.
#> [5] │ Rice often is served in round bowls.
#> [6] │ The of juice lemons makes fine punch.
#> ... and 714 more
Her grubun eşleşmelerini çıkarmak istiyorsanız str_match() kullanabilirsiniz. Ancak str_match() bir matris döndürdüğü için onunla çalışmak pek kolay değildir8:
Sonucu bir tibble’a dönüştürüp sütunları adlandırabilirsiniz:
sentences |>
  str_match("the (\\w+) (\\w+)") |>
  as_tibble(.name_repair = "minimal") |>
  set_names("match", "word1", "word2")
#> # A tibble: 720 × 3
#>   match             word1  word2
#>   <chr>             <chr>  <chr>
#> 1 the smooth planks smooth planks
#> 2 the sheet to      sheet  to
#> 3 the depth of      depth  of
#> 4 <NA>              <NA>   <NA>
#> 5 <NA>              <NA>   <NA>
#> 6 <NA>              <NA>   <NA>
#> # ℹ 714 more rows
Ancak bu durumda temelde kendi separate_wider_regex() sürümünüzü yeniden oluşturmuş olursunuz. Gerçekten de separate_wider_regex() arka planda kalıp vektörünüzü, adlandırılmış bileşenleri yakalamak için gruplama kullanan tek bir regex’e dönüştürür.
Bazen eşleşme grubu oluşturmadan parantez kullanmak isteyebilirsiniz. (?:) ile yakalamayan bir grup oluşturabilirsiniz.
15.4.7 Alıştırmalar
Değişmez
"'\karakter dizisiyle nasıl eşleşirsiniz? Peki ya"$^$"ile?Şu kalıpların neden
\ile eşleşmediğini açıklayın:"\","\\","\\\".-
stringr::wordsiçindeki yaygın sözcük derlemini kullanarak aşağıdaki özelliklere sahip tüm sözcükleri bulan düzenli ifadeler oluşturun:- “y” ile başlayan.
- “y” ile başlamayan.
- “x” ile biten.
- Tam olarak üç harf uzunluğunda olan. (
str_length()kullanarak hile yapmayın!) - Yedi ya da daha fazla harften oluşan.
- Bir ünlü-ünsüz çifti içeren.
- Art arda en az iki ünlü-ünsüz çifti içeren.
- Yalnızca yinelenen ünlü-ünsüz çiftlerinden oluşan.
Aşağıdaki sözcüklerin Britanya ya da Amerikan yazımlarıyla eşleşen 11 düzenli ifade oluşturun: airplane/aeroplane, aluminum/aluminium, analog/analogue, ass/arse, center/centre, defense/defence, donut/doughnut, gray/grey, modeling/modelling, skeptic/sceptic, summarize/summarise. Olabilecek en kısa regex’i oluşturmaya çalışın!
wordsiçindeki ilk ve son harflerin yerlerini değiştirin. Ortaya çıkan karakter dizilerinden hangileri hâlâwordsiçinde yer alır?-
Aşağıdaki düzenli ifadelerin neyle eşleştiğini sözcüklerle açıklayın. (Her girdinin bir düzenli ifade mi yoksa düzenli ifade tanımlayan bir karakter dizisi mi olduğunu dikkatle inceleyin.)
^.*$"\\{.+\\}"\d{4}-\d{2}-\d{2}"\\\\{4}"\..\..\..(.)\1\1"(..)\\1"
https://regexcrossword.com/challenges/beginner adresindeki başlangıç düzeyi regex bulmacalarını çözün.
15.5 Kalıp denetimi
Yalnızca bir karakter dizisi yerine kalıp nesnesi kullanarak eşleşmenin ayrıntıları üzerinde ek denetim sağlayabilirsiniz. Bu, aşağıda açıklandığı gibi regex bayraklarını denetlemenize ve çeşitli sabit karakter dizisi türleriyle eşleşmenize olanak tanır.
15.5.1 Regex bayrakları
Regex’in ayrıntılarını denetlemek için kullanılabilecek çeşitli ayarlar vardır. Bu ayarlara diğer programlama dillerinde çoğunlukla bayrak denir. stringr’da kalıbı bir regex() çağrısıyla sarmalayarak bunları kullanabilirsiniz. En yararlı bayrak büyük olasılıkla ignore_case = TRUE’dur; çünkü karakterlerin hem büyük hem de küçük harf biçimleriyle eşleşmesini sağlar:
Çok satırlı karakter dizileriyle (yani \n içeren karakter dizileriyle) sık çalışıyorsanız dotall ve multiline da yararlı olabilir:
-
dotall = TRUE,.işaretinin\ndahil her şeyle eşleşmesini sağlar: -
multiline = TRUE,^ve$işaretlerinin karakter dizisinin tamamının başlangıcı ve sonu yerine her satırın başlangıcı ve sonuyla eşleşmesini sağlar:
Son olarak karmaşık bir düzenli ifade yazıyor ve gelecekte onu anlayamayacağınızdan kaygılanıyorsanız comments = TRUE seçeneğini deneyebilirsiniz. Bu seçenek kalıp dilini; boşlukları, yeni satırları ve # sonrasındaki her şeyi yok sayacak biçimde değiştirir. Böylece aşağıdaki örnekte olduğu gibi karmaşık düzenli ifadeleri daha anlaşılır kılmak için yorum ve boşluk kullanabilirsiniz9:
phone <- regex(
  r"(
    \(?     # isteğe bağlı açılış parantezi
    (\d{3}) # alan kodu
    [)\-]?  # isteğe bağlı kapanış parantezi veya kısa çizgi
    \ ?     # isteğe bağlı boşluk
    (\d{3}) # üç rakam daha
    [\ -]?  # isteğe bağlı boşluk veya kısa çizgi
    (\d{4}) # dört rakam daha
  )",
  comments = TRUE
)

str_extract(c("514-791-8141", "(123) 456 7890", "123456"), phone)
#> [1] "514-791-8141"   "(123) 456 7890" NA
Yorum kullanırken bir boşluk, yeni satır veya # ile eşleşmek istiyorsanız onu \ ile kaçırmanız gerekir.
15.5.2 Sabit eşleşmeler
fixed() kullanarak düzenli ifade kurallarını devre dışı bırakabilirsiniz:
fixed() ayrıca büyük-küçük harf ayrımını yok saymanıza olanak tanır:
İngilizce dışındaki metinlerle çalışıyorsanız belirttiğiniz locale tarafından kullanılan büyük-küçük harf kurallarının tamamını uyguladığı için büyük olasılıkla fixed() yerine coll() kullanmak isteyeceksiniz. Yerel ayarlar hakkında daha fazla bilgi için Bölüm 14.6 bölümüne bakın.
15.6 Uygulama
Bu fikirleri uygulamaya koymak için sırada gerçeğe yakın birkaç problem çözeceğiz. Üç genel tekniği ele alacağız:
- basit pozitif ve negatif kontroller oluşturarak çalışmanızı denetlemek,
- düzenli ifadeleri Boole cebiriyle birleştirmek,
- karakter dizisi işlemleriyle karmaşık kalıplar oluşturmak.
15.6.1 Çalışmanızı denetleme
Önce “The” ile başlayan tüm cümleleri bulalım. Yalnızca ^ sabitleyicisini kullanmak yeterli değildir:
str_view(sentences, "^The")
#>  [1] │ <The> birch canoe slid on the smooth planks.
#>  [4] │ <The>se days a chicken leg is a rare dish.
#>  [6] │ <The> juice of lemons makes fine punch.
#>  [7] │ <The> box was thrown beside the parked truck.
#>  [8] │ <The> hogs were fed chopped corn and garbage.
#> [11] │ <The> boy was there when the sun rose.
#> ... and 271 more
Çünkü bu kalıp They veya These gibi sözcüklerle başlayan cümlelerle de eşleşir. “e” harfinin sözcüğün son harfi olduğundan emin olmamız gerekir; bunu bir sözcük sınırı ekleyerek yapabiliriz:
str_view(sentences, "^The\\b")
#>  [1] │ <The> birch canoe slid on the smooth planks.
#>  [6] │ <The> juice of lemons makes fine punch.
#>  [7] │ <The> box was thrown beside the parked truck.
#>  [8] │ <The> hogs were fed chopped corn and garbage.
#> [11] │ <The> boy was there when the sun rose.
#> [13] │ <The> source of the huge river is the clear spring.
#> ... and 250 more
Peki bir zamirle başlayan tüm cümleleri nasıl buluruz?
str_view(sentences, "^She|He|It|They\\b")
#>  [3] │ <It>'s easy to tell the depth of a well.
#> [15] │ <He>lp the woman get back to her feet.
#> [27] │ <He>r purse was full of useless trash.
#> [29] │ <It> snowed, rained, and hailed the same morning.
#> [63] │ <He> ran half way to the hardware store.
#> [90] │ <He> lay prone and hardly moved a limb.
#> ... and 57 more
Sonuçlara hızlıca baktığımızda bazı hatalı eşleşmeler elde ettiğimizi görürüz. Bunun nedeni parantez kullanmayı unutmamızdır:
str_view(sentences, "^(She|He|It|They)\\b")
#>   [3] │ <It>'s easy to tell the depth of a well.
#>  [29] │ <It> snowed, rained, and hailed the same morning.
#>  [63] │ <He> ran half way to the hardware store.
#>  [90] │ <He> lay prone and hardly moved a limb.
#> [116] │ <He> ordered peach pie with ice cream.
#> [127] │ <It> caught its hind paw in a rusty trap.
#> ... and 51 more
İlk birkaç eşleşmede ortaya çıkmasaydı böyle bir hatayı nasıl fark edebileceğinizi merak edebilirsiniz. İyi bir teknik, birkaç pozitif ve negatif eşleşme oluşturup kalıbınızın beklendiği gibi çalıştığını bunlarla sınamaktır:
pos <- c("He is a boy", "She had a good time")
neg <- c("Shells come from the sea", "Hadley said 'It's a great day'")

pattern <- "^(She|He|It|They)\\b"
str_detect(pos, pattern)
#> [1] TRUE TRUE
str_detect(neg, pattern)
#> [1] FALSE FALSE
İyi pozitif örnekler bulmak genellikle negatif örnekler bulmaktan çok daha kolaydır; çünkü zayıf noktalarınızı öngörecek kadar düzenli ifade deneyimi edinmek zaman alır. Yine de negatif örnekler yararlıdır: Problem üzerinde çalışırken hatalarınızdan oluşan bir koleksiyonu yavaş yavaş biriktirebilir ve aynı hatayı bir daha yapmamanızı sağlayabilirsiniz.
15.6.2 Boole işlemleri
Yalnızca ünsüz içeren sözcükleri bulmak istediğimizi düşünün. Bir teknik, ünlüler dışındaki tüm harfleri içeren bir karakter sınıfı oluşturmak ([^aeiou]), bunun herhangi bir sayıda harfle eşleşmesine izin vermek ([^aeiou]+) ve ardından başlangıç ile sona sabitleyerek karakter dizisinin tamamıyla eşleşmesini sağlamaktır (^[^aeiou]+$):
str_view(words, "^[^aeiou]+$")
#> [123] │ <by>
#> [249] │ <dry>
#> [328] │ <fly>
#> [538] │ <mrs>
#> [895] │ <try>
#> [952] │ <why>
Ancak probleme tersinden yaklaşarak onu biraz kolaylaştırabilirsiniz. Yalnızca ünsüz içeren sözcükleri aramak yerine hiç ünlü içermeyen sözcükleri arayabiliriz:
str_view(words[!str_detect(words, "[aeiou]")])
#> [1] │ by
#> [2] │ dry
#> [3] │ fly
#> [4] │ mrs
#> [5] │ try
#> [6] │ why
Bu, özellikle “ve” ya da “değil” içeren mantıksal birleşimlerle uğraşırken yararlı bir tekniktir. Örneğin hem “a” hem de “b” içeren tüm sözcükleri bulmak istediğinizi düşünün. Düzenli ifadelerde yerleşik bir “ve” operatörü olmadığından, ardından “b” gelen bir “a” ya da ardından “a” gelen bir “b” içeren tüm sözcükleri aramamız gerekir:
str_view(words, "a.*b|b.*a")
#>  [2] │ <ab>le
#>  [3] │ <ab>out
#>  [4] │ <ab>solute
#> [62] │ <availab>le
#> [66] │ <ba>by
#> [67] │ <ba>ck
#> ... and 24 more
İki str_detect() çağrısının sonuçlarını birleştirmek daha basittir:
words[str_detect(words, "a") & str_detect(words, "b")]
#>  [1] "able"      "about"     "absolute"  "available" "baby"      "back"
#>  [7] "bad"       "bag"       "balance"   "ball"      "bank"      "bar"
#> [13] "base"      "basis"     "bear"      "beat"      "beauty"    "because"
#> [19] "black"     "board"     "boat"      "break"     "brilliant" "britain"
#> [25] "debate"    "husband"   "labour"    "maybe"     "probable"  "table"
Tüm ünlüleri içeren bir sözcük olup olmadığını görmek isteseydik ne olurdu? Bunu kalıplarla yapsaydık 5!, yani 120 farklı kalıp üretmemiz gerekirdi:
words[str_detect(words, "a.*e.*i.*o.*u")]
# ...
words[str_detect(words, "u.*o.*i.*e.*a")]
Beş str_detect() çağrısını birleştirmek çok daha basittir:
words[
  str_detect(words, "a") &
  str_detect(words, "e") &
  str_detect(words, "i") &
  str_detect(words, "o") &
  str_detect(words, "u")
]
#> character(0)
Genel olarak probleminizi çözen tek bir regex oluşturmaya çalışırken takılırsanız bir adım geri atın ve problemi daha küçük parçalara bölüp her birini sırayla çözüp çözemeyeceğinizi düşünün.
15.6.3 Kodla kalıp oluşturma
Bir renkten söz eden tüm sentences öğelerini bulmak isteseydik ne olurdu? Temel fikir basittir: Almaşık eşleşmeyi sözcük sınırlarıyla birleştiririz.
str_view(sentences, "\\b(red|green|blue)\\b")
#>   [2] │ Glue the sheet to the dark <blue> background.
#>  [26] │ Two <blue> fish swam in the tank.
#>  [92] │ A wisp of cloud hung in the <blue> air.
#> [148] │ The spot on the blotter was made by <green> ink.
#> [160] │ The sofa cushion is <red> and of light weight.
#> [174] │ The sky that morning was clear and bright <blue>.
#> ... and 20 more
Ancak renk sayısı arttıkça bu kalıbı elle oluşturmak kısa sürede zahmetli hâle gelir. Renkleri bir vektörde saklayabilsek güzel olmaz mıydı?
rgb <- c("red", "green", "blue")Elbette saklayabiliriz! Yalnızca str_c() ve str_flatten() kullanarak vektörden kalıbı oluşturmamız gerekir:
str_c("\\b(", str_flatten(rgb, "|"), ")\\b")
#> [1] "\\b(red|green|blue)\\b"
İyi bir renk listemiz olsaydı bu kalıbı daha kapsamlı hâle getirebilirdik. Başlangıç noktalarından biri, R’ın grafiklerde kullanabildiği yerleşik renklerin listesi olabilir:
Ancak önce numaralandırılmış çeşitleri eleyelim:
cols <- colors()
cols <- cols[!str_detect(cols, "\\d")]
str_view(cols)
#> [1] │ white
#> [2] │ aliceblue
#> [3] │ antiquewhite
#> [4] │ aquamarine
#> [5] │ azure
#> [6] │ beige
#> ... and 137 more
Ardından bunu tek bir dev kalıba dönüştürebiliriz. Çok büyük olduğu için kalıbı burada göstermeyeceğiz ancak çalışmasını görebilirsiniz:
pattern <- str_c("\\b(", str_flatten(cols, "|"), ")\\b")
str_view(sentences, pattern)
#>   [2] │ Glue the sheet to the dark <blue> background.
#>  [12] │ A rod is used to catch <pink> <salmon>.
#>  [26] │ Two <blue> fish swam in the tank.
#>  [66] │ Cars and busses stalled in <snow> drifts.
#>  [92] │ A wisp of cloud hung in the <blue> air.
#> [112] │ Leaves turn <brown> and <yellow> in the fall.
#> ... and 57 more
Bu örnekte cols yalnızca rakam ve harf içerdiğinden metakarakterler konusunda kaygılanmanız gerekmez. Ancak genel olarak mevcut karakter dizilerinden kalıp oluşturduğunuzda değişmez biçimde eşleşmelerini sağlamak için bunları str_escape() işleminden geçirmek akıllıca olur.
15.6.4 Alıştırmalar
-
Aşağıdaki problemlerin her birini hem tek bir düzenli ifadeyle hem de birden çok
str_detect()çağrısının birleşimiyle çözmeyi deneyin.-
xile başlayan veya biten tümwordsöğelerini bulun. - Bir ünlüyle başlayıp ünsüzle biten tüm
wordsöğelerini bulun. - Her ünlüden en az bir tane içeren
wordsöğesi var mı?
-
“c’den sonra olmadığı sürece i, e’den önce gelir” kuralını destekleyen ve çürüten örnekleri bulmak için kalıplar oluşturun.
colors(), “lightgray” ve “darkblue” gibi çeşitli niteleyiciler içerir. Bu niteleyicileri otomatik olarak nasıl belirleyebilirsiniz? (Nitelenmiş renkleri nasıl saptayıp kaldırabileceğinizi düşünün.)Herhangi bir temel R veri kümesini bulan bir düzenli ifade oluşturun. Bu veri kümelerinin listesini
data()fonksiyonunun özel bir kullanımıyla alabilirsiniz:data(package = "datasets")$results[, "Item"]. Bazı eski veri kümelerinin ayrı vektörler olduğunu unutmayın; bunlar gruplandıkları “veri çerçevesinin” adını parantez içinde içerir, dolayısıyla bu bölümleri kaldırmanız gerekir.
15.7 Başka yerlerde düzenli ifadeler
stringr ve tidyr fonksiyonlarında olduğu gibi R’ın başka pek çok yerinde de düzenli ifadeleri kullanabilirsiniz. Aşağıdaki bölümlerde tidyverse genelindeki ve temel R’daki bazı yararlı fonksiyonları açıklayacağız.
15.7.1 tidyverse
Düzenli ifadeleri kullanmak isteyebileceğiniz özellikle yararlı üç yer daha vardır:
matches(pattern), adı verilen kalıpla eşleşen tüm değişkenleri seçer. Bu, değişken seçen herhangi bir tidyverse fonksiyonunda (ör.select(),rename_with()veacross()) kullanabileceğiniz bir “tidyselect” fonksiyonudur.pivot_longer()fonksiyonununnames_patternargümanı, tıpkıseparate_wider_regex()gibi bir düzenli ifade vektörü alır. Karmaşık yapıya sahip değişken adlarından veri çıkarırken kullanışlıdır.separate_longer_delim()veseparate_wider_delim()içindekidelimargümanı genellikle sabit bir karakter dizisiyle eşleşir; ancak bir kalıpla eşleşmesini sağlamak içinregex()kullanabilirsiniz. Örneğin isteğe bağlı olarak ardından bir boşluk gelen virgülle, yaniregex(", ?")ile eşleşmek istiyorsanız bu kullanışlıdır.
15.7.2 Temel R
apropos(pattern), genel ortamda bulunan ve verilen kalıpla eşleşen tüm nesneleri arar. Bir fonksiyonun adını tam olarak hatırlayamıyorsanız bu yararlıdır:
apropos("replace")
#>  [1] "%+replace%"       "replace"          "replace_na"
#>  [4] "replace_theme"    "replace_values"   "replace_when"
#>  [7] "setReplaceMethod" "str_replace"      "str_replace_all"
#> [10] "str_replace_na"   "theme_replace"
list.files(path, pattern), path içindeki pattern düzenli ifadesiyle eşleşen tüm dosyaları listeler. Örneğin geçerli dizindeki tüm R Markdown dosyalarını şöyle bulabilirsiniz:
head(list.files(pattern = "\\.Rmd$"))
#> character(0)
Temel R’ın kullandığı kalıp dilinin stringr’ın kullandığından çok az farklı olduğunu belirtmekte yarar var. Bunun nedeni stringr’ın stringi paketi, stringi’nin de ICU motoru üzerine kurulmuş olmasıdır. Temel R fonksiyonları ise perl = TRUE ayarını kullanıp kullanmadığınıza bağlı olarak TRE motorunu veya PCRE motorunu kullanır. Neyse ki düzenli ifadelerin temelleri o kadar iyi yerleşmiştir ki bu kitapta öğreneceğiniz kalıplarla çalışırken çok az farklılıkla karşılaşırsınız. Bu farkı ancak karmaşık Unicode karakter aralıkları veya (?…) söz dizimini kullanan özel özellikler gibi ileri düzey işlevlere dayanmaya başladığınızda dikkate almanız gerekir.
15.8 Özet
Her noktalama işaretinin birden çok anlam taşıyabilmesi nedeniyle düzenli ifadeler var olan en yoğun dillerden biridir. Başlangıçta kesinlikle kafa karıştırıcıdır; ancak gözlerinizi okumaya, beyninizi anlamaya alıştırdıkça R’da ve daha pek çok yerde kullanabileceğiniz güçlü bir beceri kazanırsınız.
Bu bölümde en yararlı stringr fonksiyonlarını ve düzenli ifade dilinin en önemli bileşenlerini öğrenerek düzenli ifade ustası olma yolculuğunuza başladınız. Daha fazlasını öğrenebileceğiniz pek çok kaynak var.
Başlamak için iyi bir yer vignette("regular-expressions", package = "stringr") belgesidir: stringr’ın desteklediği söz diziminin tamamını açıklar. Bir başka yararlı kaynak https://www.regular-expressions.info/ sitesidir. R’a özgü değildir ancak regex’lerin en ileri özelliklerini ve arka planda nasıl çalıştıklarını öğrenmek için kullanabilirsiniz.
stringr’ın Marek Gagolewski’nin stringi paketi üzerine kurulduğunu bilmek de yararlıdır. stringr’da ihtiyacınız olan işi yapan bir fonksiyon bulmakta zorlanıyorsanız stringi’ye bakmaktan çekinmeyin. stringi, stringr ile aynı kuralların çoğunu izlediği için öğrenmesinin oldukça kolay olduğunu göreceksiniz.
Bir sonraki bölümde karakter dizileriyle yakından ilişkili bir veri yapısından, faktörlerden söz edeceğiz. Faktörler R’da kategorik verileri, yani olası değerleri sabit ve bilinen bir karakter dizisi vektörüyle tanımlanan verileri temsil etmek için kullanılır.
İngilizcede sert g (reg-x) veya yumuşak g (rej-x) ile okunabilir.↩︎
Bu özel anlamlardan nasıl kaçacağınızı Bölüm 15.4.1 bölümünde öğreneceksiniz.↩︎
Daha doğrusu
\ndışındaki herhangi bir karakter.↩︎Bu hesaplama “x” içeren adların oranını verir. Adında x bulunan bebeklerin oranını isteseydiniz ağırlıklı ortalama hesaplamanız gerekirdi.↩︎
Gerçek yaşamda bu kadar tuhaf bir şeyle hiç karşılaşmayacağınızı söyleyebilmek isterdik; ne yazık ki kariyeriniz boyunca çok daha tuhaf veriler görmeniz olasıdır!↩︎
Üst karakterlerin tam kümesi
.^$\|*+?{}[]()biçimindedir.↩︎\dveya\siçeren bir düzenli ifade oluşturmak için karakter dizisindeki\işaretini kaçırmanız gerektiğini unutmayın; yani"\\d"veya"\\s"yazmalısınız.↩︎Bunun temel nedeni, bu kitapta matrisleri hiç ele almamamızdır!↩︎
comments = TRUE, burada kullandığımız gibi ham bir karakter dizisiyle birleştirildiğinde özellikle etkilidir.↩︎