23 Hiyerarşik veriler
23.1 Giriş
Bu bölümde verileri dikdörtgensel hâle getirme sanatını öğreneceksiniz: Temelde hiyerarşik ya da ağaç benzeri verileri alıp satır ve sütunlardan oluşan dikdörtgensel bir veri çerçevesine dönüştürme. Bu önemlidir; çünkü özellikle web’den gelen verilerle çalışırken hiyerarşik veriler şaşırtıcı derecede yaygındır.
Dikdörtgensel hâle getirmeyi öğrenmek için önce hiyerarşik verileri mümkün kılan veri yapısını, yani listeleri öğrenmeniz gerekir. Ardından iki önemli tidyr fonksiyonunu öğreneceksiniz: tidyr::unnest_longer() ve tidyr::unnest_wider(). Daha sonra gerçek problemleri çözmek için bu basit fonksiyonları tekrar tekrar uyguladığımız birkaç örnek olay göstereceğiz. Son olarak hiyerarşik veri kümelerinin en yaygın kaynağı ve web’de veri alışverişi için sık kullanılan bir biçim olan JSON’u ele alacağız.
23.1.1 Ön koşullar
Bu bölümde tidyverse’in temel üyelerinden tidyr’ın birçok fonksiyonunu kullanacağız. Dikdörtgensel hâle getirme alıştırmaları için ilginç veri kümeleri sağlayan repurrrsive paketinden de yararlanacak, son olarak JSON dosyalarını R listelerine okumak için jsonlite kullanacağız.
23.2 Listeler
Şimdiye kadar tam sayı, ondalıklı sayı, karakter, tarih-saat ve faktör gibi basit vektörleri içeren veri çerçeveleriyle çalıştınız. Bu vektörler homojen oldukları, yani her öğeleri aynı veri türünde olduğu için basittir. Farklı türlerdeki öğeleri aynı vektörde saklamak isterseniz list() ile oluşturacağınız bir listeye ihtiyacınız vardır:
x1 <- list(1:4, "a", TRUE)
x1
#> [[1]]
#> [1] 1 2 3 4
#>
#> [[2]]
#> [1] "a"
#>
#> [[3]]
#> [1] TRUE
Bir listenin bileşenlerini ya da çocuklarını adlandırmak çoğu zaman kullanışlıdır; bunu bir tibble’ın sütunlarını adlandırdığınız gibi yapabilirsiniz:
x2 <- list(a = 1:2, b = 1:3, c = 1:4)
x2
#> $a
#> [1] 1 2
#>
#> $b
#> [1] 1 2 3
#>
#> $c
#> [1] 1 2 3 4
Bu çok basit listeler bile yazdırıldığında oldukça fazla yer kaplar. Kullanışlı bir seçenek, içeriği geri plana atıp yapının (structure) kısa bir gösterimini üreten str() fonksiyonudur:
Gördüğünüz gibi str() listenin her çocuğunu ayrı bir satırda gösterir. Varsa önce adı, ardından türün kısaltmasını ve ilk birkaç değeri görüntüler.
23.2.1 Hiyerarşi
Listeler, başka listeler dahil her tür nesneyi içerebilir. Bu özellik onları hiyerarşik (ağaç benzeri) yapıları temsil etmeye uygun kılar:
Bu, düz bir vektör üreten c() fonksiyonundan belirgin biçimde farklıdır:
Listeler karmaşıklaştıkça hiyerarşiyi bir bakışta görmenizi sağlayan str() daha da kullanışlı hâle gelir:
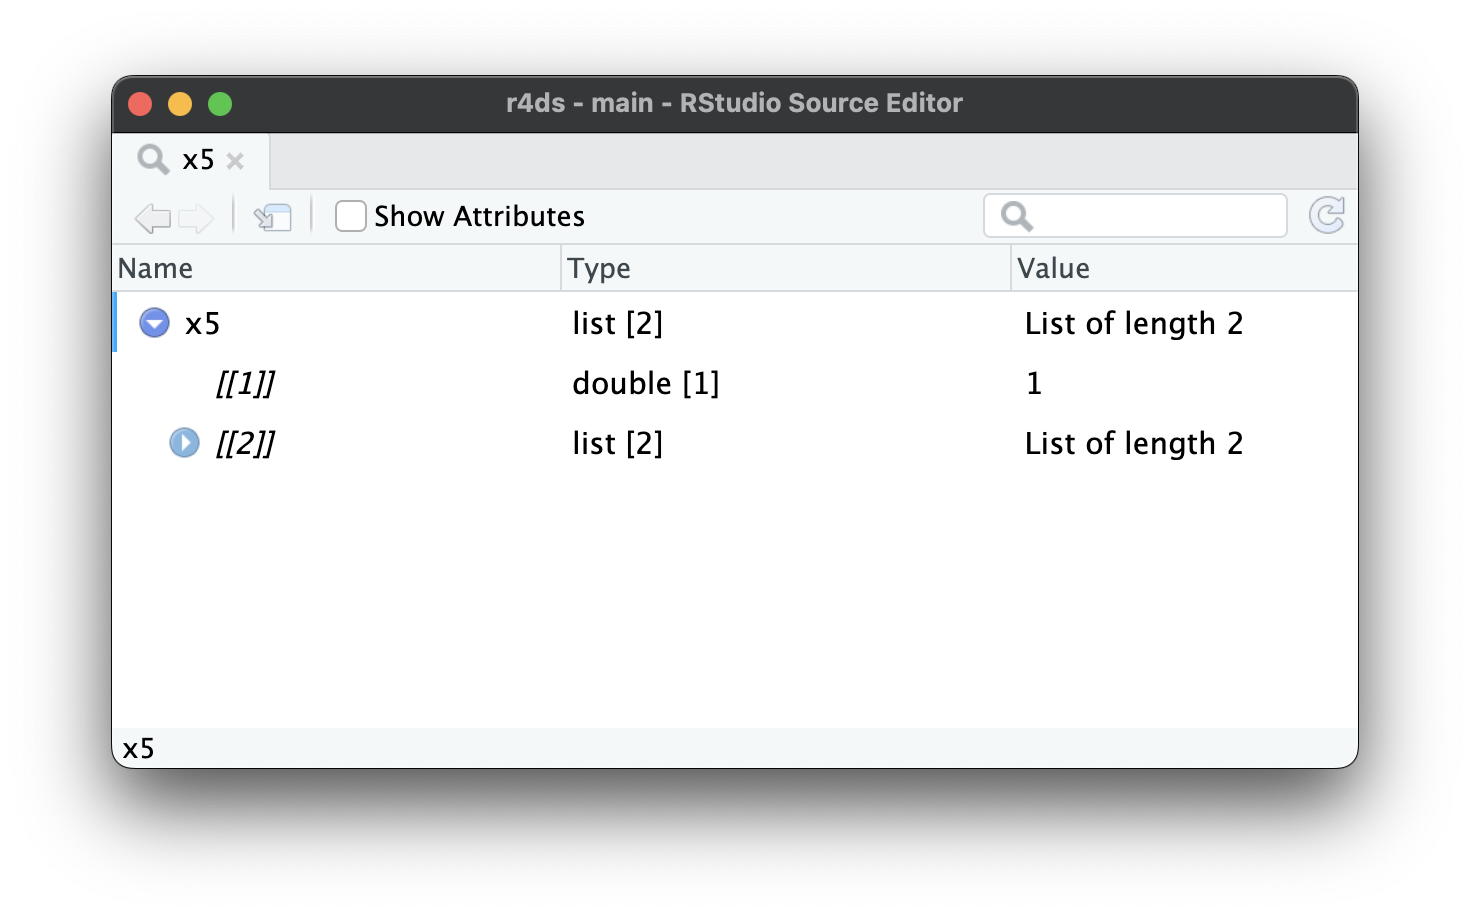
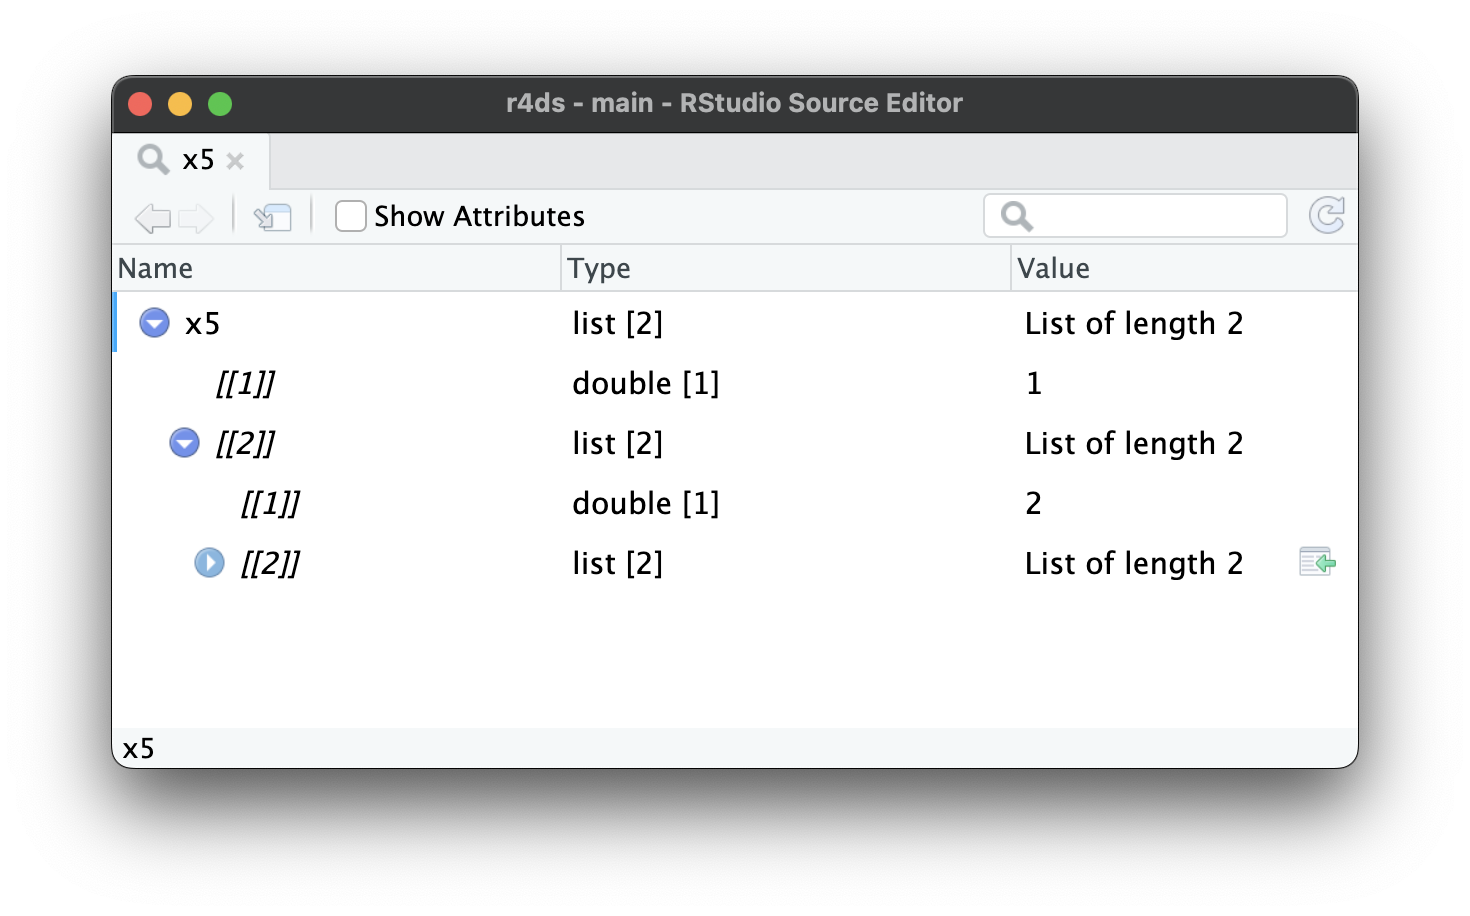
Listeler daha da büyüyüp karmaşıklaştıkça str() sonunda yetersiz kalır ve View() fonksiyonuna geçmeniz gerekir1. Şekil 23.1, View(x5) çağrısının sonucunu gösterir. Görüntüleyici başlangıçta yalnızca listenin en üst düzeyini gösterir; ancak Şekil 23.2 içinde olduğu gibi daha fazlasını görmek için bileşenleri etkileşimli olarak genişletebilirsiniz. RStudio, Şekil 23.3 içinde olduğu gibi bu öğeye erişmek için gereken kodu da gösterir. Bu kodun nasıl çalıştığına Bölüm 27.3 bölümünde geri döneceğiz.
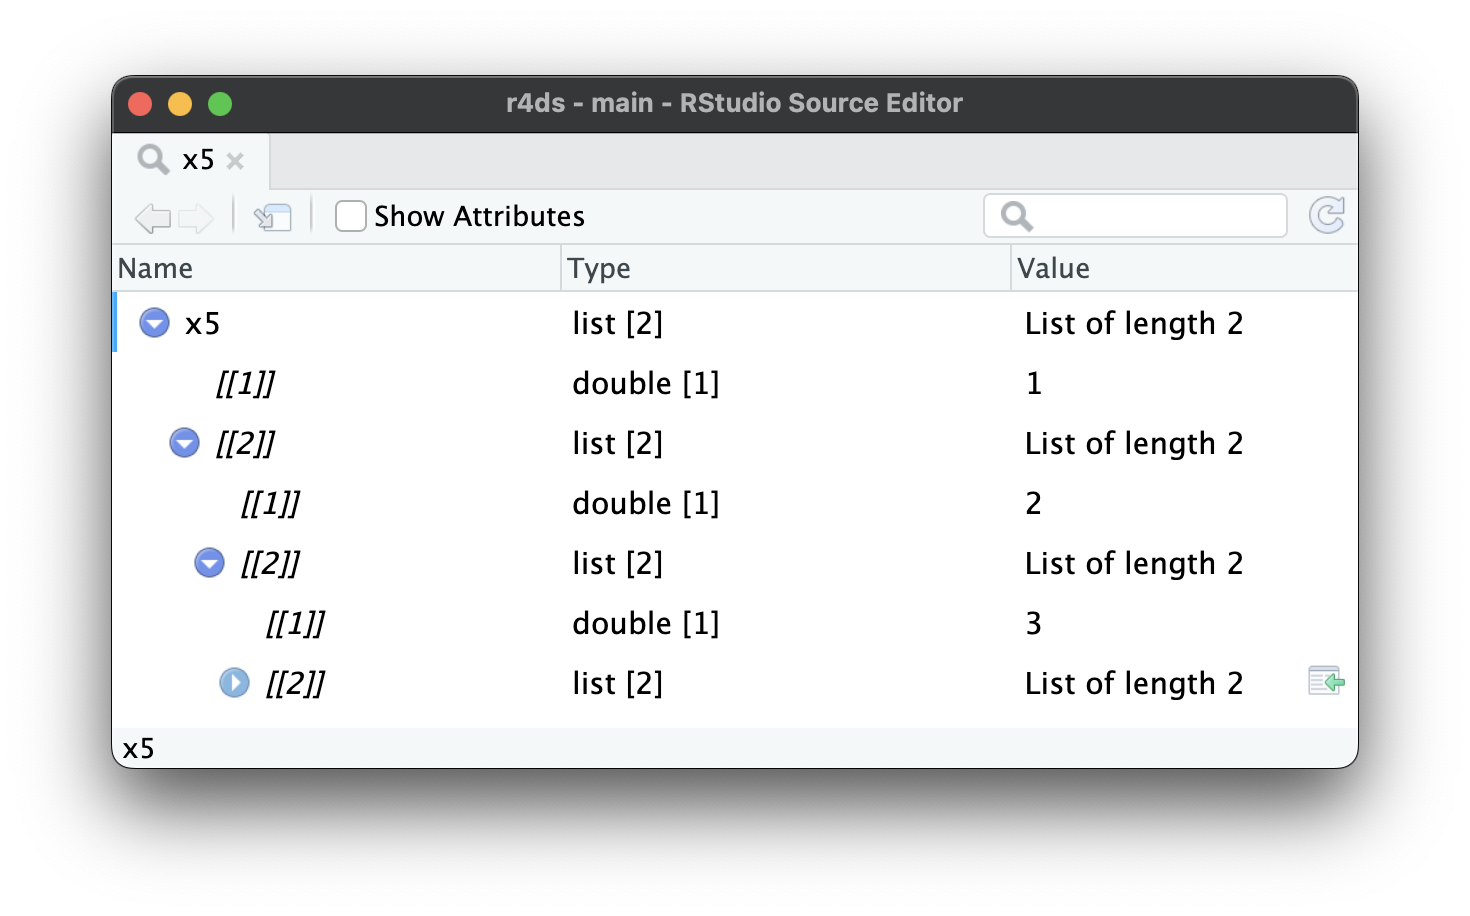
x5[[2]][[2]][[2]].
23.2.2 Liste sütunları
Listeler bir tibble’ın içinde de bulunabilir; bunlara liste sütunları denir. Liste sütunları, normalde bir tibble içinde yer alamayacak nesneleri tibble’a koymanızı sağladığı için kullanışlıdır. Özellikle model çıktıları veya yeniden örneklemeler gibi nesneleri bir veri çerçevesinde saklamaya olanak tanıdıklarından tidymodels ekosisteminde çok kullanılırlar.
İşte basit bir liste sütunu örneği:
Bir tibble içindeki listelerin özel bir yanı yoktur; diğer sütunlar gibi davranırlar:
df |>
  filter(x == 1)
#> # A tibble: 1 × 3
#>       x y     z
#>   <int> <chr> <list>
#> 1     1 a     <list [2]>
Liste sütunlarıyla hesaplama yapmak daha zordur; çünkü genel olarak listelerle hesaplama yapmak daha zordur. Bu konuya Bölüm 26 bölümünde geri döneceğiz. Bu bölümde, var olan araçlarınızı kullanabilmeniz için liste sütunlarını iç içe yapıdan çıkarıp sıradan değişkenlere dönüştürmeye odaklanacağız.
Varsayılan yazdırma yöntemi içeriğin yalnızca kaba bir özetini gösterir. Liste sütunu istenildiği kadar karmaşık olabileceğinden onu yazdırmanın iyi bir yolu yoktur. Görmek isterseniz yalnızca ilgili liste sütununu çıkarmanız ve yukarıda öğrendiğiniz tekniklerden birini uygulamanız gerekir; örneğin df |> pull(z) |> str() veya df |> pull(z) |> View().
Bir listeyi data.frame sütununa koymak mümkündür; ancak data.frame() listeyi bir sütun listesi olarak ele aldığı için bu işlem çok daha uğraştırıcıdır:
data.frame(x = list(1:3, 3:5))
#>   x.1.3 x.3.5
#> 1     1     3
#> 2     2     4
#> 3     3     5
Listeyi I() içine alarak data.frame() fonksiyonunu onu satır listesi olarak ele almaya zorlayabilirsiniz; ancak sonuç pek iyi yazdırılmaz:
data.frame(
  x = I(list(1:2, 3:5)),
  y = c("1, 2", "3, 4, 5")
)
#>         x       y
#> 1    1, 2    1, 2
#> 2 3, 4, 5 3, 4, 5
tibble() listeleri vektör gibi ele aldığından ve yazdırma yöntemi listeler düşünülerek tasarlandığından tibble’larla liste sütunlarını kullanmak daha kolaydır.
23.3 İç içe yapıdan çıkarma
Listelerin ve liste sütunlarının temellerini öğrendiğinize göre bunları nasıl yeniden sıradan satır ve sütunlara dönüştürebileceğinizi inceleyelim. Temel fikri anlayabilmeniz için burada çok basit örnek veriler kullanacağız; sonraki kısımda gerçek verilere geçeceğiz.
Liste sütunları iki temel biçimde karşımıza çıkar: adlandırılmış ve adlandırılmamış. Çocuklar adlandırılmış olduğunda genellikle her satırda aynı adlara sahip olurlar. Örneğin df1 içinde y liste sütununun her öğesinde a ve b adlı iki öğe vardır. Adlandırılmış liste sütunları doğal olarak sütunlara açılır: Her adlandırılmış öğe yeni bir adlandırılmış sütun olur.
Çocuklar adlandırılmamış olduğunda öğe sayısı genellikle satırdan satıra değişir. Örneğin df2 içinde y liste sütununun öğeleri adlandırılmamıştır ve uzunlukları bir ile üç arasında değişir. Adlandırılmamış liste sütunları doğal olarak satırlara açılır: Her çocuk için bir satır elde edersiniz.
tidyr bu iki durum için iki fonksiyon sağlar: unnest_wider() ve unnest_longer(). Aşağıdaki kısımlar bunların nasıl çalıştığını açıklar.
23.3.1 unnest_wider()
df1 örneğindeki gibi her satırda aynı adlara sahip aynı sayıda öğe olduğunda, unnest_wider() ile her bileşeni kendi sütununa koymak doğaldır:
df1 |>
  unnest_wider(y)
#> # A tibble: 3 × 3
#>       x     a     b
#>   <dbl> <dbl> <dbl>
#> 1     1    11    12
#> 2     2    21    22
#> 3     3    31    32
Varsayılan olarak yeni sütunların adları yalnızca liste öğelerinin adlarından gelir; ancak sütun adıyla öğe adını birleştirmek için names_sep argümanını kullanabilirsiniz. Bu, yinelenen adlardaki belirsizliği gidermek için kullanışlıdır.
df1 |>
  unnest_wider(y, names_sep = "_")
#> # A tibble: 3 × 3
#>       x   y_a   y_b
#>   <dbl> <dbl> <dbl>
#> 1     1    11    12
#> 2     2    21    22
#> 3     3    31    32
23.3.2 unnest_longer()
Her satır adlandırılmamış bir liste içerdiğinde, unnest_longer() ile her öğeyi kendi satırına koymak en doğal yaklaşımdır:
df2 |>
  unnest_longer(y)
#> # A tibble: 6 × 2
#>       x     y
#>   <dbl> <dbl>
#> 1     1    11
#> 2     1    12
#> 3     1    13
#> 4     2    21
#> 5     3    31
#> 6     3    32
x değerinin y içindeki her öğe için yinelendiğine dikkat edin: Liste sütunundaki her öğe için bir çıktı satırı elde ederiz. Peki aşağıdaki örnekte olduğu gibi öğelerden biri boşsa ne olur?
df6 <- tribble(
  ~x, ~y,
  "a", list(1, 2),
  "b", list(3),
  "c", list()
)
df6 |> unnest_longer(y)
#> # A tibble: 3 × 2
#>   x         y
#>   <chr> <dbl>
#> 1 a         1
#> 2 a         2
#> 3 b         3
Çıktıda sıfır satır elde ettiğimiz için ilgili satır fiilen kaybolur. Bu satırı y içine NA ekleyerek korumak istiyorsanız keep_empty = TRUE ayarını kullanın.
23.3.3 Tutarsız türler
Farklı vektör türleri içeren bir liste sütununu iç içe yapıdan çıkarırsanız ne olur? Örneğin y liste sütununun normalde tek bir sütunda karıştırılamayacak iki sayı, bir karakter ve bir mantıksal değer içerdiği aşağıdaki veri kümesini ele alın.
unnest_longer() satır sayısını değiştirirken sütun kümesini her zaman aynı tutar. Öyleyse ne olur? unnest_longer() her şeyi y içinde tutarken nasıl beş satır üretir?
df4 |>
  unnest_longer(y)
#> # A tibble: 4 × 2
#>   x     y
#>   <chr> <list>
#> 1 a     <dbl [1]>
#> 2 b     <chr [1]>
#> 3 b     <lgl [1]>
#> 4 b     <dbl [1]>
Gördüğünüz gibi çıktı bir liste sütunu içerir; ancak liste sütununun her öğesinde tek bir öğe vardır. unnest_longer() ortak bir vektör türü bulamadığından özgün türleri bir liste sütununda tutar. Bunun, bir sütunun her öğesinin aynı türde olması gerektiği kuralını çiğneyip çiğnemediğini merak edebilirsiniz. Çiğnemez: İçerikleri farklı türlerde olsa da her öğe bir listedir.
Tutarsız türlerle uğraşmak zordur ve ayrıntılar problemin niteliğine ve hedeflerinize bağlıdır; ancak büyük olasılıkla Bölüm 26 bölümündeki araçlara ihtiyacınız olacaktır.
23.3.4 Diğer fonksiyonlar
tidyr’ın bu kitapta ele almayacağımız birkaç kullanışlı dikdörtgensel hâle getirme fonksiyonu daha vardır:
-
unnest_auto(), liste sütununun yapısına göreunnest_longer()ileunnest_wider()arasında otomatik olarak seçim yapar. Hızlı keşif için iyidir; ancak verilerinizin nasıl yapılandığını anlamanızı zorunlu kılmadığı ve kodunuzu anlamayı güçleştirdiği için sonuçta iyi bir fikir değildir. -
unnest()hem satırları hem sütunları genişletir. Veri çerçevesi gibi iki boyutlu bir yapı içeren liste sütununuz olduğunda kullanışlıdır. Bu kitapta böyle bir yapı görmeyeceksiniz, ancak tidymodels ekosistemini kullanırsanız karşılaşabilirsiniz.
Başkalarının kodunu okurken veya daha seyrek karşılaşılan dikdörtgensel hâle getirme problemlerini çözerken karşınıza çıkabileceklerinden bu fonksiyonları bilmek yararlıdır.
23.3.5 Alıştırmalar
unnest_wider()fonksiyonunudf2gibi adlandırılmamış liste sütunlarıyla kullandığınızda ne olur? Artık hangi argüman gereklidir? Eksik değerlere ne olur?unnest_longer()fonksiyonunudf1gibi adlandırılmış liste sütunlarıyla kullandığınızda ne olur? Çıktıda hangi ek bilgiyi alırsınız? Bu ek ayrıntıyı nasıl gizleyebilirsiniz?-
Zaman zaman değerleri hizalanmış birden çok liste sütunu içeren veri çerçeveleriyle karşılaşırsınız. Örneğin aşağıdaki veri çerçevesinde
yvezdeğerleri hizalanmıştır (yani bir satır içindeyvezher zaman aynı uzunluğa sahiptir vey’nin ilk değeriz’nin ilk değerine karşılık gelir). Bu veri çerçevesine ikiunnest_longer()çağrısı uygularsanız ne olur?xileyarasındaki ilişkiyi nasıl koruyabilirsiniz? (İpucu: Belgeleri dikkatle okuyun.)
23.4 Örnek olaylar
Yukarıda kullandığımız basit örneklerle gerçek veriler arasındaki temel fark, gerçek verilerin genellikle birden çok unnest_longer() ve/veya unnest_wider() çağrısı gerektiren çok düzeyli iç içe yapılar içermesidir. Bunu uygulamada göstermek için bu kısımda repurrrsive paketindeki veri kümelerini kullanarak üç gerçek dikdörtgensel hâle getirme problemini çözeceğiz.
23.4.1 Çok geniş veriler
gh_repos ile başlayacağız. Bu, GitHub API kullanılarak alınan bir GitHub deposu koleksiyonu hakkında veriler içeren bir listedir. Çok derin iç içe geçmiş bir liste olduğundan yapısını bu kitapta göstermek zordur; devam etmeden önce View(gh_repos) ile kendi başınıza biraz incelemenizi öneririz.
gh_repos bir listedir, ancak araçlarımız liste sütunlarıyla çalışır; bu nedenle işe onu bir tibble’a koyarak başlayacağız. Daha sonra açıklayacağımız nedenlerle bu sütuna json adını veriyoruz.
repos <- tibble(json = gh_repos)
repos
#> # A tibble: 6 × 1
#>   json
#>   <list>
#> 1 <list [30]>
#> 2 <list [30]>
#> 3 <list [30]>
#> 4 <list [26]>
#> 5 <list [30]>
#> 6 <list [30]>
Bu tibble, gh_repos listesinin her çocuğu için bir tane olmak üzere 6 satır içerir. Her satır 26 ya da 30 öğeli adlandırılmamış bir liste içerir. Bunlar adlandırılmamış olduğundan her çocuğu kendi satırına koymak için unnest_longer() ile başlayacağız:
repos |>
  unnest_longer(json)
#> # A tibble: 176 × 1
#>   json
#>   <list>
#> 1 <named list [68]>
#> 2 <named list [68]>
#> 3 <named list [68]>
#> 4 <named list [68]>
#> 5 <named list [68]>
#> 6 <named list [68]>
#> # ℹ 170 more rows
İlk bakışta durumu iyileştirmemişiz gibi görünebilir: Daha fazla satırımız olsa da (6 yerine 176) json sütununun her öğesi hâlâ bir listedir. Ancak önemli bir fark vardır: Artık her öğe adlandırılmış bir listedir; dolayısıyla her öğeyi kendi sütununa koymak için unnest_wider() kullanabiliriz:
repos |>
  unnest_longer(json) |>
  unnest_wider(json)
#> # A tibble: 176 × 68
#>         id name        full_name         owner        private html_url
#>      <int> <chr>       <chr>             <list>       <lgl>   <chr>
#> 1 61160198 after       gaborcsardi/after <named list> FALSE   https://github…
#> 2 40500181 argufy      gaborcsardi/argu… <named list> FALSE   https://github…
#> 3 36442442 ask         gaborcsardi/ask   <named list> FALSE   https://github…
#> 4 34924886 baseimports gaborcsardi/base… <named list> FALSE   https://github…
#> 5 61620661 citest      gaborcsardi/cite… <named list> FALSE   https://github…
#> 6 33907457 clisymbols  gaborcsardi/clis… <named list> FALSE   https://github…
#> # ℹ 170 more rows
#> # ℹ 62 more variables: description <chr>, fork <lgl>, url <chr>, …
Bu işe yaradı, ancak sonuç biraz bunaltıcıdır: O kadar çok sütun vardır ki tibble hepsini yazdırmaz bile! Tümünü names() ile görebiliriz; burada ilk 10’una bakıyoruz:
repos |>
  unnest_longer(json) |>
  unnest_wider(json) |>
  names() |>
  head(10)
#>  [1] "id"          "name"        "full_name"   "owner"       "private"
#>  [6] "html_url"    "description" "fork"        "url"         "forks_url"
İlginç görünen birkaçını seçelim:
repos |>
  unnest_longer(json) |>
  unnest_wider(json) |>
  select(id, full_name, owner, description)
#> # A tibble: 176 × 4
#>         id full_name               owner             description
#>      <int> <chr>                   <list>            <chr>
#> 1 61160198 gaborcsardi/after       <named list [17]> Run Code in the Backgro…
#> 2 40500181 gaborcsardi/argufy      <named list [17]> Declarative function ar…
#> 3 36442442 gaborcsardi/ask         <named list [17]> Friendly CLI interactio…
#> 4 34924886 gaborcsardi/baseimports <named list [17]> Do we get warnings for …
#> 5 61620661 gaborcsardi/citest      <named list [17]> Test R package and repo…
#> 6 33907457 gaborcsardi/clisymbols  <named list [17]> Unicode symbols for CLI…
#> # ℹ 170 more rows
Bundan yola çıkarak gh_repos listesinin nasıl yapılandırıldığını anlayabilirsiniz: Her çocuk, oluşturduğu en fazla 30 GitHub deposunun listesini içeren bir GitHub kullanıcısıdır.
owner başka bir liste sütunudur ve adlandırılmış bir liste içerdiğinden değerlere erişmek için unnest_wider() kullanabiliriz:
repos |>
  unnest_longer(json) |>
  unnest_wider(json) |>
  select(id, full_name, owner, description) |>
  unnest_wider(owner)
#> Error in `unnest_wider()`:
#> ! Can't duplicate names between the affected columns and the original
#>   data.
#> ✖ These names are duplicated:
#>   ℹ `id`, from `owner`.
#> ℹ Use `names_sep` to disambiguate using the column name.
#> ℹ Or use `names_repair` to specify a repair strategy.
Eyvah, bu liste sütunu da bir id sütunu içeriyor ve aynı veri çerçevesinde iki id sütunu bulunamaz. Önerildiği gibi sorunu çözmek için names_sep kullanalım:
repos |>
  unnest_longer(json) |>
  unnest_wider(json) |>
  select(id, full_name, owner, description) |>
  unnest_wider(owner, names_sep = "_")
#> # A tibble: 176 × 20
#>         id full_name               owner_login owner_id owner_avatar_url
#>      <int> <chr>                   <chr>          <int> <chr>
#> 1 61160198 gaborcsardi/after       gaborcsardi   660288 https://avatars.gith…
#> 2 40500181 gaborcsardi/argufy      gaborcsardi   660288 https://avatars.gith…
#> 3 36442442 gaborcsardi/ask         gaborcsardi   660288 https://avatars.gith…
#> 4 34924886 gaborcsardi/baseimports gaborcsardi   660288 https://avatars.gith…
#> 5 61620661 gaborcsardi/citest      gaborcsardi   660288 https://avatars.gith…
#> 6 33907457 gaborcsardi/clisymbols  gaborcsardi   660288 https://avatars.gith…
#> # ℹ 170 more rows
#> # ℹ 15 more variables: owner_gravatar_id <chr>, owner_url <chr>, …
Bu da başka bir geniş veri kümesi üretir; ancak owner sütununun depoya “sahip olan” kişi hakkında çok sayıda ek veri içerdiğini anlayabilirsiniz.
23.4.2 İlişkisel veriler
İç içe veriler bazen normalde birden çok veri çerçevesine dağıtacağımız verileri temsil etmek için kullanılır. Örneğin Game of Thrones kitaplarında ve televizyon dizisinde yer alan karakterler hakkında veriler içeren got_chars nesnesini ele alın. gh_repos gibi bu da bir listedir; dolayısıyla onu bir tibble’ın liste sütununa dönüştürerek başlarız:
chars <- tibble(json = got_chars)
chars
#> # A tibble: 30 × 1
#>   json
#>   <list>
#> 1 <named list [18]>
#> 2 <named list [18]>
#> 3 <named list [18]>
#> 4 <named list [18]>
#> 5 <named list [18]>
#> 6 <named list [18]>
#> # ℹ 24 more rows
json sütunu adlandırılmış öğeler içerdiğinden onu genişleterek başlayacağız:
chars |>
  unnest_wider(json)
#> # A tibble: 30 × 18
#>   url                    id name            gender culture    born
#>   <chr>               <int> <chr>           <chr>  <chr>      <chr>
#> 1 https://www.anapio…  1022 Theon Greyjoy   Male   "Ironborn" "In 278 AC or …
#> 2 https://www.anapio…  1052 Tyrion Lannist… Male   ""         "In 273 AC, at…
#> 3 https://www.anapio…  1074 Victarion Grey… Male   "Ironborn" "In 268 AC or …
#> 4 https://www.anapio…  1109 Will            Male   ""         ""
#> 5 https://www.anapio…  1166 Areo Hotah      Male   "Norvoshi" "In 257 AC or …
#> 6 https://www.anapio…  1267 Chett           Male   ""         "At Hag's Mire"
#> # ℹ 24 more rows
#> # ℹ 12 more variables: died <chr>, alive <lgl>, titles <list>, …
Okumayı kolaylaştırmak için birkaç sütun seçelim:
characters <- chars |>
  unnest_wider(json) |>
  select(id, name, gender, culture, born, died, alive)
characters
#> # A tibble: 30 × 7
#>      id name              gender culture    born              died
#>   <int> <chr>             <chr>  <chr>      <chr>             <chr>
#> 1  1022 Theon Greyjoy     Male   "Ironborn" "In 278 AC or 27… ""
#> 2  1052 Tyrion Lannister  Male   ""         "In 273 AC, at C… ""
#> 3  1074 Victarion Greyjoy Male   "Ironborn" "In 268 AC or be… ""
#> 4  1109 Will              Male   ""         ""                "In 297 AC, at…
#> 5  1166 Areo Hotah        Male   "Norvoshi" "In 257 AC or be… ""
#> 6  1267 Chett             Male   ""         "At Hag's Mire"   "In 299 AC, at…
#> # ℹ 24 more rows
#> # ℹ 1 more variable: alive <lgl>
Bu veri kümesi çok sayıda liste sütunu da içerir:
chars |>
  unnest_wider(json) |>
  select(id, where(is.list))
#> # A tibble: 30 × 8
#>      id titles    aliases    allegiances books     povBooks tvSeries playedBy
#>   <int> <list>    <list>     <list>      <list>    <list>   <list>   <list>
#> 1  1022 <chr [2]> <chr [4]>  <chr [1]>   <chr [3]> <chr>    <chr>    <chr>
#> 2  1052 <chr [2]> <chr [11]> <chr [1]>   <chr [2]> <chr>    <chr>    <chr>
#> 3  1074 <chr [2]> <chr [1]>  <chr [1]>   <chr [3]> <chr>    <chr>    <chr>
#> 4  1109 <chr [1]> <chr [1]>  <NULL>      <chr [1]> <chr>    <chr>    <chr>
#> 5  1166 <chr [1]> <chr [1]>  <chr [1]>   <chr [3]> <chr>    <chr>    <chr>
#> 6  1267 <chr [1]> <chr [1]>  <NULL>      <chr [2]> <chr>    <chr>    <chr>
#> # ℹ 24 more rows
titles sütununu inceleyelim. Bu, adlandırılmamış bir liste sütunu olduğundan onu satırlara açacağız:
chars |>
  unnest_wider(json) |>
  select(id, titles) |>
  unnest_longer(titles)
#> # A tibble: 59 × 2
#>      id titles
#>   <int> <chr>
#> 1  1022 Prince of Winterfell
#> 2  1022 Lord of the Iron Islands (by law of the green lands)
#> 3  1052 Acting Hand of the King (former)
#> 4  1052 Master of Coin (former)
#> 5  1074 Lord Captain of the Iron Fleet
#> 6  1074 Master of the Iron Victory
#> # ℹ 53 more rows
Gerektiğinde karakter verileriyle kolayca birleştirilebileceği için bu verileri kendi tablosunda görmeyi bekleyebilirsiniz. Bunu yapalım. Küçük bir temizlik gerekir: Boş karakter dizileri içeren satırları kaldırmak ve artık her satırda yalnızca tek bir unvan bulunduğu için titles sütununu title olarak yeniden adlandırmak.
titles <- chars |>
  unnest_wider(json) |>
  select(id, titles) |>
  unnest_longer(titles) |>
  filter(titles != "") |>
  rename(title = titles)
titles
#> # A tibble: 52 × 2
#>      id title
#>   <int> <chr>
#> 1  1022 Prince of Winterfell
#> 2  1022 Lord of the Iron Islands (by law of the green lands)
#> 3  1052 Acting Hand of the King (former)
#> 4  1052 Master of Coin (former)
#> 5  1074 Lord Captain of the Iron Fleet
#> 6  1074 Master of the Iron Victory
#> # ℹ 46 more rows
Her liste sütunu için buna benzer bir tablo oluşturduğunuzu, ardından gerektiğinde bunları karakter verileriyle birleştirdiğinizi düşünebilirsiniz.
23.4.3 Derin iç içe yapılar
Bu örnek olayları, çok derin iç içe geçmiş ve çözülmesi için unnest_wider() ile unnest_longer() fonksiyonlarının art arda kullanılmasını gerektiren gmaps_cities liste sütunuyla bitireceğiz. Bu, beş şehir adını ve konumlarını belirlemek için Google’ın coğrafi kodlama API’sinin kullanılmasından elde edilen sonuçları içeren iki sütunlu bir tibble’dır:
gmaps_cities
#> # A tibble: 5 × 2
#>   city       json
#>   <chr>      <list>
#> 1 Houston    <named list [2]>
#> 2 Washington <named list [2]>
#> 3 New York   <named list [2]>
#> 4 Chicago    <named list [2]>
#> 5 Arlington <named list [2]>json, iç adlara sahip bir liste sütunudur; bu nedenle unnest_wider() ile başlarız:
gmaps_cities |>
  unnest_wider(json)
#> # A tibble: 5 × 3
#>   city       results    status
#>   <chr>      <list>     <chr>
#> 1 Houston    <list [1]> OK
#> 2 Washington <list [2]> OK
#> 3 New York   <list [1]> OK
#> 4 Chicago    <list [1]> OK
#> 5 Arlington  <list [2]> OK
Bu bize status ve results sütunlarını verir. Tüm değerler OK olduğu için durum sütununu kaldıracağız; gerçek bir çözümlemede status != "OK" olan tüm satırları da yakalamak ve neyin yanlış gittiğini belirlemek istersiniz. results bir ya da iki öğeli adlandırılmamış bir listedir (nedenini birazdan göreceğiz); bu nedenle onu satırlara açacağız:
gmaps_cities |>
  unnest_wider(json) |>
  select(-status) |>
  unnest_longer(results)
#> # A tibble: 7 × 2
#>   city       results
#>   <chr>      <list>
#> 1 Houston    <named list [5]>
#> 2 Washington <named list [5]>
#> 3 Washington <named list [5]>
#> 4 New York   <named list [5]>
#> 5 Chicago    <named list [5]>
#> 6 Arlington  <named list [5]>
#> # ℹ 1 more row
Artık results adlandırılmış bir liste olduğundan unnest_wider() kullanacağız:
locations <- gmaps_cities |>
  unnest_wider(json) |>
  select(-status) |>
  unnest_longer(results) |>
  unnest_wider(results)
locations
#> # A tibble: 7 × 6
#>   city       address_components formatted_address   geometry
#>   <chr>      <list>             <chr>               <list>
#> 1 Houston    <list [4]>         Houston, TX, USA    <named list [4]>
#> 2 Washington <list [2]>         Washington, USA     <named list [4]>
#> 3 Washington <list [4]>         Washington, DC, USA <named list [4]>
#> 4 New York   <list [3]>         New York, NY, USA   <named list [4]>
#> 5 Chicago    <list [4]>         Chicago, IL, USA    <named list [4]>
#> 6 Arlington  <list [4]>         Arlington, TX, USA  <named list [4]>
#> # ℹ 1 more row
#> # ℹ 2 more variables: place_id <chr>, types <list>
Artık iki şehrin neden ikişer sonuç verdiğini görebiliriz: Washington hem Washington eyaletiyle hem Washington, DC ile; Arlington ise Arlington, Virginia ve Arlington, Teksas ile eşleşmiştir.
Buradan ilerleyebileceğimiz birkaç farklı yön vardır. geometry liste sütununda saklanan eşleşmenin tam konumunu belirlemek isteyebiliriz:
locations |>
  select(city, formatted_address, geometry) |>
  unnest_wider(geometry)
#> # A tibble: 7 × 6
#>   city       formatted_address   bounds           location     location_type
#>   <chr>      <chr>               <list>           <list>       <chr>
#> 1 Houston    Houston, TX, USA    <named list [2]> <named list> APPROXIMATE
#> 2 Washington Washington, USA     <named list [2]> <named list> APPROXIMATE
#> 3 Washington Washington, DC, USA <named list [2]> <named list> APPROXIMATE
#> 4 New York   New York, NY, USA   <named list [2]> <named list> APPROXIMATE
#> 5 Chicago    Chicago, IL, USA    <named list [2]> <named list> APPROXIMATE
#> 6 Arlington  Arlington, TX, USA  <named list [2]> <named list> APPROXIMATE
#> # ℹ 1 more row
#> # ℹ 1 more variable: viewport <list>
Bu bize yeni bounds (dikdörtgensel bir bölge) ve location (bir nokta) sütunlarını verir. Enlemi (lat) ve boylamı (lng) görmek için location sütununu açabiliriz:
locations |>
  select(city, formatted_address, geometry) |>
  unnest_wider(geometry) |>
  unnest_wider(location)
#> # A tibble: 7 × 7
#>   city       formatted_address   bounds             lat    lng location_type
#>   <chr>      <chr>               <list>           <dbl>  <dbl> <chr>
#> 1 Houston    Houston, TX, USA    <named list [2]>  29.8  -95.4 APPROXIMATE
#> 2 Washington Washington, USA     <named list [2]>  47.8 -121.  APPROXIMATE
#> 3 Washington Washington, DC, USA <named list [2]>  38.9  -77.0 APPROXIMATE
#> 4 New York   New York, NY, USA   <named list [2]>  40.7  -74.0 APPROXIMATE
#> 5 Chicago    Chicago, IL, USA    <named list [2]>  41.9  -87.6 APPROXIMATE
#> 6 Arlington  Arlington, TX, USA  <named list [2]>  32.7  -97.1 APPROXIMATE
#> # ℹ 1 more row
#> # ℹ 1 more variable: viewport <list>
Sınırları çıkarmak birkaç adım daha gerektirir:
locations |>
  select(city, formatted_address, geometry) |>
  unnest_wider(geometry) |>
  # İlgilenilen değişkenlere odaklan
  select(!location:viewport) |>
  unnest_wider(bounds)
#> # A tibble: 7 × 4
#>   city       formatted_address   northeast        southwest
#>   <chr>      <chr>               <list>           <list>
#> 1 Houston    Houston, TX, USA    <named list [2]> <named list [2]>
#> 2 Washington Washington, USA     <named list [2]> <named list [2]>
#> 3 Washington Washington, DC, USA <named list [2]> <named list [2]>
#> 4 New York   New York, NY, USA   <named list [2]> <named list [2]>
#> 5 Chicago    Chicago, IL, USA    <named list [2]> <named list [2]>
#> 6 Arlington  Arlington, TX, USA  <named list [2]> <named list [2]>
#> # ℹ 1 more row
Ardından kısa ama açıklayıcı adlar oluşturmak üzere names_sep kullanabilmek için southwest ve northeast (dikdörtgenin köşeleri) sütunlarını yeniden adlandırırız:
locations |>
  select(city, formatted_address, geometry) |>
  unnest_wider(geometry) |>
  select(!location:viewport) |>
  unnest_wider(bounds) |>
  rename(ne = northeast, sw = southwest) |>
  unnest_wider(c(ne, sw), names_sep = "_")
#> # A tibble: 7 × 6
#>   city       formatted_address   ne_lat ne_lng sw_lat sw_lng
#>   <chr>      <chr>                <dbl>  <dbl>  <dbl>  <dbl>
#> 1 Houston    Houston, TX, USA      30.1  -95.0   29.5  -95.8
#> 2 Washington Washington, USA       49.0 -117.    45.5 -125.
#> 3 Washington Washington, DC, USA   39.0  -76.9   38.8  -77.1
#> 4 New York   New York, NY, USA     40.9  -73.7   40.5  -74.3
#> 5 Chicago    Chicago, IL, USA      42.0  -87.5   41.6  -87.9
#> 6 Arlington  Arlington, TX, USA    32.8  -97.0   32.6  -97.2
#> # ℹ 1 more row
unnest_wider() fonksiyonuna bir değişken adları vektörü vererek iki sütunu aynı anda açtığımıza dikkat edin.
İlgilendiğiniz bileşenlere ulaşan yolu keşfettikten sonra başka bir tidyr fonksiyonu olan hoist() ile bunları doğrudan çıkarabilirsiniz:
Bu örnek olaylar gerçek yaşamdan daha fazla dikdörtgensel hâle getirme örneği görme isteğinizi artırdıysa vignette("rectangling", package = "tidyr") içinde birkaç örnek daha bulabilirsiniz.
23.4.4 Alıştırmalar
gh_reposnesnesinin ne zaman oluşturulduğunu kabaca tahmin edin. Tarihi neden yalnızca kabaca tahmin edebilirsiniz?Her sahip birden çok depoya sahip olabildiğinden
gh_reposnesnesininownersütunu çok sayıda yinelenen bilgi içerir. Her sahip için bir satır içeren birownersveri çerçevesi oluşturabilir misiniz? (İpucu:distinct()liste sütunlarıyla çalışır mı?)Game of Thrones karakterlerinin takma adları, bağlılıkları, kitapları ve televizyon dizileri için benzer tablolar oluşturmak üzere
titlesiçin kullanılan adımları izleyin.-
Aşağıdaki kodu satır satır açıklayın. Neden ilginçtir? Neden
got_charsiçin çalışır da genel durumda çalışmayabilir?tibble(json = got_chars) |> unnest_wider(json) |> select(id, where(is.list)) |> pivot_longer( where(is.list), names_to = "name", values_to = "value" ) |> unnest_longer(value) gmaps_citiesiçindeaddress_componentsne içerir? Uzunluğu neden satırlar arasında değişir? Bunu anlamak için uygun biçimde iç içe yapıdan çıkarın. (İpucu:typesher zaman iki öğe içeriyor gibi görünür.unnest_wider()onunla çalışmayıunnest_longer()fonksiyonundan daha kolay hâle getirir mi?) .
23.5 JSON
Önceki kısımdaki örnek olayların tümü gerçek ortamdan alınmış JSON verilerinden geliyordu. JSON, JavaScript Object Notation ifadesinin kısaltmasıdır ve çoğu web API’sinin veri döndürme biçimidir. JSON ile R’ın veri türleri oldukça benzer olsa da aralarında kusursuz bire bir eşleme bulunmadığından JSON’u anlamak önemlidir; bir şeyler ters gittiğinde JSON hakkında biraz bilgi sahibi olmak yararlıdır.
23.5.1 Veri türleri
JSON, insanlar tarafından değil makinelerce kolayca okunup yazılmak üzere tasarlanmış basit bir biçimdir. Altı temel veri türüne sahiptir. Bunların dördü skalerdir:
- En basit tür, R’daki
NAile aynı rolü oynayan null (null) değeridir. Verinin yokluğunu temsil eder. - Karakter dizisi, R’daki karakter dizisine çok benzer; ancak her zaman çift tırnak kullanmalıdır.
-
Sayı, R’daki sayılara benzer: Tam sayı (ör. 123), ondalık (ör. 123.45) veya bilimsel (ör. 1.23e3) gösterim kullanabilir. JSON
Inf,-InfveyaNaNdeğerlerini desteklemez. -
Boole değeri, R’daki
TRUEveFALSEdeğerlerine benzer; ancak küçük harflitruevefalsekullanır.
JSON’daki karakter dizileri, sayılar ve Boole değerleri R’daki karakter, sayısal ve mantıksal vektörlere oldukça benzerdir. Temel fark, JSON skalerlerinin yalnızca tek bir değeri temsil edebilmesidir. Birden çok değeri temsil etmek için kalan iki türden birini kullanmanız gerekir: diziler ve nesneler.
Hem diziler hem nesneler R’daki listelere benzer; aralarındaki fark adlandırılmış olup olmamalarıdır. Bir dizi, adlandırılmamış liste gibidir ve [] ile yazılır. Örneğin [1, 2, 3] üç sayı içeren bir dizidir; [null, 1, "string", false] ise bir null, bir sayı, bir karakter dizisi ve bir Boole değeri içeren dizidir. Bir nesne, adlandırılmış liste gibidir ve {} ile yazılır. Adlar (JSON terminolojisinde anahtarlar) karakter dizileridir; dolayısıyla tırnak içine alınmalıdır. Örneğin {"x": 1, "y": 2}, x değerini 1’e ve y değerini 2’ye eşleyen bir nesnedir.
JSON’un tarihleri veya tarih-saatleri temsil etmek için yerleşik bir yolu olmadığını unutmayın. Bu nedenle bunlar çoğunlukla karakter dizisi olarak saklanır ve doğru veri yapısına dönüştürmek için readr::parse_date() ya da readr::parse_datetime() kullanmanız gerekir. Benzer biçimde JSON’un kayan noktalı sayıları temsil etme kuralları biraz belirsizdir; bu nedenle bazen karakter dizilerinde saklanan sayılarla da karşılaşırsınız. Doğru değişken türünü elde etmek için gerektiğinde readr::parse_double() uygulayın.
23.5.2 jsonlite
JSON’u R veri yapılarına dönüştürmek için Jeroen Ooms’un jsonlite paketini öneriyoruz. Yalnızca iki jsonlite fonksiyonunu kullanacağız: read_json() ve parse_json(). Gerçek yaşamda diskten bir JSON dosyası okumak için read_json() kullanırsınız. Örneğin repurrrsive paketi gh_user nesnesinin kaynağını bir JSON dosyası olarak da sağlar ve bunu read_json() ile okuyabilirsiniz:
# Paketin içindeki bir JSON dosyasının yolu:
gh_users_json()
#> [1] "/home/runner/work/_temp/Library/repurrrsive/extdata/gh_users.json"

# read_json() ile oku
gh_users2 <- read_json(gh_users_json())

# Daha önce kullandığımız verilerle aynı olduğunu denetle
identical(gh_users, gh_users2)
#> [1] TRUE
Bu kitapta JSON içeren bir karakter dizisini kabul ettiği ve bu nedenle basit örnekler üretmeye uygun olduğu için parse_json() fonksiyonunu da kullanacağız. Başlangıç olarak üç basit JSON veri kümesi görelim: Önce bir sayı, sonra bir dizi içine yerleştirilmiş birkaç sayı ve son olarak bir nesne içine yerleştirilmiş bu dizi:
str(parse_json('1'))
#>  int 1
str(parse_json('[1, 2, 3]'))
#> List of 3
#>  $ : int 1
#>  $ : int 2
#>  $ : int 3
str(parse_json('{"x": [1, 2, 3]}'))
#> List of 1
#>  $ x:List of 3
#>   ..$ : int 1
#>   ..$ : int 2
#>   ..$ : int 3
jsonlite’ın fromJSON() adlı önemli bir fonksiyonu daha vardır. Otomatik sadeleştirme (simplifyVector = TRUE) yaptığı için burada onu kullanmıyoruz. Bu yaklaşım özellikle basit durumlarda çoğunlukla iyi çalışır; ancak tam olarak ne olduğunu bilmeniz ve en karmaşık iç içe yapıları daha kolay ele alabilmeniz için dikdörtgensel hâle getirme işlemini kendiniz yapmanızın daha iyi olduğunu düşünüyoruz.
23.5.3 Dikdörtgensel hâle getirme sürecini başlatma
JSON dosyaları çoğu durumda tek bir üst düzey dizi içerir; çünkü birden çok “şey” (örneğin birden çok sayfa, kayıt ya da sonuç) hakkında veri sağlamak üzere tasarlanmışlardır. Bu durumda her öğenin bir satır olması için dikdörtgensel hâle getirmeye tibble(json) ile başlarsınız:
json <- '[
  {"name": "John", "age": 34},
  {"name": "Susan", "age": 27}
]'
df <- tibble(json = parse_json(json))
df
#> # A tibble: 2 × 1
#>   json
#>   <list>
#> 1 <named list [2]>
#> 2 <named list [2]>

df |>
  unnest_wider(json)
#> # A tibble: 2 × 2
#>   name    age
#>   <chr> <int>
#> 1 John     34
#> 2 Susan    27
Daha seyrek durumlarda JSON dosyası tek bir “şeyi” temsil eden, üst düzey tek bir JSON nesnesinden oluşur. Bu durumda dikdörtgensel hâle getirme sürecini başlatmak için nesneyi tibble’a koymadan önce bir liste içine almanız gerekir.
json <- '{
  "status": "OK",
  "results": [
    {"name": "John", "age": 34},
    {"name": "Susan", "age": 27}
 ]
}
'
df <- tibble(json = list(parse_json(json)))
df
#> # A tibble: 1 × 1
#>   json
#>   <list>
#> 1 <named list [2]>

df |>
  unnest_wider(json) |>
  unnest_longer(results) |>
  unnest_wider(results)
#> # A tibble: 2 × 3
#>   status name    age
#>   <chr>  <chr> <int>
#> 1 OK     John     34
#> 2 OK     Susan    27
Alternatif olarak ayrıştırılmış JSON’un içine erişip doğrudan ilgilendiğiniz bölümle başlayabilirsiniz:
df <- tibble(results = parse_json(json)$results)
df |>
  unnest_wider(results)
#> # A tibble: 2 × 2
#>   name    age
#>   <chr> <int>
#> 1 John     34
#> 2 Susan    27
23.5.4 Alıştırmalar
-
Aşağıdaki
df_colvedf_rownesnelerini dikdörtgensel hâle getirin. Bunlar bir veri çerçevesini JSON’da kodlamanın iki yolunu temsil eder.json_col <- parse_json(' { "x": ["a", "x", "z"], "y": [10, null, 3] } ') json_row <- parse_json(' [ {"x": "a", "y": 10}, {"x": "x", "y": null}, {"x": "z", "y": 3} ] ') df_col <- tibble(json = list(json_col)) df_row <- tibble(json = json_row)
23.6 Özet
Bu bölümde listelerin ne olduğunu, JSON dosyalarından nasıl üretilebileceğini ve dikdörtgensel veri çerçevelerine nasıl dönüştürüleceğini öğrendiniz. Şaşırtıcı biçimde yalnızca iki yeni fonksiyona ihtiyacımız vardır: Liste öğelerini satırlara koymak için unnest_longer(), sütunlara koymak için unnest_wider(). Liste sütununun ne kadar derin iç içe geçtiği önemli değildir; yapmanız gereken tek şey bu iki fonksiyonu art arda çağırmaktır.
JSON, web API’lerinin döndürdüğü en yaygın veri biçimidir. Peki web sitesinin bir API’si yoksa ancak istediğiniz verileri sitede görebiliyorsanız ne olur? Bu, bir sonraki bölümün konusudur: web kazıma, yani HTML web sayfalarından veri çıkarma.
Bu bir RStudio özelliğidir.↩︎