library(nycflights13)
library(tidyverse)
#> ── Attaching core tidyverse packages ───────────────────── tidyverse 2.0.0 ──
#> ✔ dplyr     1.2.1     ✔ readr     2.2.0
#> ✔ forcats   1.0.1     ✔ stringr   1.6.0
#> ✔ ggplot2   4.0.3     ✔ tibble    3.3.1
#> ✔ lubridate 1.9.5     ✔ tidyr     1.3.2
#> ✔ purrr     1.2.2
#> ── Conflicts ─────────────────────────────────────── tidyverse_conflicts() ──
#> ✖ dplyr::filter() masks stats::filter()
#> ✖ dplyr::lag()    masks stats::lag()
#> ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errors3 Veri dönüştürme
3.1 Giriş
Görselleştirme, içgörü üretmenin önemli bir aracıdır; ancak veriler, çizmek istediğiniz grafik için tam da gereken biçimde nadiren gelir. Sorularınızı verilerle yanıtlamak için çoğu zaman yeni değişkenler veya özetler oluşturmanız gerekir. Bazen de yalnızca değişkenleri yeniden adlandırmak ya da verilerle çalışmayı kolaylaştırmak için gözlemleri yeniden sıralamak istersiniz. Bu bölümde bunların tümünü (hatta daha fazlasını!) nasıl yapacağınızı öğreneceksiniz. dplyr paketini ve 2013’te New York City’den kalkan uçuşlara ilişkin yeni bir veri kümesini kullanarak veri dönüştürmeyle tanışacaksınız.
Bu bölümün amacı, bir veri çerçevesini dönüştürmekte kullanılan temel araçların genel bir görünümünü sunmaktır. Önce veri çerçevesinin satırları, ardından sütunları üzerinde çalışan fonksiyonlarla başlayacağız. Sonra dplyr fiillerini birleştiren önemli bir araç olan pipe operatörünü daha ayrıntılı ele alacağız. Ardından gruplarla çalışmayı öğreneceğiz. Bölümü, bu fonksiyonların uygulamadaki kullanımını gösteren bir örnek olayla tamamlayacağız. Sonraki bölümlerde sayılar, karakter dizileri ve tarihler gibi belirli veri türlerini incelerken bu fonksiyonlara daha ayrıntılı biçimde döneceğiz.
3.1.1 Ön koşullar
Bu bölümde, tidyverse’in bir diğer çekirdek üyesi olan dplyr paketine odaklanacağız. Temel fikirleri nycflights13 paketindeki veriyi kullanarak açıklayacak ve veriyi anlamamıza yardımcı olması için ggplot2 kullanacağız.
Tidyverse’i yüklediğinizde ekrana gelen çakışma mesajına dikkatle bakın. Bu mesaj, dplyr’in temel R’daki (base R) bazı fonksiyonları geçersiz kıldığını bildirir. dplyr’i yükledikten sonra bu fonksiyonların temel R sürümlerini kullanmak isterseniz tam adlarını yazmanız gerekir: stats::filter() ve stats::lag(). Şimdiye kadar bir fonksiyonun hangi paketten geldiğini büyük ölçüde göz ardı ettik; çünkü bu çoğu zaman önemli değildir. Yine de paketi bilmek, yardım belgelerini ve ilgili fonksiyonları bulmanızı kolaylaştırabilir. Bu nedenle fonksiyonun geldiği paketi açıkça belirtmemiz gerektiğinde R ile aynı söz dizimini kullanacağız: packagename::functionname().
3.1.2 nycflights13
Temel dplyr fiillerini keşfetmek için nycflights13::flights’ı kullanacağız. Bu veri kümesi, 2013 yılında New York City’den kalkan 336,776 uçuşun tamamını içerir. Veri, ABD Ulaştırma İstatistikleri Bürosu’ndan gelmektedir ve ?flights içinde belgelenmiştir.
flights
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …flights, tidyverse’in bazı yaygın sorunlardan kaçınmak için kullandığı özel bir veri çerçevesi türü olan tibble’dır. Tibble’lar ile veri çerçeveleri arasındaki en önemli fark, tibble’ların yazdırılma şeklidir; büyük veri kümeleri için tasarlandıklarından, yalnızca ilk birkaç satırı ve yalnızca bir ekrana sığan sütunları gösterirler. Her şeyi görmek için birkaç seçenek vardır. RStudio kullanıyorsanız, en uygunu muhtemelen etkileşimli, kaydırılabilir ve filtrelenebilir bir görünüm açan View(flights)’tır. Aksi takdirde, tüm sütunları göstermek için print(flights, width = Inf) kullanabilir veya glimpse()’i kullanabilirsiniz:
glimpse(flights)
#> Rows: 336,776
#> Columns: 19
#> $ year           <int> 2013, 2013, 2013, 2013, 2013, 2013, 2013, 2013, 2013…
#> $ month          <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1…
#> $ day            <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1…
#> $ dep_time       <int> 517, 533, 542, 544, 554, 554, 555, 557, 557, 558, 55…
#> $ sched_dep_time <int> 515, 529, 540, 545, 600, 558, 600, 600, 600, 600, 60…
#> $ dep_delay      <dbl> 2, 4, 2, -1, -6, -4, -5, -3, -3, -2, -2, -2, -2, -2,…
#> $ arr_time       <int> 830, 850, 923, 1004, 812, 740, 913, 709, 838, 753, 8…
#> $ sched_arr_time <int> 819, 830, 850, 1022, 837, 728, 854, 723, 846, 745, 8…
#> $ arr_delay      <dbl> 11, 20, 33, -18, -25, 12, 19, -14, -8, 8, -2, -3, 7,…
#> $ carrier        <chr> "UA", "UA", "AA", "B6", "DL", "UA", "B6", "EV", "B6"…
#> $ flight         <int> 1545, 1714, 1141, 725, 461, 1696, 507, 5708, 79, 301…
#> $ tailnum        <chr> "N14228", "N24211", "N619AA", "N804JB", "N668DN", "N…
#> $ origin         <chr> "EWR", "LGA", "JFK", "JFK", "LGA", "EWR", "EWR", "LG…
#> $ dest           <chr> "IAH", "IAH", "MIA", "BQN", "ATL", "ORD", "FLL", "IA…
#> $ air_time       <dbl> 227, 227, 160, 183, 116, 150, 158, 53, 140, 138, 149…
#> $ distance       <dbl> 1400, 1416, 1089, 1576, 762, 719, 1065, 229, 944, 73…
#> $ hour           <dbl> 5, 5, 5, 5, 6, 5, 6, 6, 6, 6, 6, 6, 6, 6, 6, 5, 6, 6…
#> $ minute         <dbl> 15, 29, 40, 45, 0, 58, 0, 0, 0, 0, 0, 0, 0, 0, 0, 59…
#> $ time_hour      <dttm> 2013-01-01 05:00:00, 2013-01-01 05:00:00, 2013-01-0…
Her iki görünümde de değişken adlarının ardından değişken türünü belirten kısaltmalar gelir: <int> tam sayıyı (integer), <dbl> çift duyarlıklı sayıyı (double; diğer adıyla gerçek sayı), <chr> karakteri (character; diğer adıyla karakter dizisi), <dttm> ise tarih-saati (date-time) belirtir. Bunlar önemlidir; çünkü bir sütun üzerinde gerçekleştirebileceğiniz işlemler büyük ölçüde onun “türüne” bağlıdır.
3.1.3 dplyr’ın temelleri
Veri işleme sorunlarının büyük çoğunluğunu çözmenizi sağlayacak temel dplyr fiillerini (fonksiyonlarını) öğrenmek üzeresiniz. Ancak aralarındaki farkları ele almadan önce ortak yönlerini belirtmekte yarar var:
İlk argüman her zaman bir veri çerçevesidir.
Sonraki argümanlar genellikle hangi sütunlar üzerinde işlem yapılacağını değişken adlarını (tırnaksız) kullanarak tanımlar.
Çıktı her zaman yeni bir veri çerçevesidir.
Her fiil tek bir işi iyi yaptığından karmaşık sorunları çözmek çoğunlukla birden fazla fiili birleştirmeyi gerektirir. Bunu pipe operatörü |> ile yapacağız. Bölüm 3.4 bölümünde pipe operatörünü daha ayrıntılı ele alacağız. Kısaca söylemek gerekirse pipe, solundaki nesneyi alıp sağındaki fonksiyona aktarır. Böylece x |> f(y), f(x, y) ifadesine; x |> f(y) |> g(z) ise g(f(x, y), z) ifadesine eşdeğer olur. Pipe operatörünü okumanın en kolay yolu “sonra” demektir. Bu, ayrıntılarını henüz öğrenmemiş olsanız bile aşağıdaki kodun ne yaptığına dair bir fikir edinmenizi mümkün kılar:
dplyr’in fiilleri, ne üzerinde işlem yaptıklarına göre dört gruba ayrılır: satırlar, sütunlar, gruplar veya tablolar. Aşağıdaki bölümlerde, satırlar, sütunlar ve gruplar için en önemli fiilleri öğreneceksiniz. Ardından, Bölüm 19 bölümünde tablolar üzerinde çalışan birleştirme (join) fiillerine geri döneceğiz. Hadi başlayalım!
3.2 Satırlar
Bir veri kümesinin satırları üzerinde çalışan en önemli fiiller filter() ve arrange()’dir. filter(), satırların sırasını değiştirmeden veri kümesinde hangi satırların bulunacağını; arrange() ise hangi satırların bulunduğunu değiştirmeden bunların sırasını değiştirir. Her iki fonksiyon da yalnızca satırları etkiler; sütunlar değişmeden kalır. Benzersiz değerlere sahip satırları bulan distinct()’i de tartışacağız. arrange() ve filter()’ın aksine, isteğe bağlı olarak sütunları da değiştirebilir.
3.2.1 filter()
filter(), sütunların değerlerine dayanarak satırları tutmanızı sağlar1. İlk argüman veri çerçevesidir. İkinci ve sonraki argümanlar, satırın tutulması için doğru olması gereken koşullardır. Örneğin, 120 dakikadan (iki saatten) daha fazla geciken tüm uçuşları bulabiliriz:
flights |>
  filter(dep_delay > 120)
#> # A tibble: 9,723 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      848           1835       853     1001           1950
#> 2  2013     1     1      957            733       144     1056            853
#> 3  2013     1     1     1114            900       134     1447           1222
#> 4  2013     1     1     1540           1338       122     2020           1825
#> 5  2013     1     1     1815           1325       290     2120           1542
#> 6  2013     1     1     1842           1422       260     1958           1535
#> # ℹ 9,717 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
> (büyüktür) yanı sıra >= (büyüktür veya eşittir), < (küçüktür), <= (küçüktür veya eşittir), == (eşittir) ve != (eşit değildir) kullanabilirsiniz. Ayrıca, “ve” (her iki koşulu da kontrol et) anlamına gelmesi için & veya , ile, “veya” (iki koşuldan herhangi birini kontrol et) anlamına gelmesi için ise | ile koşulları birleştirebilirsiniz:
# 1 Ocak'ta kalkan uçuşlar
flights |>
  filter(month == 1 & day == 1)
#> # A tibble: 842 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 836 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …

# Ocak veya Şubat'ta kalkan uçuşlar
flights |>
  filter(month == 1 | month == 2)
#> # A tibble: 51,955 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 51,949 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
| ve ==’i birleştirdiğinizde kullanışlı bir kısayol vardır: %in%. Bu, değişkenin sağdaki değerlerden birine eşit olduğu satırları tutar:
# Ocak veya Şubat'ta kalkan uçuşları seçmenin daha kısa bir yolu
flights |>
  filter(month %in% c(1, 2))
#> # A tibble: 51,955 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 51,949 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Bu karşılaştırmalara ve mantıksal operatörlere Bölüm 12 bölümünde daha ayrıntılı olarak geri döneceğiz.
filter()’ı çalıştırdığınızda dplyr filtreleme işlemini gerçekleştirir, yeni bir veri çerçevesi oluşturur ve ardından onu yazdırır. Mevcut flights veri kümesini değiştirmez; çünkü dplyr fonksiyonları girdilerini asla değiştirmez. Sonucu kaydetmek için atama operatörünü, <-’yi kullanmanız gerekir:
jan1 <- flights |>
  filter(month == 1 & day == 1)
3.2.2 Yaygın hatalar
R’a yeni başladığınızda yapılması en kolay hata, eşitlik testi yaparken == yerine = kullanmaktır. Bu olduğunda filter() size haber verecektir:
flights |>
  filter(month = 1)
#> Error in `filter()`:
#> ! We detected a named input.
#> ℹ This usually means that you've used `=` instead of `==`.
#> ℹ Did you mean `month == 1`?
Bir başka hata da, “veya” ifadelerini İngilizcede yazacağınız gibi yazmaktır:
flights |>
  filter(month == 1 | 2)
Bu ifade hata vermediği için bir anlamda “çalışır”; ancak istediğiniz sonucu üretmez. Çünkü | önce month == 1 koşulunu, ardından anlamlı bir koşul olmayan 2 değerini denetler. Burada neler olduğu ve nedenini Bölüm 12.3.2 bölümünde daha ayrıntılı öğreneceğiz.
3.2.3 arrange()
arrange(), satırların sırasını sütunların değerine göre değiştirir. Bir veri çerçevesi ve sıralanacak bir sütun adları kümesi (veya daha karmaşık ifadeler) alır. Birden fazla sütun adı verirseniz, her ek sütun, önceki sütunların değerlerindeki eşitlikleri kırmak için kullanılır. Örneğin, aşağıdaki kod, dört sütuna yayılmış olan kalkış zamanına göre sıralar. Önce en erken yılları, sonra bir yıl içinde en erken ayları vb. elde ederiz.
flights |>
  arrange(year, month, day, dep_time)
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Bir veri çerçevesini bir sütuna göre azalan (büyükten küçüğe) sırada yeniden sıralamak için arrange() içinde o sütun üzerinde desc() kullanabilirsiniz. Örneğin, bu kod uçuşları en çok gecikenden en az gecikene doğru sıralar:
flights |>
  arrange(desc(dep_delay))
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     9      641            900      1301     1242           1530
#> 2  2013     6    15     1432           1935      1137     1607           2120
#> 3  2013     1    10     1121           1635      1126     1239           1810
#> 4  2013     9    20     1139           1845      1014     1457           2210
#> 5  2013     7    22      845           1600      1005     1044           1815
#> 6  2013     4    10     1100           1900       960     1342           2211
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Satır sayısının değişmediğine dikkat edin – yalnızca veriyi sıralıyoruz, filtrelemiyoruz.
3.2.4 distinct()
distinct(), bir veri kümesindeki tüm benzersiz satırları bulur, dolayısıyla teknik olarak öncelikle satırlar üzerinde işlem yapar. Ancak çoğu zaman bazı değişkenlerin benzersiz kombinasyonunu isteyeceksiniz, bu yüzden isteğe bağlı olarak sütun adları da sağlayabilirsiniz:
# Varsa yinelenen satırları kaldır
flights |>
  distinct()
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …

# Tüm benzersiz kalkış-varış çiftlerini bul
flights |>
  distinct(origin, dest)
#> # A tibble: 224 × 2
#>   origin dest
#>   <chr>  <chr>
#> 1 EWR    IAH
#> 2 LGA    IAH
#> 3 JFK    MIA
#> 4 JFK    BQN
#> 5 LGA    ATL
#> 6 EWR    ORD
#> # ℹ 218 more rows
Alternatif olarak, benzersiz satırları filtrelerken diğer sütunları da tutmak isterseniz, .keep_all = TRUE seçeneğini kullanabilirsiniz.
flights |>
  distinct(origin, dest, .keep_all = TRUE)
#> # A tibble: 224 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 218 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Bu benzersiz uçuşların tümünün 1 Ocak’ta olması tesadüf değildir: distinct(), veri kümesindeki her benzersiz satırın ilk görüldüğü örneği tutup geri kalanları atar.
Bunun yerine her değerin kaç kez görüldüğünü bulmak isterseniz distinct() yerine count() kullanmanız daha uygun olur. sort = TRUE argümanıyla sonuçları görülme sayısına göre azalan sırada düzenleyebilirsiniz. count() hakkında daha fazlasını Bölüm 13.3 bölümünde öğreneceksiniz.
flights |>
  count(origin, dest, sort = TRUE)
#> # A tibble: 224 × 3
#>   origin dest      n
#>   <chr>  <chr> <int>
#> 1 JFK    LAX   11262
#> 2 LGA    ATL   10263
#> 3 LGA    ORD    8857
#> 4 JFK    SFO    8204
#> 5 LGA    CLT    6168
#> 6 EWR    ORD    6100
#> # ℹ 218 more rows
3.2.5 Alıştırmalar
-
Her koşul için tek bir işlem hattında, koşulu sağlayan tüm uçuşları bulun:
- İki saat veya daha fazla varış gecikmesi yaşayanlar
- Houston’a uçanlar (
IAHveyaHOU) - United, American veya Delta tarafından işletilenler
- Yazın (Temmuz, Ağustos ve Eylül) kalkanlar
- İki saatten fazla geç varan ama geç kalkmayanlar
- En az bir saat gecikip uçuşta 30 dakikadan fazla telafi edenler
En uzun kalkış gecikmelerine sahip uçuşları bulmak için
flights’ı sıralayın. Sabah en erken kalkan uçuşları bulun.En hızlı uçuşları bulmak için
flights’ı sıralayın. (İpucu: Fonksiyonunuzun içine bir matematik hesaplaması eklemeyi deneyin.)2013’ün her gününde bir uçuş var mıydı?
Hangi uçuşlar en uzun mesafeyi kat etti? Hangileri en kısa mesafeyi kat etti?
Hem
filter()hem dearrange()kullanıyorsanız, bunları kullanma sırası önemli mi? Neden önemli veya neden önemsiz? Sonuçları ve fonksiyonların ne kadar iş yapması gerekeceğini düşünün.
3.3 Sütunlar
Satırları değiştirmeden sütunları etkileyen dört önemli fiil vardır: mutate() mevcut sütunlardan türetilen yeni sütunlar oluşturur, select() hangi sütunların bulunduğunu değiştirir, rename() sütunların adlarını değiştirir ve relocate() sütunların konumlarını değiştirir.
3.3.1 mutate()
mutate()’in işi, mevcut sütunlardan hesaplanan yeni sütunlar eklemektir. Dönüştürme bölümlerinde, farklı türdeki değişkenleri manipüle etmek için kullanabileceğiniz geniş bir fonksiyon kümesini öğreneceksiniz. Şimdilik, geciken bir uçuşun havada ne kadar zaman telafi ettiğini gösteren gain’i ve mil/saat cinsinden speed’i hesaplamamızı sağlayan temel cebirle yetineceğiz:
flights |>
  mutate(
    gain = dep_delay - arr_delay,
    speed = distance / air_time * 60
  )
#> # A tibble: 336,776 × 21
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 13 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Varsayılan olarak, mutate() yeni sütunları veri kümenizin sağ tarafına ekler; bu da burada neler olduğunu görmeyi zorlaştırır. Bunun yerine değişkenleri sol tarafa eklemek için .before argümanını kullanabiliriz2:
flights |>
  mutate(
    gain = dep_delay - arr_delay,
    speed = distance / air_time * 60,
    .before = 1
  )
#> # A tibble: 336,776 × 21
#>    gain speed  year month   day dep_time sched_dep_time dep_delay arr_time
#>   <dbl> <dbl> <int> <int> <int>    <int>          <int>     <dbl>    <int>
#> 1    -9  370.  2013     1     1      517            515         2      830
#> 2   -16  374.  2013     1     1      533            529         4      850
#> 3   -31  408.  2013     1     1      542            540         2      923
#> 4    17  517.  2013     1     1      544            545        -1     1004
#> 5    19  394.  2013     1     1      554            600        -6      812
#> 6   -16  288.  2013     1     1      554            558        -4      740
#> # ℹ 336,770 more rows
#> # ℹ 12 more variables: sched_arr_time <int>, arr_delay <dbl>, …., .before’un oluşturduğumuz üçüncü yeni bir değişkenin adı değil, fonksiyona ait bir argüman olduğunu gösterir. Bir değişkenden sonra eklemek için .after’ı da kullanabilirsiniz; hem .before hem de .after’da bir konum yerine değişken adını kullanabilirsiniz. Örneğin, yeni değişkenleri day’den sonra ekleyebiliriz:
flights |>
  mutate(
    gain = dep_delay - arr_delay,
    speed = distance / air_time * 60,
    .after = day
  )
Alternatif olarak, hangi değişkenlerin tutulacağını .keep argümanıyla kontrol edebilirsiniz. Özellikle kullanışlı bir argüman, mutate() adımında yer alan veya oluşturulan sütunları tutmamızı belirten "used"’dır. Örneğin, aşağıdaki çıktı yalnızca dep_delay, arr_delay, air_time, gain, hours ve gain_per_hour değişkenlerini içerecektir.
flights |>
  mutate(
    gain = dep_delay - arr_delay,
    hours = air_time / 60,
    gain_per_hour = gain / hours,
    .keep = "used"
  )
Yukarıdaki hesaplamanın sonucunu flights’a geri atamadığımız için, yeni değişkenler olan gain, hours ve gain_per_hour’ın yalnızca yazdırılacağını, bir veri çerçevesinde saklanmayacağını unutmayın. Ve bunların ileride kullanım için bir veri çerçevesinde erişilebilir olmasını istiyorsak, sonucu flights’a geri atayıp orijinal veri çerçevesinin üzerine çok daha fazla değişkenle mi yazmak istediğimizi, yoksa yeni bir nesneye mi atamak istediğimizi dikkatlice düşünmeliyiz. Genellikle doğru cevap, içeriğini belirtecek şekilde bilgilendirici bir ad verilen yeni bir nesnedir, örneğin delay_gain; ama flights’ın üzerine yazmak için de iyi nedenleriniz olabilir.
3.3.2 select()
Yüzlerce, hatta binlerce değişkene sahip veri kümeleri elde etmek pek de nadir değildir. Bu durumda, ilk zorluk genellikle yalnızca ilgilendiğiniz değişkenlere odaklanmaktır. select(), değişkenlerin adlarına dayalı işlemler kullanarak yararlı bir alt kümeye hızlıca odaklanmanızı sağlar:
-
Sütunları ada göre seçin:
flights |> select(year, month, day) -
year ile day arasındaki (dahil) tüm sütunları seçin:
flights |> select(year:day) -
year’dan day’e kadar olanlar (dahil) hariç tüm sütunları seçin:
flights |>
  select(!year:day)
Tarihsel olarak bu işlem
!yerine-ile yapılırdı, bu yüzden bunu gerçek hayattaki kodlarda görme olasılığınız yüksektir. Bu iki operatör aynı amaca hizmet eder, ama davranışlarında ince farklılıklar vardır.!kullanmanızı öneririz; çünkü “değil” olarak okunur ve&ile|ile iyi birleşir. -
Karakter türünde olan tüm sütunları seçin:
select() içinde kullanabileceğiniz bir dizi yardımcı fonksiyon vardır:
-
starts_with("abc"): “abc” ile başlayan adlarla eşleşir. -
ends_with("xyz"): “xyz” ile biten adlarla eşleşir. -
contains("ijk"): “ijk” içeren adlarla eşleşir. -
num_range("x", 1:3):x1,x2vex3ile eşleşir.
Daha fazla ayrıntı için ?select’e bakın. Düzenli ifadeleri (Bölüm 15 bölümünün konusu) öğrendiğinizde, bir kalıpla eşleşen değişkenleri seçmek için matches()’i de kullanabileceksiniz.
Değişkenleri select() ederken = kullanarak yeniden adlandırabilirsiniz. Yeni ad =’in sol tarafında, eski değişken ise sağ tarafında görünür:
flights |>
  select(tail_num = tailnum)
#> # A tibble: 336,776 × 1
#>   tail_num
#>   <chr>
#> 1 N14228
#> 2 N24211
#> 3 N619AA
#> 4 N804JB
#> 5 N668DN
#> 6 N39463
#> # ℹ 336,770 more rows
3.3.3 rename()
Mevcut tüm değişkenleri tutmak ve yalnızca birkaçını yeniden adlandırmak istiyorsanız, select() yerine rename() kullanabilirsiniz:
flights |>
  rename(tail_num = tailnum)
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Tutarsız adlandırılmış bir sürü sütununuz varsa ve bunların hepsini elle düzeltmek can sıkıcı olacaksa, faydalı bazı otomatik temizleme işlemleri sunan janitor::clean_names()’e göz atın.
3.3.4 relocate()
Değişkenleri taşımak için relocate()’i kullanın. İlişkili değişkenleri bir araya toplamak veya önemli değişkenleri öne taşımak isteyebilirsiniz. Varsayılan olarak relocate() değişkenleri öne taşır:
flights |>
  relocate(time_hour, air_time)
#> # A tibble: 336,776 × 19
#>   time_hour           air_time  year month   day dep_time sched_dep_time
#>   <dttm>                 <dbl> <int> <int> <int>    <int>          <int>
#> 1 2013-01-01 05:00:00      227  2013     1     1      517            515
#> 2 2013-01-01 05:00:00      227  2013     1     1      533            529
#> 3 2013-01-01 05:00:00      160  2013     1     1      542            540
#> 4 2013-01-01 05:00:00      183  2013     1     1      544            545
#> 5 2013-01-01 06:00:00      116  2013     1     1      554            600
#> 6 2013-01-01 05:00:00      150  2013     1     1      554            558
#> # ℹ 336,770 more rows
#> # ℹ 12 more variables: dep_delay <dbl>, arr_time <int>, …
Tıpkı mutate()’te olduğu gibi, .before ve .after argümanlarını kullanarak onları nereye koyacağınızı da belirtebilirsiniz:
flights |>
  relocate(year:dep_time, .after = time_hour)
flights |>
  relocate(starts_with("arr"), .before = dep_time)
3.3.5 Alıştırmalar
dep_time,sched_dep_timevedep_delay’i karşılaştırın. Bu üç sayının birbiriyle nasıl ilişkili olmasını beklersiniz?flightsiçindendep_time,dep_delay,arr_timevearr_delaydeğişkenlerini seçmenin olabildiğince çok yolunu bulun.Bir
select()çağrısında aynı değişkenin adını birden fazla kez belirtirseniz ne olur?-
any_of()fonksiyonu ne işe yarar? Bu vektörle birlikte neden yararlı olabilir?variables <- c("year", "month", "day", "dep_delay", "arr_delay") -
Aşağıdaki kodu çalıştırmanın sonucu sizi şaşırtıyor mu?
select()yardımcıları varsayılan olarak büyük ve küçük harfleri nasıl ele alır? Bu varsayılanı nasıl değiştirebilirsiniz? Ölçü birimini belirtmek için
air_time’ıair_time_minolarak yeniden adlandırın ve veri çerçevesinin başına taşıyın.-
Aşağıdaki kod neden çalışmıyor ve hata ne anlama geliyor?
3.4 Pipe operatörü
Yukarıda size pipe’ın basit örneklerini gösterdik; ama gerçek gücü, birden fazla fiili birleştirmeye başladığınızda ortaya çıkar. Örneğin Houston’daki IAH Havalimanı’na giden en hızlı uçuşları bulmak istediğinizi düşünün. Bunun için filter(), mutate(), select() ve arrange() fonksiyonlarını birleştirmeniz gerekir:
flights |>
  filter(dest == "IAH") |>
  mutate(speed = distance / air_time * 60) |>
  select(year:day, dep_time, carrier, flight, speed) |>
  arrange(desc(speed))
#> # A tibble: 7,198 × 7
#>    year month   day dep_time carrier flight speed
#>   <int> <int> <int>    <int> <chr>    <int> <dbl>
#> 1  2013     7     9      707 UA         226  522.
#> 2  2013     8    27     1850 UA        1128  521.
#> 3  2013     8    28      902 UA        1711  519.
#> 4  2013     8    28     2122 UA        1022  519.
#> 5  2013     6    11     1628 UA        1178  515.
#> 6  2013     8    27     1017 UA         333  515.
#> # ℹ 7,192 more rows
Bu işlem hattı dört adımdan oluşsa da fiiller her satırın başında yer aldığı için kodu gözden geçirmek kolaydır: flights verisiyle başla, sonra filtrele, yeni değişken oluştur, sütunları seç ve satırları sırala.
Pipe olmasaydı ne olurdu? Her fonksiyon çağrısını bir önceki çağrının içine yerleştirebilirdik:
Ya da bir sürü ara nesne kullanabilirdik:
Her iki biçimin de uygun olduğu durumlar vardır; ancak pipe operatörü çoğunlukla yazması ve okuması daha kolay veri analizi kodları oluşturur.
Kodunuza pipe operatörü eklemek için yerleşik Ctrl/Cmd + Shift + M klavye kısayolunu kullanmanızı öneririz. %>% yerine |> eklemek için Şekil 3.1’ta gösterildiği gibi RStudio ayarlarını değiştirmeniz gerekir. Birazdan %>% hakkında daha fazla bilgi vereceğiz.
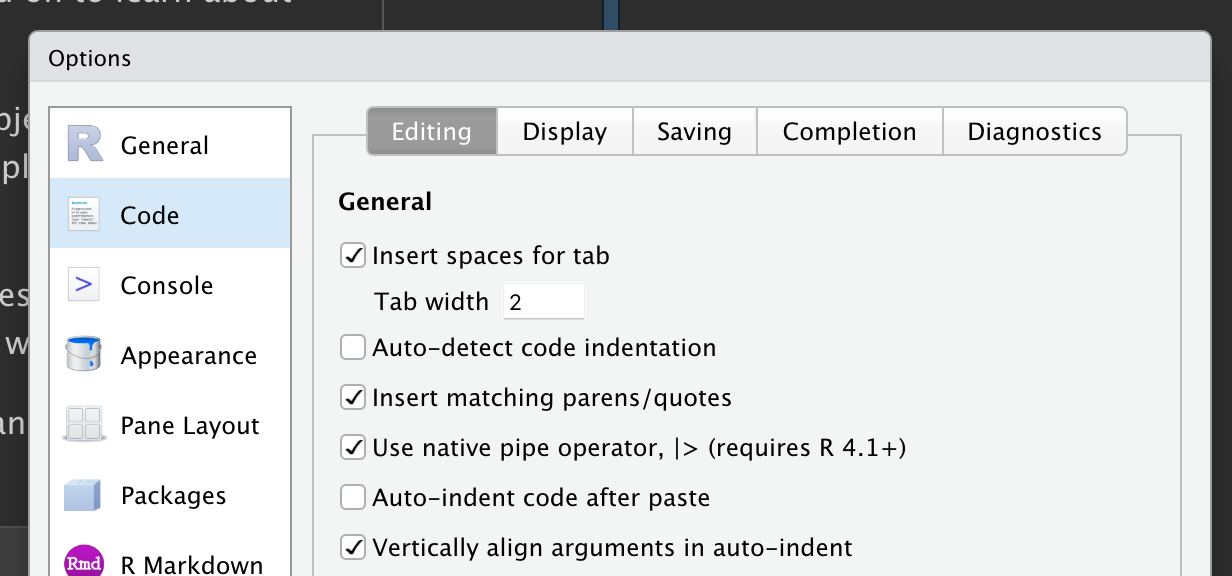
|> eklemek için “Use native pipe operator” seçeneğinin işaretli olduğundan emin olun.
Notmagrittr
Bir süredir tidyverse kullanıyorsanız magrittr paketinin sağladığı %>% pipe operatörünü biliyor olabilirsiniz. magrittr paketi çekirdek tidyverse’e dahildir, bu yüzden tidyverse’i her yüklediğinizde %>%’i kullanabilirsiniz:
Basit durumlar için, |> ve %>% aynı şekilde davranır. Peki neden temel pipe’ı öneriyoruz? İlk olarak, temel R’ın (base R) bir parçası olduğu için, tidyverse’i kullanmadığınızda bile kullanımınıza her zaman açıktır. İkincisi, |> operatörü %>% operatöründen çok daha basittir: %>%’nin 2014’te ortaya çıkışı ile |> operatörünün 2021’de R 4.1.0’a eklenmesi arasındaki sürede pipe kavramını daha iyi anlamaya başladık. Bu, temel uygulamanın nadiren kullanılan ve daha az önemli özellikleri bir kenara bırakmasına olanak tanıdı.
3.5 Gruplar
Şimdiye kadar satırlar ve sütunlarla çalışan fonksiyonlar hakkında bilgi edindiniz. Gruplarla çalışma yeteneğini eklediğinizde dplyr daha da güçlü hale gelir. Bu bölümde en önemli fonksiyonlara odaklanacağız: group_by(), summarize() ve slice_*() fonksiyon ailesi.
3.5.1 group_by()
Veri kümenizi analiziniz için anlamlı gruplara ayırmak için group_by()’ı kullanın:
flights |>
  group_by(month)
#> # A tibble: 336,776 × 19
#> # Groups:   month [12]
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
group_by() verileri değiştirmez; ancak çıktıya dikkatle bakarsanız month değişkenine göre “gruplandığını” belirten Groups: month [12] ifadesini görürsünüz. Bu, sonraki işlemlerin artık month grupları üzerinde çalışacağı anlamına gelir. group_by(), veri çerçevesine gruplu olma özelliğini (teknik adıyla bir sınıfı) ekler ve böylece daha sonra uygulanan fiillerin davranışını değiştirir.
3.5.2 summarize()
En önemli gruplu işlem özetlemedir: Tek bir özet istatistik hesaplandığında veri çerçevesi, her grup için bir satıra indirgenir. dplyr’de bu işlemi summarize()3 gerçekleştirir. Aşağıdaki örnek, month gruplarına göre ortalama kalkış gecikmesini hesaplar:
Eyvah! Bir şeyler ters gitti ve tüm sonuçlarımız, R’ın eksik değer sembolü olan (“N-A” diye telaffuz edilen) NA. Bu, gözlemlenen uçuşlardan bazılarının gecikme sütununda eksik verisi olması nedeniyle oldu; bu yüzden ortalamayı bu değerleri de dahil ederek hesapladığımızda bir NA sonucu elde ettik. Eksik değerleri Bölüm 18 bölümünde ayrıntılı olarak tartışmak üzere geri döneceğiz; ama şimdilik, na.rm argümanını TRUE olarak ayarlayarak mean() fonksiyonuna tüm eksik değerleri yok saymasını söyleyeceğiz:
Tek bir summarize() çağrısında istediğiniz sayıda özet oluşturabilirsiniz. Sonraki bölümlerde çeşitli yararlı özetler öğreneceksiniz; ama çok yararlı bir özet, her gruptaki satır sayısını döndüren n()’dir:
Ortalamalar ve sayımlar, veri biliminde sizi şaşırtıcı derecede ileriye götürebilir!
3.5.3 slice_*() fonksiyonları
Her grup içindeki belirli satırları çıkarmanızı sağlayan beş kullanışlı fonksiyon vardır:
-
df |> slice_head(n = 1), her gruptan ilk satırı alır. -
df |> slice_tail(n = 1), her gruptaki son satırı alır. -
df |> slice_min(x, n = 1),xsütununun en küçük değerine sahip satırı alır. -
df |> slice_max(x, n = 1),xsütununun en büyük değerine sahip satırı alır. -
df |> slice_sample(n = 1), rastgele bir satır alır.
Birden fazla satır seçmek için n’i değiştirebilir veya n = yerine, her gruptaki satırların (örneğin) %10’unu seçmek için prop = 0.1 kullanabilirsiniz. Örneğin, aşağıdaki kod her varış noktasında varışta en çok geciken uçuşları bulur:
flights |>
  group_by(dest) |>
  slice_max(arr_delay, n = 1) |>
  relocate(dest)
#> # A tibble: 108 × 19
#> # Groups:   dest [105]
#>   dest   year month   day dep_time sched_dep_time dep_delay arr_time
#>   <chr> <int> <int> <int>    <int>          <int>     <dbl>    <int>
#> 1 ABQ    2013     7    22     2145           2007        98      132
#> 2 ACK    2013     7    23     1139            800       219     1250
#> 3 ALB    2013     1    25      123           2000       323      229
#> 4 ANC    2013     8    17     1740           1625        75     2042
#> 5 ATL    2013     7    22     2257            759       898      121
#> 6 AUS    2013     7    10     2056           1505       351     2347
#> # ℹ 102 more rows
#> # ℹ 11 more variables: sched_arr_time <int>, arr_delay <dbl>, …
105 varış noktası olmasına rağmen burada 108 satır aldığımıza dikkat edin. Neler oluyor? slice_min() ve slice_max() eşit değerleri korur, bu yüzden n = 1 bize en yüksek değere sahip tüm satırları ver demektir. Grup başına tam olarak bir satır istiyorsanız with_ties = FALSE ayarlayabilirsiniz.
Bu, summarize() ile maksimum gecikmeyi hesaplamaya benzer; ama tek bir özet istatistik yerine karşılık gelen satırın tamamını (veya eşitlik varsa satırları) elde edersiniz.
3.5.4 Birden fazla değişkene göre gruplama
Birden fazla değişken kullanarak gruplar oluşturabilirsiniz. Örneğin, her tarih için bir grup oluşturabiliriz.
daily <- flights |>
  group_by(year, month, day)
daily
#> # A tibble: 336,776 × 19
#> # Groups:   year, month, day [365]
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Birden fazla değişkene göre gruplanmış bir tibble’ı özetlediğinizde her özetleme, gruplama düzeylerinden sonuncusunu kaldırır. Bugünden geriye baktığımızda bunun fonksiyon için pek iyi bir davranış olmadığını görüyoruz; ancak mevcut kodları bozmadan değiştirmek zordur. Neler olduğunu açık hale getirmek için dplyr, bu davranışı nasıl değiştirebileceğinizi söyleyen bir mesaj gösterir:
daily_flights <- daily |>
  summarize(n = n())
#> `summarise()` has regrouped the output.
#> ℹ Summaries were computed grouped by year, month, and day.
#> ℹ Output is grouped by year and month.
#> ℹ Use `summarise(.groups = "drop_last")` to silence this message.
#> ℹ Use `summarise(.by = c(year, month, day))` for per-operation grouping
#>   (`?dplyr::dplyr_by`) instead.
Bu davranıştan memnunsanız, mesajı bastırmak için bunu açıkça talep edebilirsiniz:
Alternatif olarak, farklı bir değer ayarlayarak varsayılan davranışı değiştirin; örneğin, tüm gruplamayı kaldırmak için "drop" veya aynı grupları korumak için "keep".
3.5.5 Gruplamayı kaldırma
summarize() kullanmadan bir veri çerçevesinden gruplamayı da kaldırmak isteyebilirsiniz. Bunu ungroup() ile yapabilirsiniz.
daily |>
  ungroup()
#> # A tibble: 336,776 × 19
#>    year month   day dep_time sched_dep_time dep_delay arr_time sched_arr_time
#>   <int> <int> <int>    <int>          <int>     <dbl>    <int>          <int>
#> 1  2013     1     1      517            515         2      830            819
#> 2  2013     1     1      533            529         4      850            830
#> 3  2013     1     1      542            540         2      923            850
#> 4  2013     1     1      544            545        -1     1004           1022
#> 5  2013     1     1      554            600        -6      812            837
#> 6  2013     1     1      554            558        -4      740            728
#> # ℹ 336,770 more rows
#> # ℹ 11 more variables: arr_delay <dbl>, carrier <chr>, flight <int>, …
Şimdi gruplanmamış bir veri çerçevesini özetlediğinizde ne olduğuna bakalım.
Tek bir satır elde edersiniz; çünkü dplyr, gruplanmamış bir veri çerçevesindeki tüm satırları tek bir gruba ait olarak ele alır.
3.5.6 .by
dplyr 1.1.0, işlem başına gruplama için yeni, deneysel bir sözdizimi olan .by argümanını içerir. group_by() ve ungroup() kullanılmaya devam edecek; ancak artık tek bir işlem içinde gruplama yapmak için .by argümanını da kullanabilirsiniz:
Ya da birden fazla değişkene göre gruplamak isterseniz:
.by, tüm fiillerle çalışır ve gruplama mesajını bastırmak için .groups argümanını kullanmanıza veya işiniz bittiğinde ungroup() kullanmanıza gerek olmaması gibi bir avantaja sahiptir.
Kitabı yazdığımız sırada çok yeni olduğu için bu bölümde söz dizimine odaklanmadık. Yine de gelecek vadettiğini ve büyük olasılıkla yaygınlaşacağını düşündüğümüz için söz etmek istedik. Bu konuda daha fazlasını dplyr 1.1.0 blog yazısında öğrenebilirsiniz.
3.5.7 Alıştırmalar
Hangi taşıyıcının ortalama gecikmeleri en kötü? Zor soru: sorunlu havalimanlarının etkilerini sorunlu taşıyıcıların etkilerinden ayırt edebilir misiniz? Neden ayırt edebilirsiniz veya neden edemezsiniz? (İpucu:
flights |> group_by(carrier, dest) |> summarize(n())üzerine düşünün)Her varış noktasına kalkışta en çok geciken uçuşları bulun.
Gecikmeler gün boyunca nasıl değişiyor? Cevabınızı bir grafikle gösterin.
slice_min()ve benzerlerine negatif birnverirseniz ne olur?count()’un yeni öğrendiğiniz dplyr fiilleri açısından ne yaptığını açıklayın.count()’unsortargümanı ne işe yarar?-
Aşağıdaki küçük veri çerçevesine sahip olduğumuzu varsayalım:
-
Çıktının neye benzeyeceğini yazın, sonra doğru olup olmadığınızı kontrol edin ve
group_by()’ın ne yaptığını açıklayın.df |> group_by(y) -
Çıktının neye benzeyeceğini yazın, sonra doğru olup olmadığınızı kontrol edin ve
arrange()’in ne yaptığını açıklayın. Ayrıca, bunun (a) şıkkındakigroup_by()’dan nasıl farklı olduğuna dair yorum yapın.df |> arrange(y) -
Çıktının neye benzeyeceğini yazın, sonra doğru olup olmadığınızı kontrol edin ve işlem hattının ne yaptığını açıklayın.
-
Çıktının neye benzeyeceğini yazın, sonra doğru olup olmadığınızı kontrol edin ve işlem hattının ne yaptığını açıklayın. Ardından, mesajın ne söylediğine dair yorum yapın.
-
Çıktının neye benzeyeceğini yazın, sonra doğru olup olmadığınızı kontrol edin ve işlem hattının ne yaptığını açıklayın. Çıktı, (d) şıkkındakinden nasıl farklı?
-
Çıktıların neye benzeyeceğini yazın, sonra doğru olup olmadığınızı kontrol edin ve her işlem hattının ne yaptığını açıklayın. İki işlem hattının çıktıları nasıl farklı?
-
3.6 Örnek olay: toplulaştırmalar ve örneklem büyüklüğü
Herhangi bir toplulaştırma yaptığınızda, her zaman bir sayım (n()) eklemek iyi bir fikirdir. Bu şekilde, çok küçük miktarda veriye dayanarak sonuç çıkarmadığınızdan emin olabilirsiniz. Bunu Lahman paketinden bazı beyzbol verileriyle göstereceğiz. Özellikle bir oyuncunun başarılı vuruş sayısının (H), topu oyuna sokmayı denediği toplam sayıya (AB) oranını inceleyeceğiz:
batters <- Lahman::Batting |>
  group_by(playerID) |>
  summarize(
    performance = sum(H, na.rm = TRUE) / sum(AB, na.rm = TRUE),
    n = sum(AB, na.rm = TRUE)
  )
batters
#> # A tibble: 24,011 × 3
#>   playerID  performance     n
#>   <chr>           <dbl> <int>
#> 1 aardsda01      0          4
#> 2 aaronha01      0.305  12364
#> 3 aaronto01      0.229    944
#> 4 aasedo01       0          5
#> 5 abadan01       0.0952    21
#> 6 abadfe01       0.111      9
#> # ℹ 24,005 more rows
Vurucunun becerisini (vuruş ortalamasıyla, performance, ölçülür) topa vurma fırsatlarının sayısına (vuruş sayısıyla, n, ölçülür) karşı çizdiğimizde, iki örüntü görürsünüz:
performance’taki varyasyon, daha az vuruşu olan oyuncular arasında daha büyüktür. Bu grafiğin şekli çok karakteristiktir: bir ortalamayı (veya başka bir özet istatistiği) grup büyüklüğüne karşı çizdiğinizde, örneklem büyüklüğü arttıkça varyasyonun azaldığını göreceksiniz4.Beceri (
performance) ile topa vurma fırsatları (n) arasında pozitif bir korelasyon vardır; çünkü takımlar en iyi vurucularına topa vurma konusunda en fazla fırsatı vermek ister.
batters |>
  filter(n > 100) |>
  ggplot(aes(x = n, y = performance)) +
  geom_point(alpha = 1 / 10) +
  geom_smooth(se = FALSE)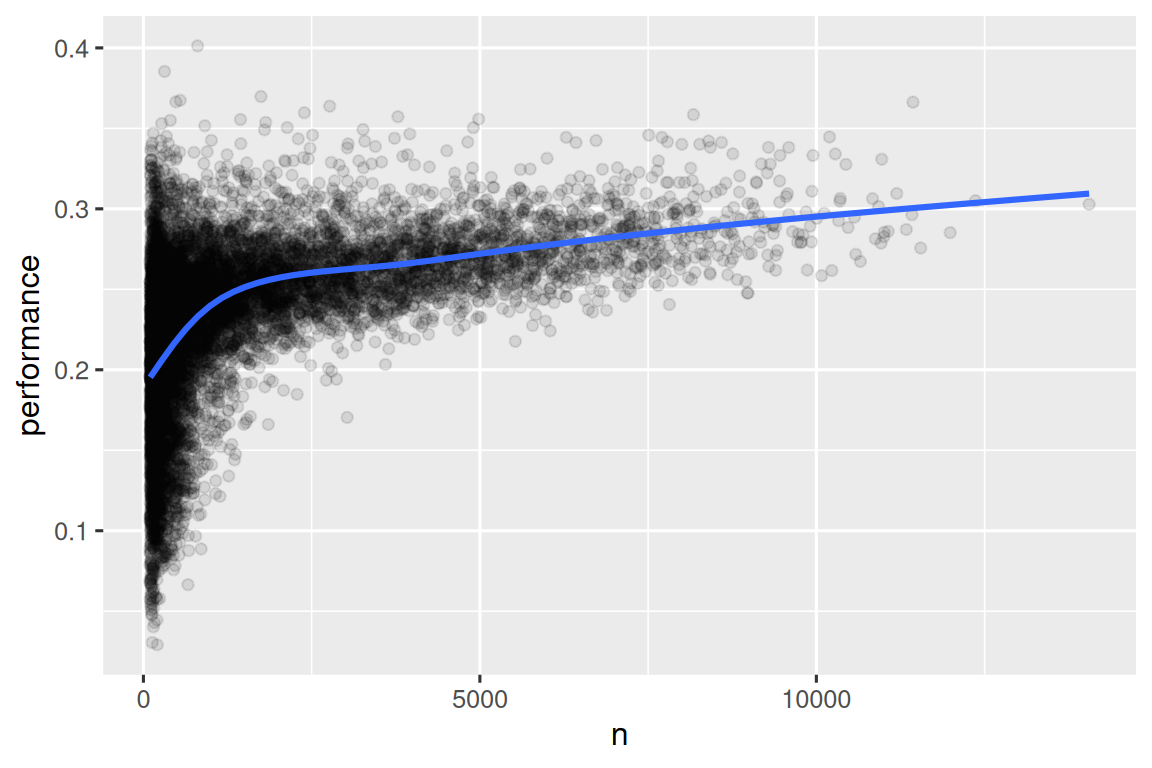
ggplot2 ile dplyr’ı birleştirirken kullanılan bu yararlı örüntüye dikkat edin. Veri kümesini işlerken |>, grafiğe katman eklerken + kullanmaya geçmeniz gerektiğini hatırlamanız yeterlidir.
Bunun sıralama için de önemli sonuçları vardır. Sonuçları düşünmeden yalnızca desc(performance) değerine göre sıralarsanız en iyi vuruş ortalamasına sahip kişiler, topu oyuna yalnızca birkaç kez sokmayı deneyip şans eseri başarılı olanlar çıkar. Bunlar mutlaka en yetenekli oyuncular değildir:
Bu problemin ve bunun nasıl aşılacağının iyi bir açıklamasını http://varianceexplained.org/r/empirical_bayes_baseball/ ve https://www.evanmiller.org/how-not-to-sort-by-average-rating.html adreslerinde bulabilirsiniz.
3.7 Özet
Bu bölümde, dplyr’in veri çerçeveleriyle çalışmak için sağladığı araçları öğrendiniz. Araçlar kabaca üç kategoriye ayrılır: satırları işleyenler (filter() ve arrange() gibi), sütunları işleyenler (select() ve mutate() gibi) ve grupları işleyenler (group_by() ve summarize() gibi). Bu bölümde “tüm veri çerçevesi” üzerinde çalışan araçlara odaklandık; ancak tek tek değişkenlerle neler yapabileceğiniz hakkında henüz pek bir şey öğrenmediniz. Buna, her bölümün belirli bir değişken türü için araçlar sağladığı kitabın Dönüştürme bölümünde geri döneceğiz.
Bir sonraki bölümde, kod stilinin önemini ve kodunuzu sizin ve başkalarının okuyup anlamasını kolaylaştıracak şekilde düzenli tutmayı tartışmak için iş akışına geri döneceğiz.
İleride, satırları konumlarına göre seçmenizi sağlayan
slice_*()ailesi hakkında bilgi edineceksiniz.↩︎RStudio’da çok sayıda sütunu olan bir veri kümesini görmenin en kolay yolunun
View()olduğunu unutmayın.↩︎Ya da İngiliz İngilizcesini tercih ediyorsanız
summarise().↩︎*öhöm* büyük sayılar yasası *öhöm*.↩︎