25 Fonksiyonlar
25.1 Giriş
Bir veri bilimci olarak etki alanınızı genişletmenin en iyi yollarından biri fonksiyon yazmaktır. Fonksiyonlar, yaygın görevleri kopyalayıp yapıştırmaya göre daha güçlü ve genel bir biçimde otomatikleştirmenizi sağlar. Fonksiyon yazmanın kopyala-yapıştır kullanmaya göre dört büyük avantajı vardır:
Fonksiyona, kodunuzu anlamayı kolaylaştıran açıklayıcı bir ad verebilirsiniz.
Gereksinimler değiştiğinde kodu birçok yerde değil yalnızca tek bir yerde güncellemeniz gerekir.
Kopyalayıp yapıştırırken istemeden hata yapma olasılığını ortadan kaldırırsınız (örneğin bir değişken adını bir yerde güncelleyip başka bir yerde güncellememek).
Çalışmaları projeler arasında yeniden kullanmayı kolaylaştırarak zaman içinde üretkenliğinizi artırır.
Kullanışlı bir genel kural, bir kod bloğunu ikiden fazla kez kopyalayıp yapıştırdığınızda (yani aynı kodun üç kopyasına sahip olduğunuzda) fonksiyon yazmayı düşünmektir. Bu bölümde üç kullanışlı fonksiyon türünü öğreneceksiniz:
- Vektör fonksiyonları girdi olarak bir ya da daha fazla vektör alır ve çıktı olarak bir vektör döndürür.
- Veri çerçevesi fonksiyonları girdi olarak bir veri çerçevesi alır ve çıktı olarak bir veri çerçevesi döndürür.
- Grafik fonksiyonları girdi olarak bir veri çerçevesi alır ve çıktı olarak bir grafik döndürür.
Bu kısımların her biri gördüğünüz örüntüleri genellemenize yardımcı olacak birçok örnek içerir. Bu örnekler Twitter’daki kişilerin yardımı olmadan mümkün olmazdı; özgün esin kaynaklarını görmek için yorumlardaki bağlantıları izlemenizi öneririz. Daha fazla fonksiyon görmek için genel fonksiyonlar ve grafik fonksiyonları hakkındaki ilk fikirleri doğuran tweet’leri de okuyabilirsiniz.
25.1.1 Ön koşullar
tidyverse genelindeki çeşitli fonksiyonları kendi fonksiyonlarımız içinde bir araya getireceğiz. Ayrıca fonksiyonlarımızı tanıdık veriler üzerinde kullanmak için nycflights13 paketinden yararlanacağız.
25.2 Vektör fonksiyonları
Bir ya da daha fazla vektör alıp vektör sonucu döndüren vektör fonksiyonlarıyla başlayacağız. Örneğin aşağıdaki koda bakın. Ne yapıyor?
df <- tibble(
  a = rnorm(5),
  b = rnorm(5),
  c = rnorm(5),
  d = rnorm(5),
)

df |> mutate(
  a = (a - min(a, na.rm = TRUE)) /
    (max(a, na.rm = TRUE) - min(a, na.rm = TRUE)),
  b = (b - min(a, na.rm = TRUE)) /
    (max(b, na.rm = TRUE) - min(b, na.rm = TRUE)),
  c = (c - min(c, na.rm = TRUE)) /
    (max(c, na.rm = TRUE) - min(c, na.rm = TRUE)),
  d = (d - min(d, na.rm = TRUE)) /
    (max(d, na.rm = TRUE) - min(d, na.rm = TRUE)),
)
#> # A tibble: 5 × 4
#>       a       b     c     d
#>   <dbl>   <dbl> <dbl> <dbl>
#> 1 0.339  0.387  0.291 0
#> 2 0.880 -0.613  0.611 0.557
#> 3 0     -0.0833 1     0.752
#> 4 0.795 -0.0822 0     1
#> 5 1     -0.0952 0.580 0.394
Bu kodun her sütunu 0 ile 1 arasında bir aralığa yeniden ölçeklendirdiğini çıkarabilirsiniz. Peki hatayı fark ettiniz mi? Hadley bu kodu yazarken kopyalayıp yapıştırma sırasında hata yapmış ve bir a değerini b olarak değiştirmeyi unutmuştur. Bu tür hataları önlemek, fonksiyon yazmayı öğrenmek için çok iyi bir nedendir.
25.2.1 Fonksiyon yazma
Bir fonksiyon yazmak için önce yinelenen kodunuzu çözümleyerek hangi bölümlerin sabit, hangilerinin değişken olduğunu belirlemeniz gerekir. Yukarıdaki kodu mutate() dışına çıkarırsak her yineleme artık tek satırda olduğundan örüntüyü görmek biraz kolaylaşır:
Bunu biraz daha belirginleştirmek için değişen bölümü █ ile değiştirebiliriz:
(█ - min(█, na.rm = TRUE)) / (max(█, na.rm = TRUE) - min(█, na.rm = TRUE))Bunu bir fonksiyona dönüştürmek için üç şeye ihtiyacınız vardır:
Bir ad. Bu fonksiyon bir vektörü 0 ile 1 arasına yeniden ölçeklendirdiği için burada
rescale01kullanacağız.Argümanlar. Argümanlar çağrılar arasında değişen şeylerdir ve yukarıdaki çözümlememiz yalnızca bir tane olduğunu gösterir. Sayısal bir vektör için geleneksel ad bu olduğundan ona
xdiyeceğiz.Gövde. Gövde, tüm çağrılarda yinelenen koddur.
Ardından aşağıdaki şablonu izleyerek bir fonksiyon oluşturursunuz:
name <- function(arguments) {
  body
}
Bu durumda sonuç şöyledir:
Bu noktada mantığı doğru aktardığınızdan emin olmak için birkaç basit girdiyi sınayabilirsiniz:
Ardından mutate() çağrısını şöyle yeniden yazabilirsiniz:
df |> mutate(
  a = rescale01(a),
  b = rescale01(b),
  c = rescale01(c),
  d = rescale01(d),
)
#> # A tibble: 5 × 4
#>       a     b     c     d
#>   <dbl> <dbl> <dbl> <dbl>
#> 1 0.339 1     0.291 0
#> 2 0.880 0     0.611 0.557
#> 3 0     0.530 1     0.752
#> 4 0.795 0.531 0     1
#> 5 1 0.518 0.580 0.394(Bölüm 26 bölümünde, yinelemeyi daha da azaltmak için across() kullanmayı öğreneceksiniz; böylece yalnızca df |> mutate(across(a:d, rescale01)) yazmanız yeterli olacak.)
25.2.2 Fonksiyonumuzu geliştirme
rescale01() fonksiyonunun bazı gereksiz işlemler yaptığını fark edebilirsiniz: min() fonksiyonunu iki, max() fonksiyonunu bir kez hesaplamak yerine range() ile hem en küçük hem en büyük değeri tek adımda hesaplayabiliriz:
rescale01 <- function(x) {
  rng <- range(x, na.rm = TRUE)
  (x - rng[1]) / (rng[2] - rng[1])
}
Ya da bu fonksiyonu sonsuz bir değer içeren vektör üzerinde deneyebilirsiniz:
x <- c(1:10, Inf)
rescale01(x)
#>  [1]   0   0   0   0   0   0   0   0   0   0 NaN
Bu sonuç pek kullanışlı değildir; dolayısıyla range() fonksiyonundan sonsuz değerleri yok saymasını isteyebiliriz:
rescale01 <- function(x) {
  rng <- range(x, na.rm = TRUE, finite = TRUE)
  (x - rng[1]) / (rng[2] - rng[1])
}

rescale01(x)
#>  [1] 0.0000000 0.1111111 0.2222222 0.3333333 0.4444444 0.5555556 0.6666667
#>  [8] 0.7777778 0.8888889 1.0000000       Inf
Bu değişiklikler fonksiyonların önemli bir yararını gösterir: Yinelenen kodu bir fonksiyona taşıdığımız için değişikliği yalnızca tek bir yerde yapmamız gerekir.
25.2.3 Mutate fonksiyonları
Fonksiyonların temel fikrini kavradığınıza göre birçok örneğe bakalım. Girdiyle aynı uzunlukta çıktı döndürdükleri için mutate() ve filter() içinde iyi çalışan “mutate” fonksiyonlarıyla başlayacağız.
rescale01() fonksiyonunun basit bir çeşidiyle başlayalım. Bir vektörü ortalaması sıfır, standart sapması bir olacak biçimde yeniden ölçeklendiren Z-skorunu hesaplamak isteyebilirsiniz:
Ya da basit bir case_when() çağrısını fonksiyonda toplayıp ona kullanışlı bir ad vermek isteyebilirsiniz. Örneğin bu clamp() fonksiyonu bir vektörün tüm değerlerinin en küçük ve en büyük değer arasında kalmasını sağlar:
clamp <- function(x, min, max) {
  case_when(
    x < min ~ min,
    x > max ~ max,
    .default = x
  )
}

clamp(1:10, min = 3, max = 7)
#>  [1] 3 3 3 4 5 6 7 7 7 7
Elbette fonksiyonların yalnızca sayısal değişkenlerle çalışması gerekmez. Yinelenen bazı karakter dizisi işlemleri yapmak isteyebilirsiniz. Örneğin ilk karakteri büyük harfe dönüştürmeniz gerekebilir:
first_upper <- function(x) {
  str_sub(x, 1, 1) <- str_to_upper(str_sub(x, 1, 1))
  x
}

first_upper("merhaba")
#> [1] "Merhaba"
Ya da bir karakter dizisini sayıya dönüştürmeden önce yüzde, virgül ve dolar işaretlerini kaldırmak isteyebilirsiniz:
# https://twitter.com/NVlabormarket/status/1571939851922198530
clean_number <- function(x) {
  is_pct <- str_detect(x, "%")
  num <- x |>
    str_remove_all("%") |>
    str_remove_all(",") |>
    str_remove_all(fixed("$")) |>
    as.numeric()
  if_else(is_pct, num / 100, num)
}

clean_number("$12,300")
#> [1] 12300
clean_number("45%")
#> [1] 0.45
Bazen fonksiyonlarınız tek bir veri analizi adımı için son derece özelleşmiş olur. Örneğin eksik değerleri 997, 998 ya da 999 olarak kaydeden birçok değişkeniniz varsa bunları NA ile değiştiren bir fonksiyon yazmak isteyebilirsiniz:
En yaygın olanların bunlar olduğunu düşündüğümüz için tek bir vektör alan örneklere odaklandık. Ancak fonksiyonunuzun birden çok vektör girdisi almaması için hiçbir neden yoktur.
25.2.4 Özet fonksiyonları
Vektör fonksiyonlarının bir başka önemli ailesi, summarize() içinde kullanılmak üzere tek bir değer döndüren özet fonksiyonlarıdır. Bazen yalnızca bir ya da iki varsayılan argüman ayarlamak yeterlidir:
commas <- function(x) {
  str_flatten(x, collapse = ", ", last = " ve ")
}

commas(c("kedi", "köpek", "güvercin"))
#> [1] "kedi, köpek ve güvercin"
Ya da standart sapmayı ortalamaya bölen değişim katsayısı gibi basit bir hesaplamayı fonksiyon içinde toplayabilirsiniz:
Ya da yaygın bir örüntüye akılda kalıcı bir ad vererek onu hatırlamayı kolaylaştırmak isteyebilirsiniz:
Birden çok vektör girdisi alan fonksiyonlar da yazabilirsiniz. Örneğin model tahminlerini gerçek değerlerle karşılaştırmanıza yardımcı olması için ortalama mutlak yüzde hatayı hesaplamak isteyebilirsiniz:
Fonksiyon yazmaya başladığınızda iki RStudio kısayolu son derece kullanışlıdır:
Yazdığınız bir fonksiyonun tanımını bulmak için imleci fonksiyon adının üzerine getirin ve
F2tuşuna basın.Bir fonksiyona hızla gitmek için bulanık dosya ve fonksiyon bulucuyu
Ctrl + .ile açıp fonksiyon adının ilk birkaç harfini yazın. Dosyalara, Quarto kısımlarına ve daha fazlasına da gidebildiğiniz için bu çok kullanışlı bir gezinme aracıdır.
25.2.5 Alıştırmalar
-
Aşağıdaki kod parçalarını fonksiyonlara dönüştürme alıştırması yapın. Her fonksiyonun ne yaptığını düşünün. Ona ne ad verirdiniz? Kaç argümana ihtiyacı var?
rescale01()fonksiyonunun ikinci çeşidinde sonsuz değerler değişmeden bırakılır.-Infdeğerini 0’a,Infdeğerini 1’e eşleyecek biçimderescale01()fonksiyonunu yeniden yazabilir misiniz?Bir doğum tarihleri vektörü verildiğinde yaşı yıl cinsinden hesaplayan bir fonksiyon yazın.
Sayısal bir vektörün varyansını ve çarpıklığını hesaplayan kendi fonksiyonlarınızı yazın. Tanımlara Wikipedia’dan ya da başka bir kaynaktan bakabilirsiniz.
Aynı uzunluktaki iki vektörü alan ve her iki vektörde de
NAbulunan konumların sayısını döndürenboth_na()özet fonksiyonunu yazın.-
Aşağıdaki fonksiyonların ne yaptığını anlamak için belgeleri okuyun. Bu kadar kısa olmalarına karşın neden kullanışlıdırlar?
is_directory <- function(x) {
  file.info(x)$isdir
}
is_readable <- function(x) {
  file.access(x, 4) == 0
}
25.3 Veri çerçevesi fonksiyonları
Vektör fonksiyonları, bir dplyr fiili içinde yinelenen kodu ayırmak için kullanışlıdır. Ancak özellikle büyük bir işlem hattında fiillerin kendilerini de sık sık yinelersiniz. Birden çok fiili tekrar tekrar kopyalayıp yapıştırdığınızı fark ettiğinizde veri çerçevesi fonksiyonu yazmayı düşünebilirsiniz. Veri çerçevesi fonksiyonları dplyr fiilleri gibi çalışır: İlk argüman olarak bir veri çerçevesi, onunla ne yapılacağını belirten bazı ek argümanlar alır ve bir veri çerçevesi ya da vektör döndürür.
dplyr fiillerini kullanan fonksiyonlar yazabilmeniz için önce dolaylılık sorununu ve bu sorunu sarmalama, {{ }}, ile nasıl aşabileceğinizi tanıtacağız. Bu kuramsal temelin ardından onunla neler yapabileceğinizi gösteren birçok örnek sunacağız.
25.3.1 Dolaylılık ve tidy evaluation
dplyr fiillerini kullanan fonksiyonlar yazmaya başladığınızda dolaylılık sorunuyla hızla karşılaşırsınız. Sorunu çok basit bir fonksiyonla gösterelim: grouped_mean(). Bu fonksiyonun amacı mean_var ortalamasını group_var değişkenine göre gruplandırarak hesaplamaktır:
Kullanmaya çalışırsak hata alırız:
diamonds |> grouped_mean(cut, carat)
#> Error in `group_by()`:
#> ! Must group by variables found in `.data`.
#> ✖ Column `group_var` is not found.
Sorunu biraz daha açık hâle getirmek için yapay bir veri çerçevesi kullanabiliriz:
df <- tibble(
  mean_var = 1,
  group_var = "g",
  group = 1,
  x = 10,
  y = 100
)

df |> grouped_mean(group, x)
#> # A tibble: 1 × 2
#>   group_var `mean(mean_var)`
#>   <chr>                <dbl>
#> 1 g                        1
df |> grouped_mean(group, y)
#> # A tibble: 1 × 2
#>   group_var `mean(mean_var)`
#>   <chr>                <dbl>
#> 1 g                        1
grouped_mean() fonksiyonunu nasıl çağırırsak çağıralım df |> group_by(group) |> summarize(mean(x)) ya da df |> group_by(group) |> summarize(mean(y)) yerine her zaman df |> group_by(group_var) |> summarize(mean(mean_var)) işlemini yapar. Bu bir dolaylılık sorunudur ve dplyr, veri çerçevenizdeki değişken adlarına özel bir işlem yapmadan başvurmanızı sağlamak için tidy evaluation kullandığından ortaya çıkar.
Tidy evaluation, bir değişkenin hangi veri çerçevesinden geldiğini hiçbir zaman belirtmeniz gerekmediği ve bu bağlamdan açıkça anlaşıldığı için zamanın %95’inde harikadır; veri çözümlemelerinizi çok kısa hâle getirir. Tidy evaluation’ın dezavantajı, yinelenen tidyverse kodunu bir fonksiyonda toplamak istediğimizde ortaya çıkar. Burada group_by() ve summarize() fonksiyonlarına group_var ile mean_var ifadelerini değişken adları olarak ele almamalarını, bunun yerine gerçekten kullanmak istediğimiz değişkeni bulmak için içlerine bakmalarını söyleyecek bir yola ihtiyacımız vardır.
Tidy evaluation, bu sorun için sarmalama (embracing) 🤗 adlı bir çözüm içerir. Bir değişkeni sarmalamak, onu süslü parantezler içine almaktır; örneğin var, {{ var }} olur. Bir değişkeni sarmalamak, dplyr’a argümanı değişmez değişken adı olarak değil, argümanın içinde saklanan değeri kullanmasını söyler. Neler olduğunu hatırlamanın bir yolu {{ }} işaretini bir tünelin içine bakmak gibi düşünmektir: {{ var }}, dplyr fonksiyonunun var adlı değişkeni aramak yerine var argümanının içine bakmasını sağlar.
Dolayısıyla grouped_mean() fonksiyonunun çalışması için group_var ve mean_var ifadelerini {{ }} içine almamız gerekir:
Başardık!
25.3.2 Ne zaman sarmalamalı?
Veri çerçevesi fonksiyonları yazarken temel zorluk, hangi argümanların sarmalanması gerektiğini belirlemektir. Neyse ki bunu belgelerden bulabileceğiniz için kolaydır 😄. Belgelerde tidy evaluation’ın en yaygın iki alt türüne karşılık gelen iki terimi aramalısınız:
Veri maskeleme (data masking): Değişkenlerle hesaplama yapan
arrange(),filter()vesummarize()gibi fonksiyonlarda kullanılır.Tidy seçimi (tidy selection): Değişken seçen
select(),relocate()verename()gibi fonksiyonlarda kullanılır.
Hangi argümanların tidy evaluation kullandığına ilişkin sezginiz birçok yaygın fonksiyon için yeterli olacaktır: Yalnızca hesaplama (x + 1 gibi) mı yoksa seçim (a:x gibi) mi yapabildiğinizi düşünün.
Aşağıdaki kısımlarda sarmalamayı anladıktan sonra yazabileceğiniz kullanışlı fonksiyon türlerini inceleyeceğiz.
25.3.3 Yaygın kullanım durumları
İlk veri keşfi sırasında aynı özet kümesini sık sık hesaplıyorsanız bunları bir yardımcı fonksiyonda toplamayı düşünebilirsiniz:
summary6 <- function(data, var) {
  data |> summarize(
    min = min({{ var }}, na.rm = TRUE),
    mean = mean({{ var }}, na.rm = TRUE),
    median = median({{ var }}, na.rm = TRUE),
    max = max({{ var }}, na.rm = TRUE),
    n = n(),
    n_miss = sum(is.na({{ var }})),
    .groups = "drop"
  )
}

diamonds |> summary6(carat)
#> # A tibble: 1 × 6
#>     min  mean median   max     n n_miss
#>   <dbl> <dbl>  <dbl> <dbl> <int>  <int>
#> 1 0.2 0.798 0.7 5.01 53940 0(summarize() fonksiyonunu bir yardımcıda her kullandığınızda hem iletiyi önlemek hem verileri gruplanmamış durumda bırakmak için .groups = "drop" ayarını kullanmanın iyi bir uygulama olduğunu düşünüyoruz.)
Bu fonksiyonun güzel yanı, summarize() fonksiyonunu sardığı için gruplanmış veriler üzerinde kullanılabilmesidir:
diamonds |>
  group_by(cut) |>
  summary6(carat)
#> # A tibble: 5 × 7
#>   cut         min  mean median   max     n n_miss
#>   <ord>     <dbl> <dbl>  <dbl> <dbl> <int>  <int>
#> 1 Fair       0.22 1.05    1     5.01  1610      0
#> 2 Good       0.23 0.849   0.82  3.01  4906      0
#> 3 Very Good  0.2  0.806   0.71  4    12082      0
#> 4 Premium    0.2  0.892   0.86  4.01 13791      0
#> 5 Ideal      0.2  0.703   0.54  3.5  21551      0
Ayrıca summarize argümanları veri maskeleme kullandığından summary6() fonksiyonunun var argümanı da bunu kullanır. Bu, hesaplanmış değişkenleri de özetleyebileceğiniz anlamına gelir:
diamonds |>
  group_by(cut) |>
  summary6(log10(carat))
#> # A tibble: 5 × 7
#>   cut          min    mean  median   max     n n_miss
#>   <ord>      <dbl>   <dbl>   <dbl> <dbl> <int>  <int>
#> 1 Fair      -0.658 -0.0273  0      0.700  1610      0
#> 2 Good      -0.638 -0.133  -0.0862 0.479  4906      0
#> 3 Very Good -0.699 -0.164  -0.149  0.602 12082      0
#> 4 Premium   -0.699 -0.125  -0.0655 0.603 13791      0
#> 5 Ideal     -0.699 -0.225  -0.268  0.544 21551      0
Birden çok değişkeni özetlemek için across() kullanmayı öğreneceğiniz Bölüm 26.2 bölümünü beklemeniz gerekecek.
Bir başka yaygın summarize() yardımcısı, oranları da hesaplayan bir count() çeşididir:
# https://twitter.com/Diabb6/status/1571635146658402309
count_prop <- function(df, var, sort = FALSE) {
  df |>
    count({{ var }}, sort = sort) |>
    mutate(prop = n / sum(n))
}

diamonds |> count_prop(clarity)
#> # A tibble: 8 × 3
#>   clarity     n   prop
#>   <ord>   <int>  <dbl>
#> 1 I1        741 0.0137
#> 2 SI2      9194 0.170
#> 3 SI1     13065 0.242
#> 4 VS2     12258 0.227
#> 5 VS1      8171 0.151
#> 6 VVS2     5066 0.0939
#> # ℹ 2 more rows
Bu fonksiyonun df, var ve sort olmak üzere üç argümanı vardır. Tüm değişkenler için veri maskeleme kullanan count() fonksiyonuna aktarıldığından yalnızca var sarmalanmalıdır. Kullanıcı kendi değerini sağlamazsa FALSE kullanılması için sort argümanına varsayılan bir değer verdiğimize dikkat edin.
Ya da verilerin bir alt kümesi için bir değişkenin sıralanmış benzersiz değerlerini bulmak isteyebilirsiniz. Süzme için bir değişken ve değer sağlamak yerine kullanıcının bir koşul sağlamasına izin vereceğiz:
unique_where <- function(df, condition, var) {
  df |>
    filter({{ condition }}) |>
    distinct({{ var }}) |>
    arrange({{ var }})
}

# Aralık ayındaki tüm varış noktalarını bul
flights |> unique_where(month == 12, dest)
#> # A tibble: 96 × 1
#>   dest
#>   <chr>
#> 1 ABQ
#> 2 ALB
#> 3 ATL
#> 4 AUS
#> 5 AVL
#> 6 BDL
#> # ℹ 90 more rows
Burada condition argümanını filter() fonksiyonuna, var argümanını ise distinct() ve arrange() fonksiyonlarına aktarıldıkları için sarmalarız.
Tüm bu örnekleri ilk argüman olarak bir veri çerçevesi alacak biçimde oluşturduk; ancak sürekli aynı verilerle çalışıyorsanız bunları doğrudan koda yazmak mantıklı olabilir. Örneğin aşağıdaki fonksiyon her zaman flights veri kümesiyle çalışır ve bir satırı tanımlamanızı sağlayan bileşik birincil anahtarı oluşturdukları için daima time_hour, carrier ve flight sütunlarını seçer.
25.3.4 Veri maskeleme ve tidy seçimi
Bazen veri maskeleme kullanan bir fonksiyon içinde değişken seçmek istersiniz. Örneğin satırlardaki eksik gözlem sayısını hesaplayan bir count_missing() fonksiyonu yazmak istediğinizi düşünün. Şuna benzer bir şey yazmayı deneyebilirsiniz:
count_missing <- function(df, group_vars, x_var) {
  df |>
    group_by({{ group_vars }}) |>
    summarize(
      n_miss = sum(is.na({{ x_var }})),
      .groups = "drop"
    )
}

flights |>
  count_missing(c(year, month, day), dep_time)
#> Error in `group_by()`:
#> ℹ In argument: `c(year, month, day)`.
#> Caused by error:
#> ! `c(year, month, day)` must be size 336776 or 1, not 1010328.
Bu çalışmaz; çünkü group_by() tidy seçimi değil, veri maskeleme kullanır. Veri maskeleme fonksiyonlarının içinde tidy seçimi kullanmanızı sağlayan kullanışlı pick() fonksiyonuyla bu sorunu aşabiliriz:
count_missing <- function(df, group_vars, x_var) {
  df |>
    group_by(pick({{ group_vars }})) |>
    summarize(
      n_miss = sum(is.na({{ x_var }})),
      .groups = "drop"
  )
}

flights |>
  count_missing(c(year, month, day), dep_time)
#> # A tibble: 365 × 4
#>    year month   day n_miss
#>   <int> <int> <int>  <int>
#> 1  2013     1     1      4
#> 2  2013     1     2      8
#> 3  2013     1     3     10
#> 4  2013     1     4      6
#> 5  2013     1     5      3
#> 6  2013     1     6      1
#> # ℹ 359 more rows
pick() fonksiyonunun bir başka kullanışlı uygulaması iki boyutlu bir sayım tablosu oluşturmaktır. Burada rows ve columns içindeki tüm değişkenleri kullanarak sayım yapar, ardından sayımları bir ızgarada düzenlemek için pivot_wider() kullanırız:
# https://twitter.com/pollicipes/status/1571606508944719876
count_wide <- function(data, rows, cols) {
  data |>
    count(pick(c({{ rows }}, {{ cols }}))) |>
    pivot_wider(
      names_from = {{ cols }},
      values_from = n,
      names_sort = TRUE,
      values_fill = 0
    )
}

diamonds |> count_wide(c(clarity, color), cut)
#> # A tibble: 56 × 7
#>   clarity color  Fair  Good `Very Good` Premium Ideal
#>   <ord>   <ord> <int> <int>       <int>   <int> <int>
#> 1 I1      D         4     8           5      12    13
#> 2 I1      E         9    23          22      30    18
#> 3 I1      F        35    19          13      34    42
#> 4 I1      G        53    19          16      46    16
#> 5 I1      H        52    14          12      46    38
#> 6 I1      I        34     9           8      24    17
#> # ℹ 50 more rows
Örneklerimiz çoğunlukla dplyr’a odaklansa da tidyr’ın temelinde de tidy evaluation vardır; pivot_wider() belgelerine bakarsanız names_from argümanının tidy seçimi kullandığını görebilirsiniz.
25.3.5 Alıştırmalar
-
nycflights13 paketindeki veri kümelerini kullanarak aşağıdakileri yapan bir fonksiyon yazın:
-
İptal edilen (yani
is.na(arr_time)) veya bir saatten fazla geciken tüm uçuşları bulur.flights |> filter_severe() -
İptal edilen uçuşların ve bir saatten fazla geciken uçuşların sayısını hesaplar.
flights |> group_by(dest) |> summarize_severe() -
İptal edilen veya kullanıcının belirttiği saat sayısından daha fazla geciken tüm uçuşları bulur:
flights |> filter_severe(hours = 2) -
Kullanıcının belirttiği bir değişkenin en küçük, ortalama ve en büyük değerlerini hesaplamak için hava durumu verilerini özetler:
weather |> summarize_weather(temp) -
Saat biçimini kullanan, kullanıcı tarafından sağlanmış değişkeni (
dep_time,arr_timevb.) ondalık zamana (yani saat + dakika / 60) dönüştürür.flights |> standardize_time(sched_dep_time)
-
Aşağıdaki fonksiyonların her biri için tidy evaluation kullanan tüm argümanları listeleyin ve veri maskeleme mi yoksa tidy seçimi mi kullandıklarını açıklayın:
distinct(),count(),group_by(),rename_with(),slice_min(),slice_sample().-
Aşağıdaki fonksiyonu, sayım için istediğiniz sayıda değişken sağlayabileceğiniz biçimde genelleştirin.
25.4 Grafik fonksiyonları
Bir veri çerçevesi yerine grafik döndürmek isteyebilirsiniz. Neyse ki aes() bir veri maskeleme fonksiyonu olduğundan aynı teknikleri ggplot2 ile kullanabilirsiniz. Örneğin çok sayıda histogram oluşturduğunuzu düşünün:
diamonds |>
  ggplot(aes(x = carat)) +
  geom_histogram(binwidth = 0.1)

diamonds |>
  ggplot(aes(x = carat)) +
  geom_histogram(binwidth = 0.05)
Bunu bir histogram fonksiyonunda toplamak güzel olmaz mıydı? aes() fonksiyonunun veri maskeleme kullandığını ve argümanı sarmalamanız gerektiğini bildiğinizde bunu yapmak çok kolaydır:
histogram <- function(df, var, binwidth = NULL) {
  df |>
    ggplot(aes(x = {{ var }})) +
    geom_histogram(binwidth = binwidth)
}

diamonds |> histogram(carat, 0.1)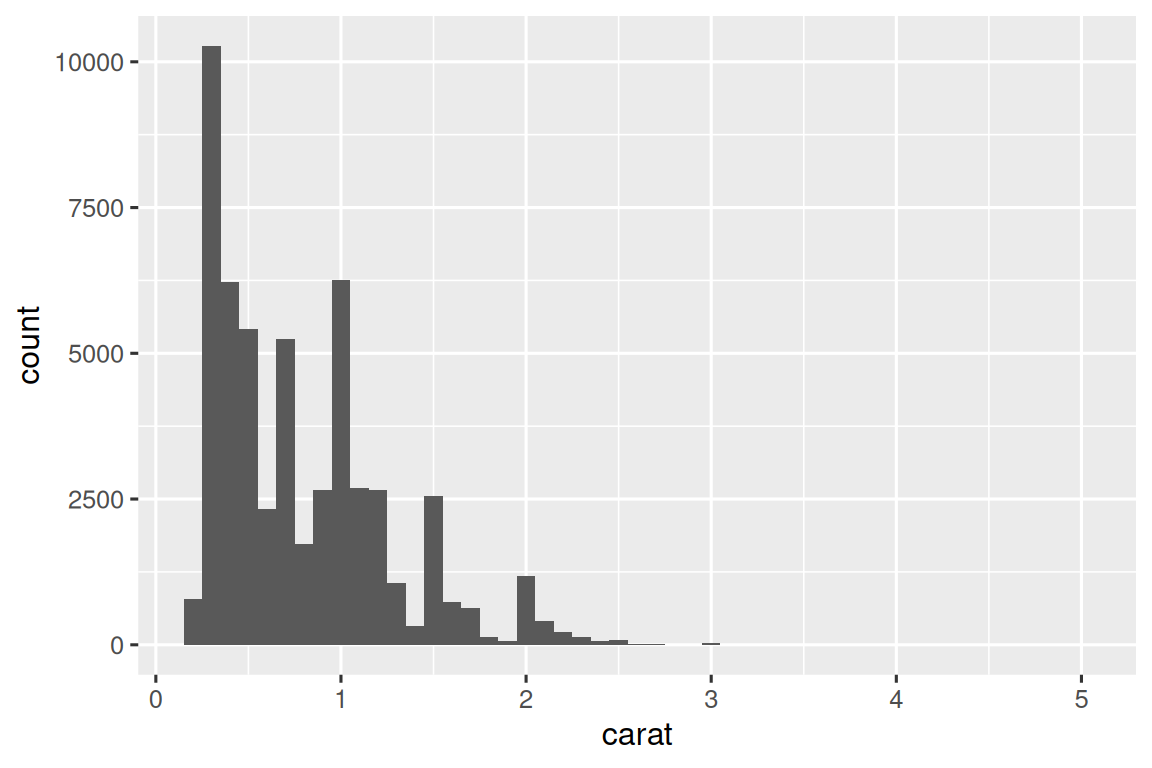
histogram() fonksiyonunun bir ggplot2 grafiği döndürdüğüne dikkat edin; yani isterseniz ek bileşenler ekleyebilirsiniz. Yalnızca |> yerine + kullanmayı unutmayın:
diamonds |>
  histogram(carat, 0.1) +
  labs(x = "Boyut (karat)", y = "Elmas sayısı")
25.4.1 Daha fazla değişken
Karışıma daha fazla değişken eklemek kolaydır. Örneğin yumuşak bir eğriyle düz bir doğruyu üst üste çizerek bir veri kümesinin doğrusal olup olmadığını gözle değerlendirmenin kolay bir yolunu isteyebilirsiniz:
# https://twitter.com/tyler_js_smith/status/1574377116988104704
linearity_check <- function(df, x, y) {
  df |>
    ggplot(aes(x = {{ x }}, y = {{ y }})) +
    geom_point() +
    geom_smooth(method = "loess", formula = y ~ x, color = "red", se = FALSE) +
    geom_smooth(method = "lm", formula = y ~ x, color = "blue", se = FALSE)
}

starwars |>
  filter(mass < 1000) |>
  linearity_check(mass, height)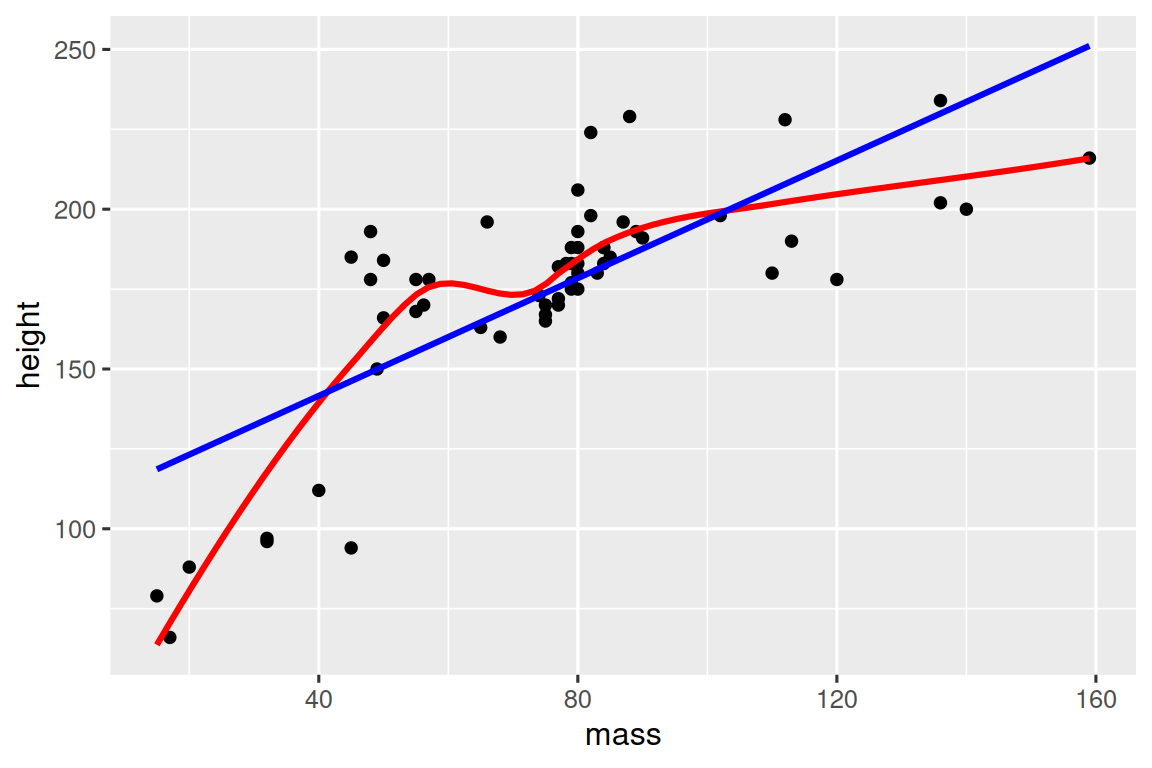
Ya da üst üste çizimin sorun olduğu çok büyük veri kümeleri için renkli dağılım grafiklerine bir seçenek isteyebilirsiniz:
# https://twitter.com/ppaxisa/status/1574398423175921665
hex_plot <- function(df, x, y, z, bins = 20, fun = "mean") {
  df |>
    ggplot(aes(x = {{ x }}, y = {{ y }}, z = {{ z }})) +
    stat_summary_hex(
      aes(color = after_scale(fill)), # Kenarlığı dolgu ile aynı renkte yap
      bins = bins,
      fun = fun,
    )
}

diamonds |> hex_plot(carat, price, depth)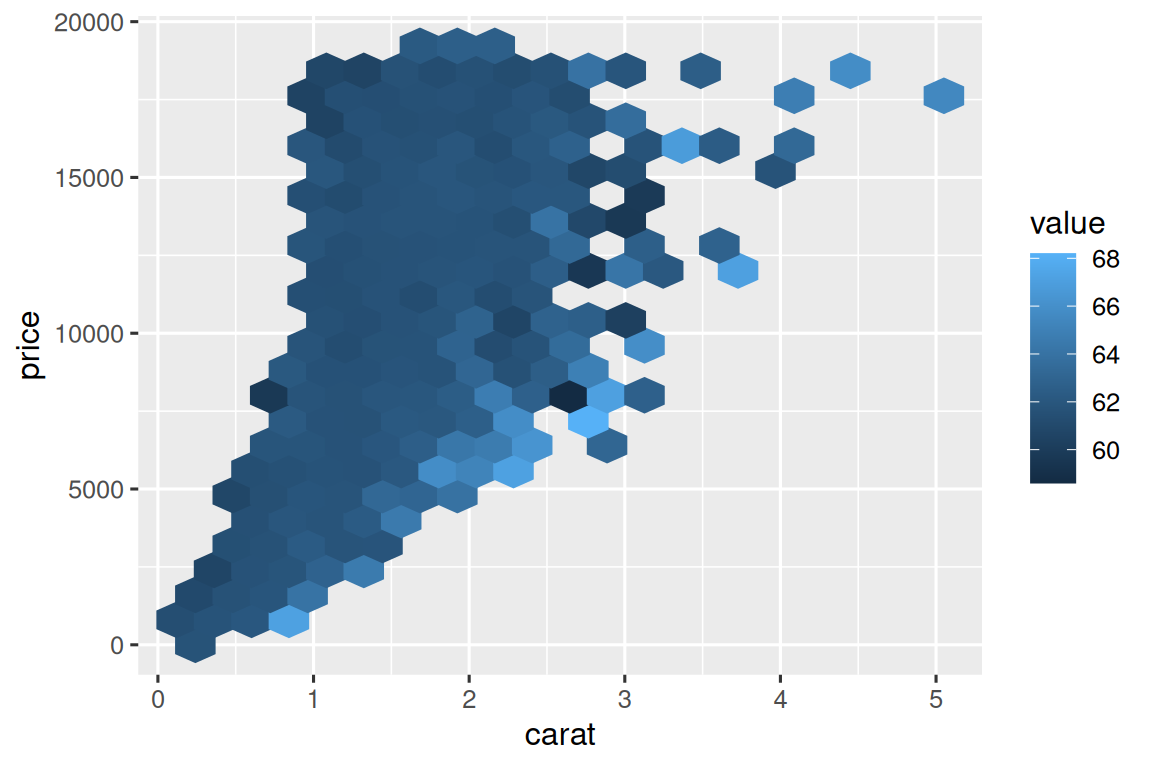
25.4.2 Diğer tidyverse araçlarıyla birleştirme
En kullanışlı yardımcılardan bazıları bir miktar veri işlemeyi ggplot2 ile birleştirir. Örneğin çubukları fct_infreq() ile sıklık sırasına göre otomatik olarak sıralayan dikey bir çubuk grafik isteyebilirsiniz. Çubuk grafik dikey olduğundan en yüksek değerleri üste almak için olağan sırayı tersine çevirmemiz de gerekir:
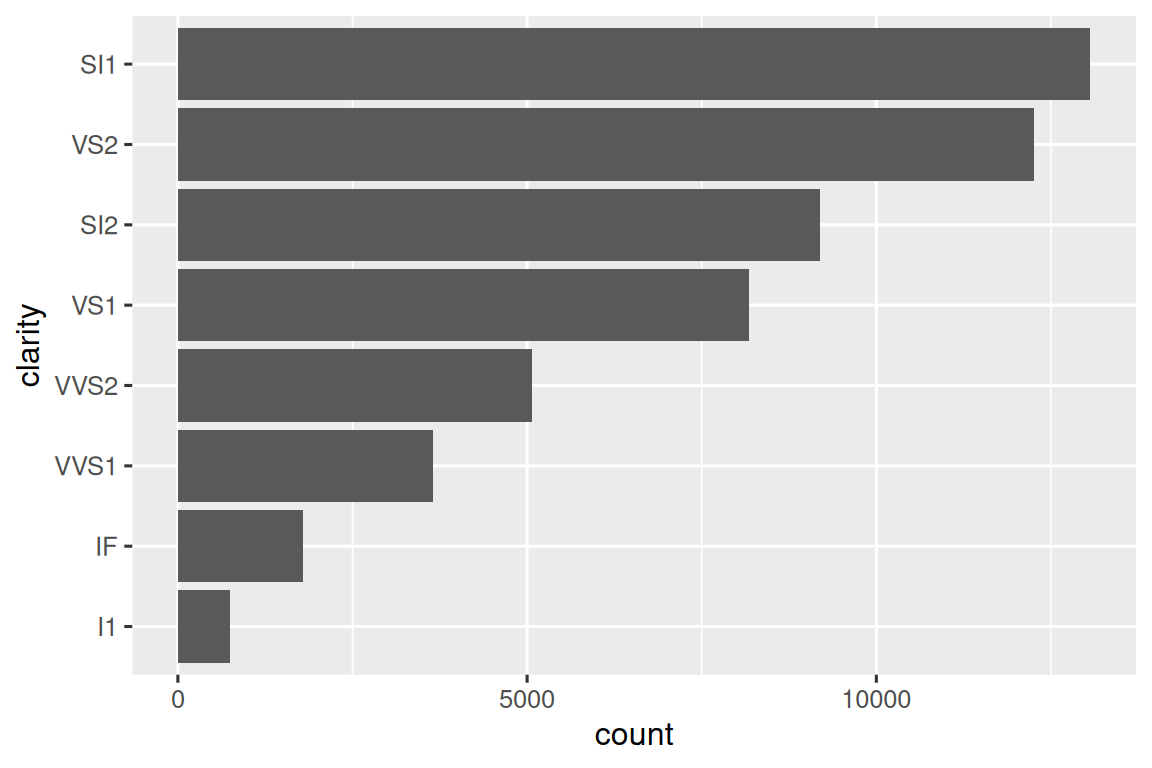
Değişken adını kullanıcının sağladığı verilere göre ürettiğimiz için burada yeni bir işleç olan := (yaygın adıyla “mors işleci”) kullanmalıyız. Değişken adları = işaretinin solunda yer alır; ancak R sözdizimi = işaretinin solunda tek bir değişmez ad dışında hiçbir şeye izin vermez. Bu sorunu aşmak için tidy evaluation’ın = ile tamamen aynı biçimde ele aldığı özel := işlecini kullanırız.
Ya da yalnızca verilerin bir alt kümesi için çubuk grafik çizmeyi kolaylaştırmak isteyebilirsiniz:
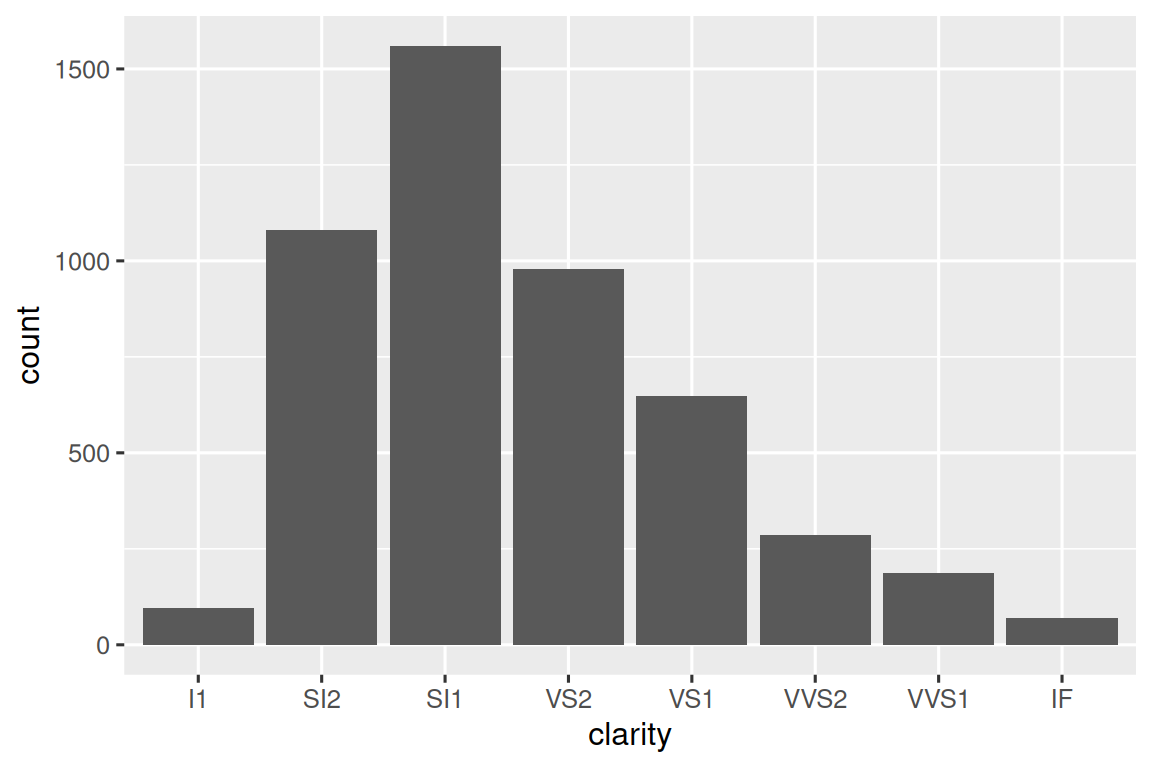
Yaratıcılığınızı kullanıp veri özetlerini başka biçimlerde de gösterebilirsiniz. En yüksek değeri göstermek için eksen etiketlerini kullanan güzel bir uygulamayı https://gist.github.com/GShotwell/b19ef520b6d56f61a830fabb3454965b adresinde bulabilirsiniz. ggplot2 hakkında daha fazlasını öğrendikçe fonksiyonlarınızın gücü artmayı sürdürecektir.
Daha karmaşık bir durumla bitireceğiz: Oluşturduğunuz grafikleri etiketlemek.
25.4.3 Etiketleme
Daha önce gösterdiğimiz histogram fonksiyonunu hatırlıyor musunuz?
histogram <- function(df, var, binwidth = NULL) {
  df |>
    ggplot(aes(x = {{ var }})) +
    geom_histogram(binwidth = binwidth)
}
Çıktıyı kullanılan değişken ve aralık genişliğiyle etiketleyebilsek güzel olmaz mıydı? Bunu yapmak için tidy evaluation’ın perde arkasına bakmamız ve henüz ele almadığımız rlang paketindeki bir fonksiyonu kullanmamız gerekecek. rlang, tidy evaluation’ı (ve birçok başka kullanışlı aracı) gerçekleştirdiği için tidyverse’teki neredeyse tüm diğer paketlerin kullandığı düşük düzeyli bir pakettir.
Etiketleme sorununu çözmek için rlang::englue() kullanabiliriz. Bu fonksiyon str_glue() fonksiyonuna benzer biçimde çalışır; dolayısıyla { } içine alınan her değer karakter dizisine eklenir. Ancak uygun değişken adını otomatik olarak ekleyen {{ }} işaretini de anlar:
histogram <- function(df, var, binwidth) {
  label <- rlang::englue("{{var}} değişkeninin {binwidth} aralık genişlikli histogramı")

  df |>
    ggplot(aes(x = {{ var }})) +
    geom_histogram(binwidth = binwidth) +
    labs(title = label)
}

diamonds |> histogram(carat, 0.1)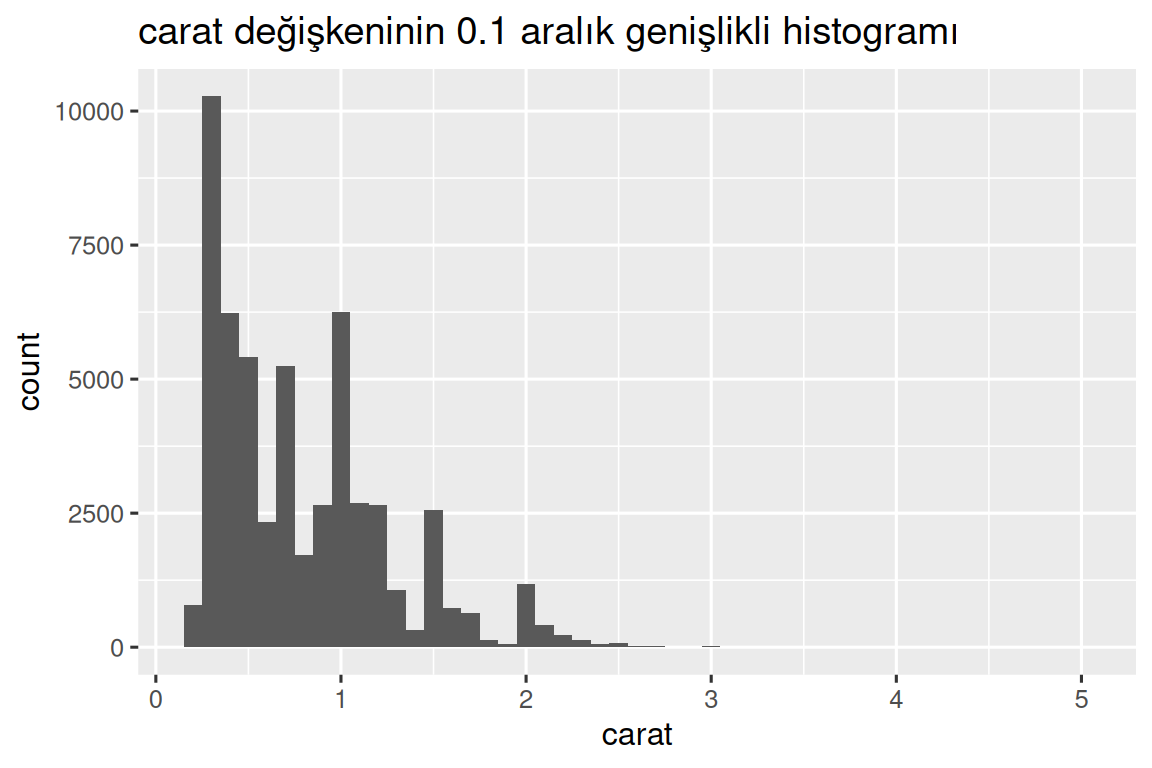
Bir ggplot2 grafiğine karakter dizisi sağlamak istediğiniz diğer her yerde aynı yaklaşımı kullanabilirsiniz.
25.4.4 Alıştırmalar
Aşağıdaki adımların her birini aşamalı olarak gerçekleştirerek zengin bir grafik fonksiyonu oluşturun:
Verilen veri kümesiyle
xveydeğişkenlerinden bir dağılım grafiği çizin.En iyi uyum doğrusunu (yani standart hataları olmayan doğrusal bir modeli) ekleyin.
Bir başlık ekleyin.
25.5 Stil
R, fonksiyonunuzun ya da argümanlarınızın adlarıyla ilgilenmez; ancak adlar insanlar için büyük fark yaratır. İdeal olarak fonksiyonunuzun adı kısa olmalı, ancak fonksiyonun ne yaptığını açıkça çağrıştırmalıdır. Bu zordur! Yine de RStudio’nun otomatik tamamlama özelliği uzun adları yazmayı kolaylaştırdığından açıklık kısalıktan daha önemlidir.
Genellikle fonksiyon adları fiil, argümanlar ise isim olmalıdır. Bazı istisnalar vardır: Fonksiyon çok iyi bilinen bir kavramı hesaplıyorsa (mean() fonksiyonu compute_mean() fonksiyonundan iyidir) veya bir nesnenin özelliğine erişiyorsa (coef() fonksiyonu get_coefficients() fonksiyonundan iyidir) isim kullanılabilir. En iyi yargınızı kullanın ve daha sonra daha iyi bir ad bulursanız fonksiyonu yeniden adlandırmaktan çekinmeyin.
# Çok kısa
f()

# Fiil değil ve açıklayıcı değil
my_awesome_function()

# Uzun ama açık
impute_missing()
collapse_years()
R, fonksiyonlarınızda boşlukları nasıl kullandığınızla da ilgilenmez; ancak gelecekteki okurlar ilgilenir. Bölüm 4 bölümündeki kuralları izlemeyi sürdürün. Ayrıca function() ifadesinin ardından her zaman süslü parantezler ({}) gelmeli ve içerik iki boşluk daha içeriden yazılmalıdır. Bu, sol kenara göz gezdirerek kodunuzdaki hiyerarşiyi görmeyi kolaylaştırır.
# İki ek boşluk eksik
density <- function(color, facets, binwidth = 0.1) {
diamonds |>
  ggplot(aes(x = carat, y = after_stat(density), color = {{ color }})) +
  geom_freqpoly(binwidth = binwidth) +
  facet_wrap(vars({{ facets }}))
}

# Pipe operatörü yanlış girintilenmiş
density <- function(color, facets, binwidth = 0.1) {
  diamonds |>
  ggplot(aes(x = carat, y = after_stat(density), color = {{ color }})) +
  geom_freqpoly(binwidth = binwidth) +
  facet_wrap(vars({{ facets }}))
}
Gördüğünüz gibi {{ }} içinde ek boşluklar kullanmanızı öneriyoruz. Bu, olağandışı bir şey olduğunu çok belirgin hâle getirir.
25.5.1 Alıştırmalar
-
Aşağıdaki iki fonksiyonun kaynak kodunu okuyun, ne yaptıklarını çözün ve daha iyi adlar üzerine düşünün.
f1 <- function(string, prefix) {
  str_sub(string, 1, str_length(prefix)) == prefix
}

f3 <- function(x, y) {
  rep(y, length.out = length(x))
}
Yakın zamanda yazdığınız bir fonksiyonu alın ve fonksiyonla argümanları için daha iyi adlar düşünmeye 5 dakika ayırın.
norm_r(),norm_d()vb. adların nedenrnorm(),dnorm()adlarından daha iyi olabileceğini savunun. Tersini de savunun. Adları nasıl daha açık hâle getirebilirsiniz?
25.6 Özet
Bu bölümde üç kullanışlı durum için fonksiyon yazmayı öğrendiniz: vektör, veri çerçevesi veya grafik oluşturmak. Bu süreçte yaratıcılığınızı harekete geçirdiğini ve fonksiyonların çözümleme kodunuza nerelerde yardımcı olabileceğine ilişkin fikirler verdiğini umduğumuz birçok örnek gördünüz.
Fonksiyonlara başlamak için yalnızca gereken en temel bilgileri gösterdik; öğrenecek çok daha fazlası var. Daha fazla bilgi edinebileceğiniz birkaç kaynak şunlardır:
- Tidy evaluation ile programlama hakkında daha fazla bilgi edinmek için dplyr ile programlama ve tidyr ile programlama sayfalarındaki kullanışlı tariflere bakın; kuramı Veri maskeleme nedir ve neden {{ kullanmalıyım? sayfasından öğrenin.
- ggplot2 kodunuzdaki yinelemeyi azaltma hakkında daha fazla bilgi edinmek için ggplot2 kitabının Programming with ggplot2 bölümünü okuyun.
- Fonksiyon stili hakkında daha fazla öneri için tidyverse stil kılavuzuna bakın.
Sonraki bölümde kod yinelemesini azaltmak için ek araçlar sunan iterasyon konusuna gireceğiz.