5 Veri düzenleme
5.1 Giriş
“Bütün mutlu aileler birbirine benzer, her mutsuz aile kendine özgü bir şekilde mutsuzdur.”
— Leo Tolstoy
“Düzenli veri kümeleri birbirine benzer, ama her dağınık veri kümesi kendine özgü bir şekilde dağınıktır.”
— Hadley Wickham
Bu bölümde R’daki verilerinizi düzenli veri (tidy data) adı verilen sisteme göre tutarlı biçimde düzenlemeyi öğreneceksiniz. Verilerinizi bu biçime getirmek başlangıçta biraz emek gerektirir; ancak bu emek uzun vadede karşılığını verir. Düzenli veriler ve tidyverse paketlerinin sunduğu düzenli araçlar sayesinde verileri bir gösterimden diğerine dönüştürmeye çok daha az, önemsediğiniz veri sorularına ise daha fazla zaman ayırabilirsiniz.
Önce düzenli verinin tanımını öğrenecek ve basit bir örnek veri kümesine nasıl uygulandığını göreceksiniz. Ardından verileri düzenlemekte kullanacağınız temel araç olan pivot işlemini ele alacağız. Pivot işlemi, değerleri değiştirmeden verilerinizin biçimini değiştirmenizi sağlar.
5.1.1 Ön koşullar
Bu bölümde dağınık veri kümelerini düzenlemeye yönelik pek çok araç sunan tidyr paketine odaklanacağız. tidyr, çekirdek tidyverse’in bir üyesidir.
Bu bölümden itibaren, library(tidyverse)’ün yükleme mesajını bastıracağız.
5.2 Düzenli veri
Aynı temel veriyi birden fazla şekilde temsil edebilirsiniz. Aşağıdaki örnek, aynı verinin üç farklı biçimde düzenlenmiş hâlini gösterir. Her veri kümesi aynı dört değişkenin değerlerini gösterir: country (ülke), year (yıl), population (nüfus) ve belgelenmiş TB (tüberküloz) cases (vaka) sayısı. Ancak her biri bu değerleri farklı biçimde düzenler.
table1
#> # A tibble: 6 × 4
#>   country      year  cases population
#>   <chr>       <dbl>  <dbl>      <dbl>
#> 1 Afghanistan  1999    745   19987071
#> 2 Afghanistan  2000   2666   20595360
#> 3 Brazil       1999  37737  172006362
#> 4 Brazil       2000  80488  174504898
#> 5 China        1999 212258 1272915272
#> 6 China        2000 213766 1280428583

table2
#> # A tibble: 12 × 4
#>   country      year type           count
#>   <chr>       <dbl> <chr>          <dbl>
#> 1 Afghanistan  1999 cases            745
#> 2 Afghanistan  1999 population  19987071
#> 3 Afghanistan  2000 cases           2666
#> 4 Afghanistan  2000 population  20595360
#> 5 Brazil       1999 cases          37737
#> 6 Brazil       1999 population 172006362
#> # ℹ 6 more rows

table3
#> # A tibble: 6 × 3
#>   country      year rate
#>   <chr>       <dbl> <chr>
#> 1 Afghanistan  1999 745/19987071
#> 2 Afghanistan  2000 2666/20595360
#> 3 Brazil       1999 37737/172006362
#> 4 Brazil       2000 80488/174504898
#> 5 China        1999 212258/1272915272
#> 6 China        2000 213766/1280428583
Bunların hepsi aynı temel verinin gösterimleridir; ancak kullanım kolaylıkları aynı değildir. Bunlardan biri, table1, tidyverse içinde çalışması çok daha kolay olacaktır; çünkü düzenlidir (tidy).
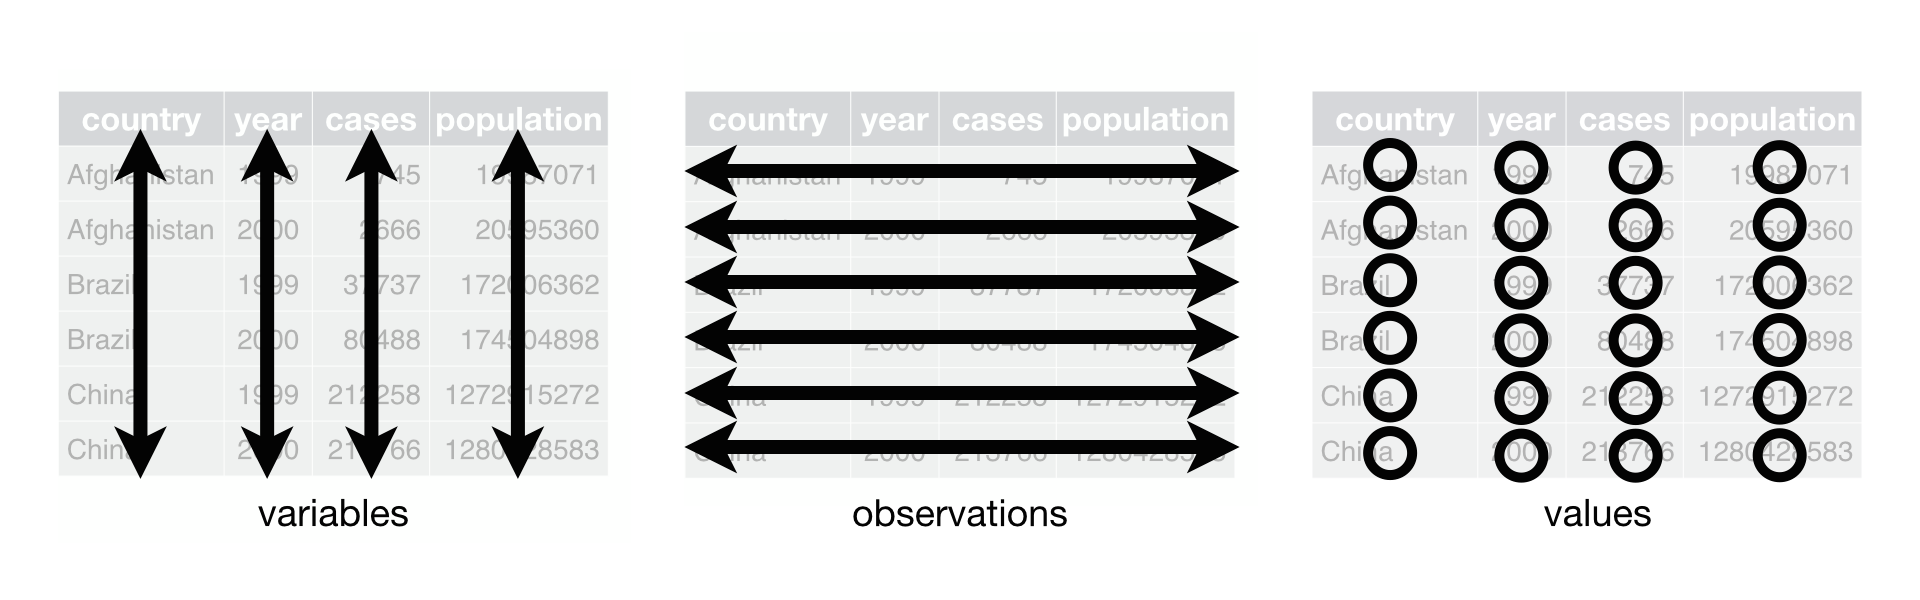
Bir veri kümesini düzenli yapan, birbiriyle ilişkili üç kural vardır:
- Her değişken bir sütundur; her sütun bir değişkendir.
- Her gözlem bir satırdır; her satır bir gözlemdir.
- Her değer bir hücredir; her hücre tek bir değerdir.
Şekil 5.1 bu kuralları görsel olarak gösterir.
Verinizin düzenli olmasını neden sağlamalısınız? İki temel avantajı vardır:
Veriyi saklamak için tutarlı bir yol seçmenin genel bir avantajı vardır. Tutarlı bir veri yapınız varsa onunla çalışan araçları öğrenmek daha kolaydır; çünkü bu araçlar ortak bir örüntüyü izler.
Değişkenleri sütunlara yerleştirmenin özel bir avantajı vardır; bu düzen, R’ın vektörleştirilmiş yapısından en iyi biçimde yararlanmayı sağlar. Bölüm 3.3.1 ve Bölüm 3.5.2 bölümlerinde öğrendiğiniz gibi, çoğu yerleşik R fonksiyonu değer vektörleriyle çalışır. Bu, düzenli veriyi dönüştürmeyi özellikle doğal hissettirir.
dplyr, ggplot2 ve tidyverse’deki diğer tüm paketler, düzenli veriyle çalışacak şekilde tasarlanmıştır. İşte table1 ile nasıl çalışabileceğinizi gösteren birkaç küçük örnek.
# 10.000 kişi başına oranı hesapla
table1 |>
  mutate(rate = cases / population * 10000)
#> # A tibble: 6 × 5
#>   country      year  cases population  rate
#>   <chr>       <dbl>  <dbl>      <dbl> <dbl>
#> 1 Afghanistan  1999    745   19987071 0.373
#> 2 Afghanistan  2000   2666   20595360 1.29
#> 3 Brazil       1999  37737  172006362 2.19
#> 4 Brazil       2000  80488  174504898 4.61
#> 5 China        1999 212258 1272915272 1.67
#> 6 China        2000 213766 1280428583 1.67

# Yıl başına toplam vaka sayısını hesapla
table1 |>
  group_by(year) |>
  summarize(total_cases = sum(cases))
#> # A tibble: 2 × 2
#>    year total_cases
#>   <dbl>       <dbl>
#> 1  1999      250740
#> 2  2000      296920

# Zaman içindeki değişimi görselleştir
ggplot(table1, aes(x = year, y = cases)) +
  geom_line(aes(group = country), color = "grey50") +
  geom_point(aes(color = country, shape = country)) +
  scale_x_continuous(breaks = c(1999, 2000)) # x ekseni işaretleri 1999 ve 2000'de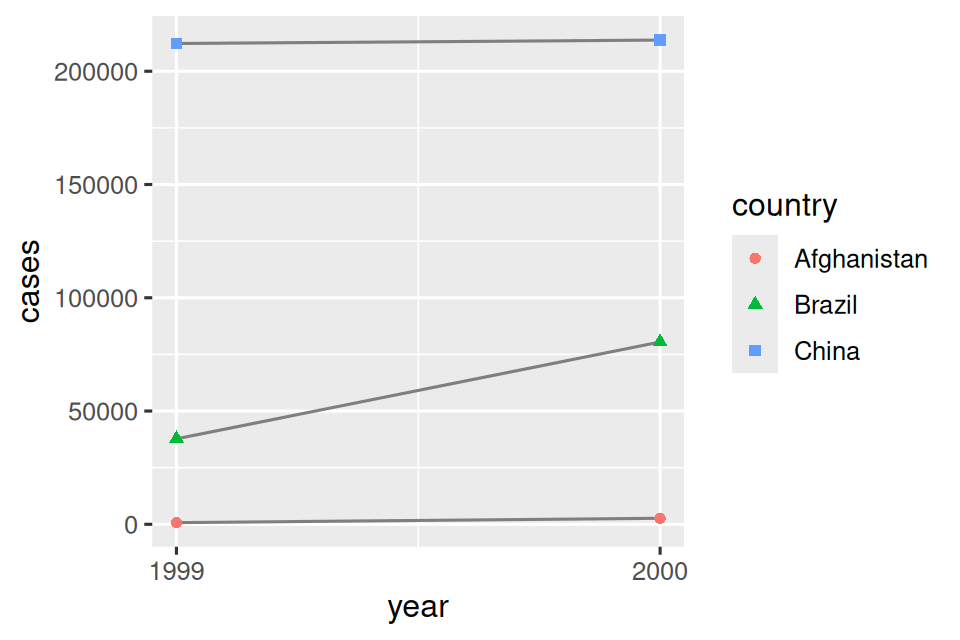
5.2.1 Alıştırmalar
Örnek tablolardan her biri için, her gözlemin ve her sütunun neyi temsil ettiğini açıklayın.
-
table2vetable3içinrate’i hesaplamak amacıyla kullanacağınız süreci taslak olarak çizin. Dört işlem gerçekleştirmeniz gerekecek:- Ülke başına, yıl başına TB vaka sayısını çıkarın.
- Ülke başına, yıl başına karşılık gelen nüfusu çıkarın.
- Vaka sayısını nüfusa bölün ve 10.000 ile çarpın.
- Uygun yere geri saklayın.
Bu işlemleri gerçekten gerçekleştirmek için ihtiyaç duyacağınız fonksiyonların hepsini henüz öğrenmediniz; ama yine de ihtiyaç duyacağınız dönüşümleri düşünebilmelisiniz.
5.3 Veriyi uzatma
Düzenli veri ilkeleri o kadar açık görünebilir ki düzenli olmayan bir veri kümesiyle karşılaşıp karşılaşmayacağınızı merak edebilirsiniz. Ne yazık ki gerçek verilerin çoğu düzenli değildir. Bunun iki temel nedeni vardır:
Veriler genellikle analiz dışındaki bir amacı kolaylaştıracak biçimde düzenlenir. Örneğin verilerin, analizi değil veri girişini kolaylaştıracak biçimde yapılandırılması yaygındır.
Çoğu insan düzenli veri ilkelerine aşina değildir ve veriyle çalışarak çok fazla zaman geçirmediğiniz sürece bunları kendi kendinize türetmek zordur.
Bu, gerçek analizlerin çoğunun en azından biraz düzenleme gerektireceği anlamına gelir. İşe, temeldeki değişkenlerin ve gözlemlerin ne olduğunu anlayarak başlayacaksınız. Bazen bu kolaydır; diğer zamanlarda veriyi ilk oluşturan kişilere danışmanız gerekecektir. Ardından verilerinizi, değişkenlerin sütunlarda ve gözlemlerin satırlarda bulunduğu düzenli bir biçime pivotlayacaksınız.
tidyr, veriyi pivotlamak için iki fonksiyon sağlar: pivot_longer() ve pivot_wider(). En yaygın durum olduğu için önce pivot_longer() ile başlayacağız. Birkaç örneğe dalalım.
5.3.1 Sütun adlarındaki veriler
billboard veri kümesi, şarkıların 2000 yılındaki Billboard sıralamalarını içerir:
billboard
#> # A tibble: 317 × 79
#>   artist       track               date.entered   wk1   wk2   wk3   wk4   wk5
#>   <chr>        <chr>               <date>       <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1 2 Pac        Baby Don't Cry (Ke… 2000-02-26      87    82    72    77    87
#> 2 2Ge+her      The Hardest Part O… 2000-09-02      91    87    92    NA    NA
#> 3 3 Doors Down Kryptonite          2000-04-08      81    70    68    67    66
#> 4 3 Doors Down Loser               2000-10-21      76    76    72    69    67
#> 5 504 Boyz     Wobble Wobble       2000-04-15      57    34    25    17    17
#> 6 98^0         Give Me Just One N… 2000-08-19      51    39    34    26    26
#> # ℹ 311 more rows
#> # ℹ 71 more variables: wk6 <dbl>, wk7 <dbl>, wk8 <dbl>, wk9 <dbl>, …
Bu veri kümesinde, her gözlem bir şarkıdır. İlk üç sütun (artist, track ve date.entered) şarkıyı tanımlayan değişkenlerdir. Ardından, şarkının her haftaki sıralamasını tanımlayan 76 sütunumuz (wk1-wk76) var1. Burada, sütun adları bir değişken (week), hücre değerleri ise bir başka değişkendir (rank).
Bu veriyi düzenlemek için pivot_longer()’ı kullanacağız:
billboard |>
  pivot_longer(
    cols = starts_with("wk"),
    names_to = "week",
    values_to = "rank"
  )
#> # A tibble: 24,092 × 5
#>    artist track                   date.entered week   rank
#>    <chr>  <chr>                   <date>       <chr> <dbl>
#>  1 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk1      87
#>  2 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk2      82
#>  3 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk3      72
#>  4 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk4      77
#>  5 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk5      87
#>  6 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk6      94
#>  7 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk7      99
#>  8 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk8      NA
#>  9 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk9      NA
#> 10 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk10     NA
#> # ℹ 24,082 more rows
Veriden sonra, üç temel argüman vardır:
-
cols, hangi sütunların pivotlanması gerektiğini, yani hangi sütunların değişken olmadığını belirtir. Bu argümanselect()ile aynı sözdizimini kullanır, bu yüzden burada!c(artist, track, date.entered)veyastarts_with("wk")kullanabiliriz. -
names_to, sütun adlarında saklanan değişkeni adlandırır; biz bu değişkeniweekolarak adlandırdık. -
values_to, hücre değerlerinde saklanan değişkeni adlandırır; biz bu değişkenirankolarak adlandırdık.
Koddaki "week" ve "rank"’ın tırnak içinde olduğuna dikkat edin; çünkü bunlar oluşturduğumuz yeni değişkenlerdir, pivot_longer() çağrısını çalıştırdığımızda henüz veride mevcut değildirler.
Şimdi dikkatimizi ortaya çıkan, daha uzun veri çerçevesine çevirelim. Bir şarkı 76 haftadan daha az bir süre ilk 100’de kalırsa ne olur? Örneğin 2 Pac’in “Baby Don’t Cry” şarkısını ele alalım. Yukarıdaki çıktı, şarkının yalnızca 7 hafta boyunca ilk 100’de olduğunu ve kalan tüm haftaların eksik değerlerle doldurulduğunu gösteriyor. Bu NA’lar aslında bilinmeyen gözlemleri temsil etmez; veri kümesinin yapısı tarafından var olmaya zorlanmışlardır2, bu yüzden values_drop_na = TRUE ayarlayarak pivot_longer()’dan onlardan kurtulmasını isteyebiliriz:
billboard |>
  pivot_longer(
    cols = starts_with("wk"),
    names_to = "week",
    values_to = "rank",
    values_drop_na = TRUE
  )
#> # A tibble: 5,307 × 5
#>   artist track                   date.entered week   rank
#>   <chr>  <chr>                   <date>       <chr> <dbl>
#> 1 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk1      87
#> 2 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk2      82
#> 3 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk3      72
#> 4 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk4      77
#> 5 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk5      87
#> 6 2 Pac  Baby Don't Cry (Keep... 2000-02-26   wk6      94
#> # ℹ 5,301 more rows
Satır sayısı artık çok daha azdır; bu da NA içeren pek çok satırın atıldığını gösterir.
Bir şarkı 76 haftadan daha uzun süre ilk 100’de kalırsa ne olacağını da merak edebilirsiniz. Bu veriden anlayamayız; ama veri kümesine wk77, wk78, … gibi ek sütunlar eklenebileceğini tahmin edebilirsiniz.
Bu veri artık düzenli; ama mutate() ve readr::parse_number() kullanarak week’in değerlerini karakter dizilerinden sayılara dönüştürerek gelecekteki hesaplamaları biraz kolaylaştırabiliriz. parse_number(), diğer tüm metni yok sayarak bir karakter dizisinden ilk sayıyı çıkaran kullanışlı bir fonksiyondur.
billboard_longer <- billboard |>
  pivot_longer(
    cols = starts_with("wk"),
    names_to = "week",
    values_to = "rank",
    values_drop_na = TRUE
  ) |>
  mutate(
    week = parse_number(week)
  )
billboard_longer
#> # A tibble: 5,307 × 5
#>   artist track                   date.entered  week  rank
#>   <chr>  <chr>                   <date>       <dbl> <dbl>
#> 1 2 Pac  Baby Don't Cry (Keep... 2000-02-26       1    87
#> 2 2 Pac  Baby Don't Cry (Keep... 2000-02-26       2    82
#> 3 2 Pac  Baby Don't Cry (Keep... 2000-02-26       3    72
#> 4 2 Pac  Baby Don't Cry (Keep... 2000-02-26       4    77
#> 5 2 Pac  Baby Don't Cry (Keep... 2000-02-26       5    87
#> 6 2 Pac  Baby Don't Cry (Keep... 2000-02-26       6    94
#> # ℹ 5,301 more rows
Artık tüm hafta numaralarını bir değişkende ve tüm sıralama değerlerini başka bir değişkende topladığımıza göre, şarkı sıralamalarının zaman içinde nasıl değiştiğini görselleştirmek için iyi bir konumdayız. Kod aşağıda gösterilmiştir ve sonuç Şekil 5.2’te yer almaktadır. Çok az sayıda şarkının 20 haftadan fazla ilk 100’de kaldığını görebiliriz.
billboard_longer |>
  ggplot(aes(x = week, y = rank, group = track)) +
  geom_line(alpha = 0.25) +
  scale_y_reverse()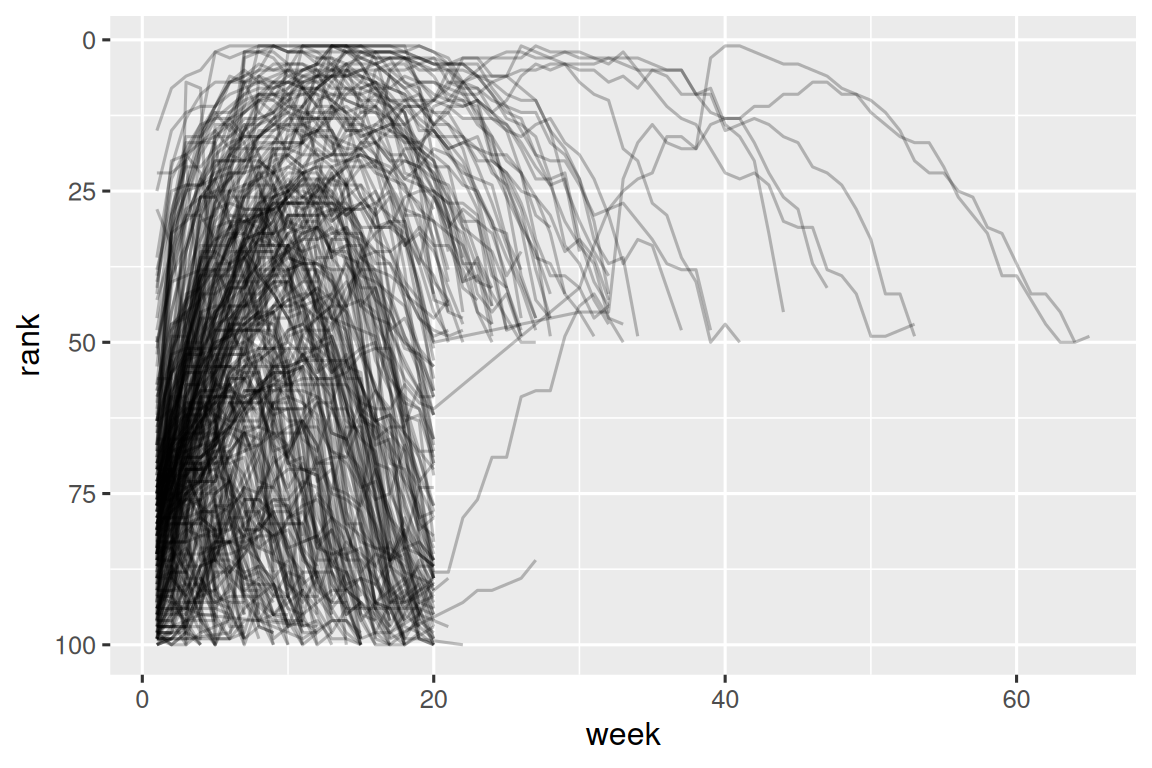
5.3.2 Pivot işlemi nasıl çalışır?
Verilerimizi yeniden biçimlendirmek için pivot işlemini nasıl kullanabileceğimizi gördük. Şimdi bu işlemin verilere ne yaptığını sezgisel olarak anlamaya çalışalım. Neler olduğunu görmeyi kolaylaştırmak için çok basit bir veri kümesiyle başlayalım. id’leri A, B ve C olan üç hastamız olduğunu ve her hastadan iki kan basıncı ölçümü aldığımızı varsayalım. Verileri, küçük tibble’ları elle oluşturmayı kolaylaştıran tribble() fonksiyonuyla oluşturacağız:
df <- tribble(
  ~id,  ~bp1, ~bp2,
   "A",  100,  120,
   "B",  140,  115,
   "C",  120,  125
)
Yeni veri kümemizin üç değişkene sahip olmasını istiyoruz: id (zaten mevcut), measurement (sütun adları) ve value (hücre değerleri). Bunu başarmak için df’yi daha uzun biçime pivotlamamız gerekir:
df |>
  pivot_longer(
    cols = bp1:bp2,
    names_to = "measurement",
    values_to = "value"
  )
#> # A tibble: 6 × 3
#>   id    measurement value
#>   <chr> <chr>       <dbl>
#> 1 A     bp1           100
#> 2 A     bp2           120
#> 3 B     bp1           140
#> 4 B     bp2           115
#> 5 C     bp1           120
#> 6 C     bp2           125
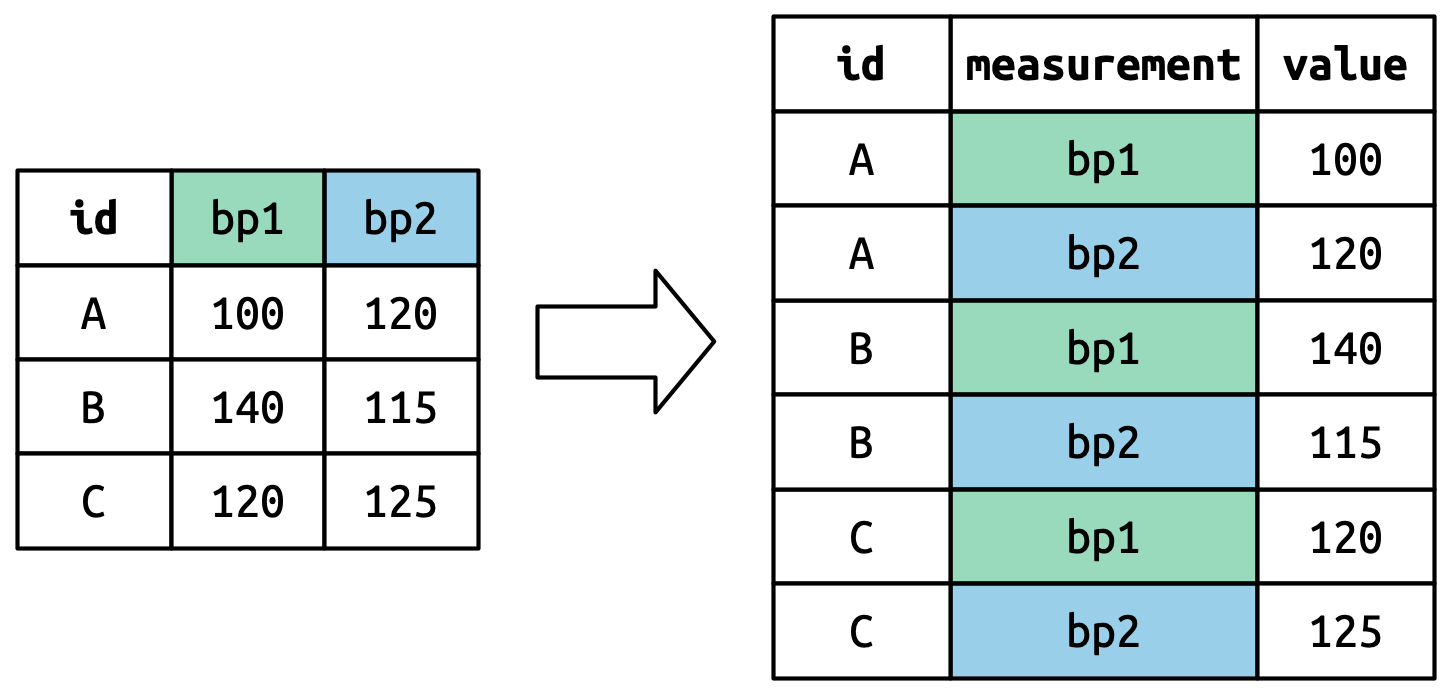
Yeniden şekillendirme nasıl çalışır? Sütun sütun düşünürsek görmek daha kolaydır. Şekil 5.3’te gösterildiği gibi, orijinal veri kümesinde zaten bir değişken olan bir sütundaki (id) değerlerin, pivotlanan her sütun için bir kez tekrarlanması gerekir.
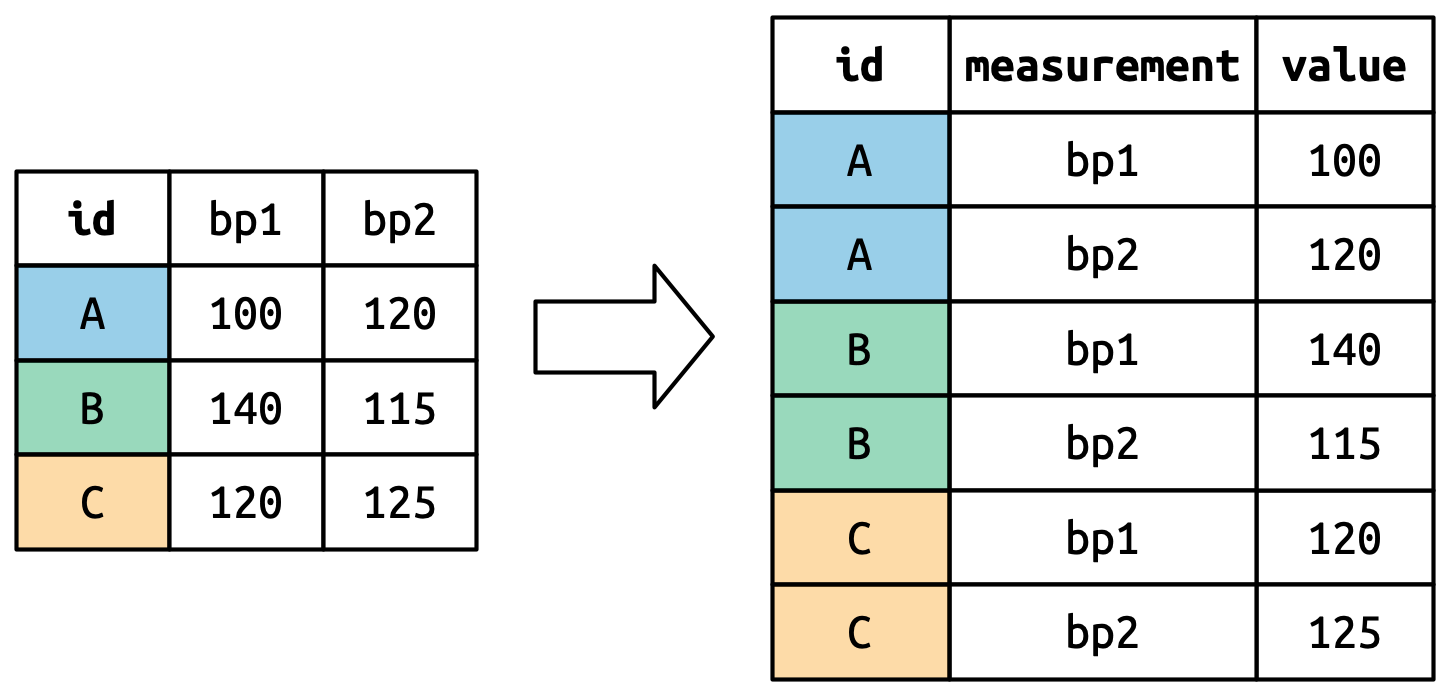
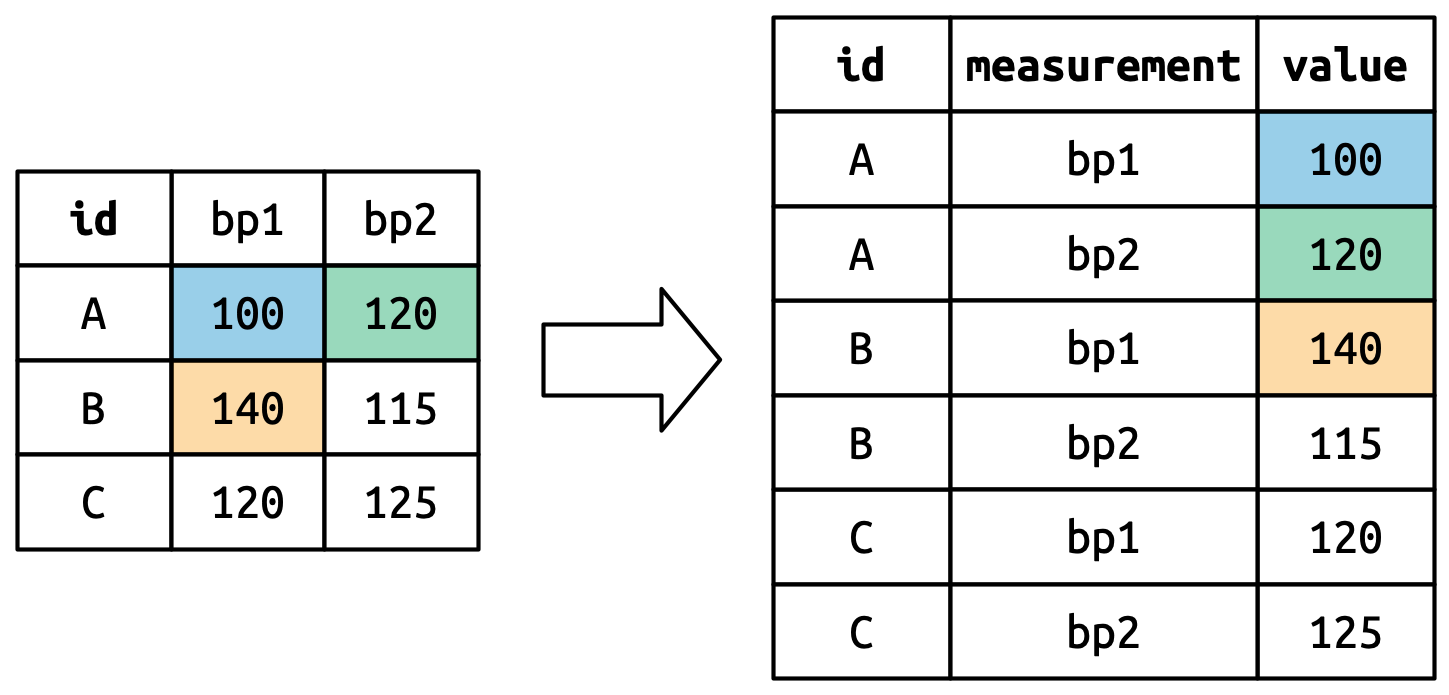
Şekil 5.4’te gösterildiği gibi, sütun adları, adı names_to tarafından tanımlanan yeni bir değişkendeki değerler haline gelir. Bunların, orijinal veri kümesindeki her satır için bir kez tekrarlanması gerekir.
Hücre değerleri de adı values_to tarafından belirlenen yeni bir değişkenin değerleri hâline gelir. Bu değerler satır sırasıyla açılır. Şekil 5.5 bu süreci gösterir.
5.3.3 Sütun adlarında birden fazla değişken
Sütun adlarına sıkıştırılmış birden fazla bilgi parçasını ayrı yeni değişkenlerde saklamak istediğinizde daha zorlu bir durumla karşılaşırsınız. Örneğin, yukarıda gördüğünüz table1 ve benzerlerinin kaynağı olan who2 veri kümesini ele alalım:
who2
#> # A tibble: 7,240 × 58
#>   country      year sp_m_014 sp_m_1524 sp_m_2534 sp_m_3544 sp_m_4554
#>   <chr>       <dbl>    <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#> 1 Afghanistan  1980       NA        NA        NA        NA        NA
#> 2 Afghanistan  1981       NA        NA        NA        NA        NA
#> 3 Afghanistan  1982       NA        NA        NA        NA        NA
#> 4 Afghanistan  1983       NA        NA        NA        NA        NA
#> 5 Afghanistan  1984       NA        NA        NA        NA        NA
#> 6 Afghanistan  1985       NA        NA        NA        NA        NA
#> # ℹ 7,234 more rows
#> # ℹ 51 more variables: sp_m_5564 <dbl>, sp_m_65 <dbl>, sp_f_014 <dbl>, …
Dünya Sağlık Örgütü tarafından toplanan bu veri kümesi, tüberküloz teşhisleri hakkında bilgi kaydeder. Zaten değişken olan ve yorumlanması kolay iki sütun vardır: country ve year. Bunları, sp_m_014, ep_m_4554 ve rel_m_3544 gibi 56 sütun izler. Bu sütunlara yeterince uzun bakarsanız, bir örüntü olduğunu fark edersiniz. Her sütun adı, _ ile ayrılmış üç parçadan oluşur. İlk parça, sp/rel/ep, teşhis için kullanılan yöntemi tanımlar; ikinci parça, m/f, gender’dır (bu veri kümesinde ikili bir değişken olarak kodlanmıştır); üçüncü parça, 014/1524/2534/3544/4554/5564/65, age aralığıdır (örneğin 014, 0-14’ü temsil eder).
Yani bu durumda, who2’de kaydedilmiş altı bilgi parçası vardır: ülke ve yıl (zaten sütun); teşhis yöntemi, cinsiyet kategorisi ve yaş aralığı kategorisi (diğer sütun adlarında bulunur); ve o kategorideki hasta sayısı (hücre değerleri). Bu altı bilgi parçasını altı ayrı sütunda düzenlemek için pivot_longer() kullanırız. names_to argümanına bir sütun adları vektörü, özgün değişken adlarını parçalara ayırmak için names_sep argümanına ayırıcı ve values_to argümanına da bir sütun adı veririz:
who2 |>
  pivot_longer(
    cols = !(country:year),
    names_to = c("diagnosis", "gender", "age"),
    names_sep = "_",
    values_to = "count"
  )
#> # A tibble: 405,440 × 6
#>   country      year diagnosis gender age   count
#>   <chr>       <dbl> <chr>     <chr>  <chr> <dbl>
#> 1 Afghanistan  1980 sp        m      014      NA
#> 2 Afghanistan  1980 sp        m      1524     NA
#> 3 Afghanistan  1980 sp        m      2534     NA
#> 4 Afghanistan  1980 sp        m      3544     NA
#> 5 Afghanistan  1980 sp        m      4554     NA
#> 6 Afghanistan  1980 sp        m      5564     NA
#> # ℹ 405,434 more rowsnames_sep’e bir alternatif, Bölüm 15 bölümünde düzenli ifadeler hakkında bilgi edindikten sonra daha karmaşık adlandırma senaryolarından değişken çıkarmak için kullanabileceğiniz names_pattern’dır.
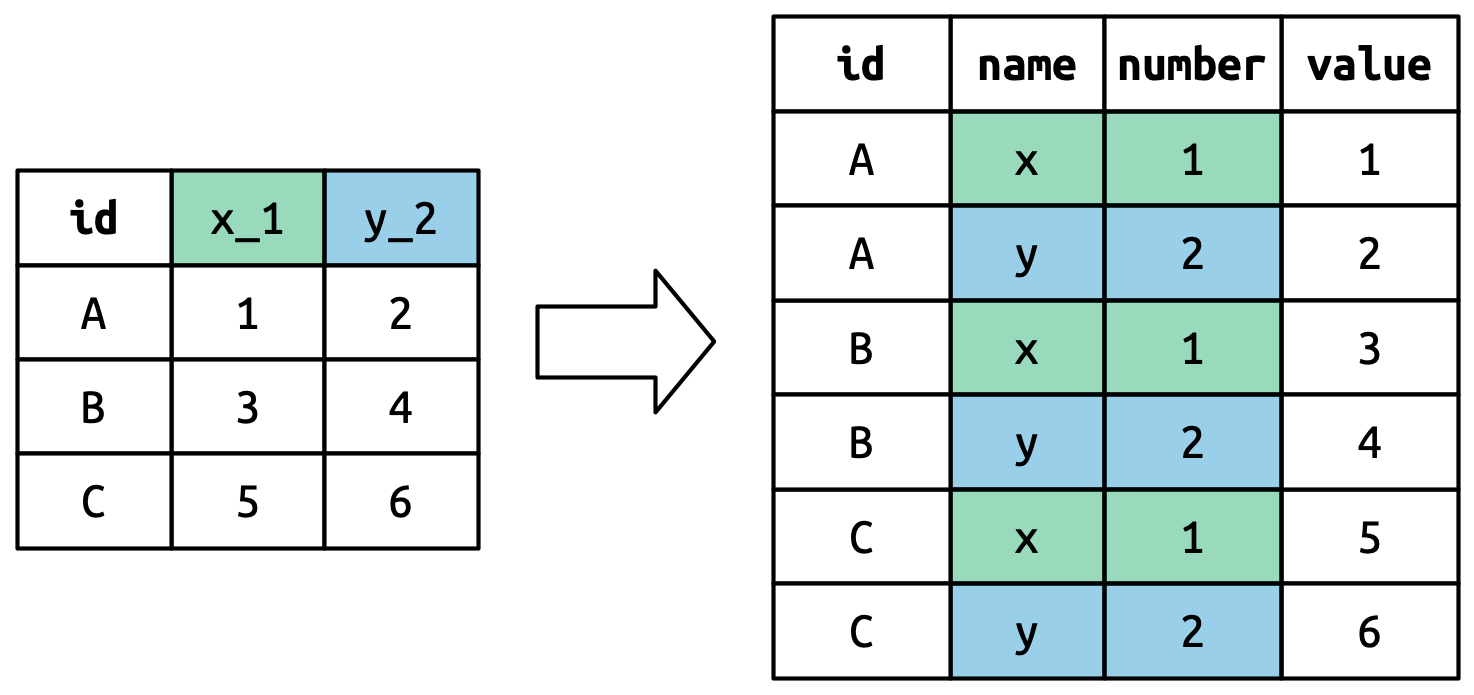
Kavramsal olarak, bu daha önce gördüğünüz daha basit durumun yalnızca küçük bir varyasyonudur. Şekil 5.6 temel fikri gösterir: şimdi sütun adları tek bir sütuna pivotlanmak yerine, birden fazla sütuna pivotlanır. Bunun iki adımda (önce pivotlama, sonra ayırma) gerçekleştiğini hayal edebilirsiniz; ama arka planda, daha hızlı olduğu için tek bir adımda gerçekleşir.
5.3.4 Sütun başlıklarında hem veri hem değişken adları
Karmaşıklıktaki bir sonraki adım, sütun adlarının değişken değerleri ile değişken adlarının bir karışımını içerdiği durumdur. Örneğin, household veri kümesini ele alalım:
household
#> # A tibble: 5 × 5
#>   family dob_child1 dob_child2 name_child1 name_child2
#>    <int> <date>     <date>     <chr>       <chr>
#> 1      1 1998-11-26 2000-01-29 Susan       Jose
#> 2      2 1996-06-22 NA         Mark        <NA>
#> 3      3 2002-07-11 2004-04-05 Sam         Seth
#> 4      4 2004-10-10 2009-08-27 Craig       Khai
#> 5      5 2000-12-05 2005-02-28 Parker      Gracie
Bu veri kümesi, en fazla iki çocuğun adları ve doğum tarihleriyle birlikte beş aile hakkında veri içerir. Bu veri kümesindeki yeni zorluk, sütun adlarının iki değişkenin adlarını (dob, name) ve bir başkasının değerlerini (child, 1 veya 2 değerleriyle) içermesidir. Bu sorunu çözmek için names_to argümanına yine bir vektör veririz; ancak bu kez özel ".value" değerini kullanırız. Bu, bir değişken adı değil, pivot_longer() fonksiyonuna farklı davranmasını söyleyen özel bir işarettir. Bu, pivotlanan sütun adının ilk bileşenini çıktıda bir değişken adı olarak kullanmak için olağan values_to argümanının üzerine yazar.
household |>
  pivot_longer(
    cols = !family,
    names_to = c(".value", "child"),
    names_sep = "_",
    values_drop_na = TRUE
  )
#> # A tibble: 9 × 4
#>   family child  dob        name
#>    <int> <chr>  <date>     <chr>
#> 1      1 child1 1998-11-26 Susan
#> 2      1 child2 2000-01-29 Jose
#> 3      2 child1 1996-06-22 Mark
#> 4      3 child1 2002-07-11 Sam
#> 5      3 child2 2004-04-05 Seth
#> 6      4 child1 2004-10-10 Craig
#> # ℹ 3 more rows
Girdinin biçimi açık eksik değerlerin oluşmasını zorunlu kıldığı için (örneğin yalnızca bir çocuğu olan ailelerde) yine values_drop_na = TRUE kullanırız.
Şekil 5.7 temel fikri daha basit bir örnekle gösterir. names_to içinde ".value" kullandığınızda, girdideki sütun adları çıktıda hem değerlere hem değişken adlarına katkıda bulunur.
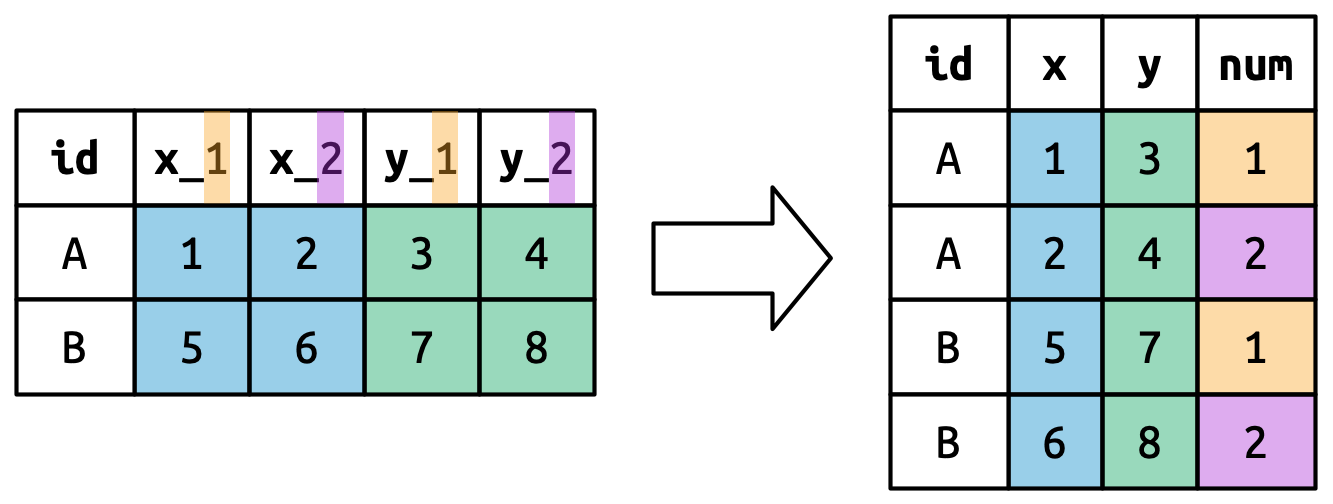
names_to = c(".value", "num") ile pivotlamak, sütun adlarını iki bileşene ayırır: ilk kısım çıktı sütun adını (x veya y) belirler, ikinci kısım ise num sütununun değerini belirler.
5.4 Veriyi genişletme
Şimdiye kadar, değerlerin sütun adlarında sona erdiği yaygın problem sınıfını çözmek için pivot_longer()’ı kullandık. Şimdi, sütun sayısını artırıp satır sayısını azaltarak veri kümelerini genişleten (wider) ve bir gözlem birden fazla satıra yayıldığında işe yarayan pivot_wider() yönünde pivot ediyoruz (HA HA). Bu durum gerçek yaşam verilerinde daha seyrek, kamu verilerinde ise oldukça sık karşımıza çıkar.
Hasta deneyimleri hakkında veri toplayan, Medicare ve Medicaid Hizmetleri Merkezleri’nden bir veri kümesi olan cms_patient_experience’a bakarak başlayacağız:
cms_patient_experience
#> # A tibble: 500 × 5
#>   org_pac_id org_nm                     measure_cd   measure_title   prf_rate
#>   <chr>      <chr>                      <chr>        <chr>              <dbl>
#> 1 0446157747 USC CARE MEDICAL GROUP INC CAHPS_GRP_1  CAHPS for MIPS…       63
#> 2 0446157747 USC CARE MEDICAL GROUP INC CAHPS_GRP_2  CAHPS for MIPS…       87
#> 3 0446157747 USC CARE MEDICAL GROUP INC CAHPS_GRP_3  CAHPS for MIPS…       86
#> 4 0446157747 USC CARE MEDICAL GROUP INC CAHPS_GRP_5  CAHPS for MIPS…       57
#> 5 0446157747 USC CARE MEDICAL GROUP INC CAHPS_GRP_8  CAHPS for MIPS…       85
#> 6 0446157747 USC CARE MEDICAL GROUP INC CAHPS_GRP_12 CAHPS for MIPS…       24
#> # ℹ 494 more rows
İncelenen temel birim bir kuruluştur; ancak her kuruluş altı satıra yayılmıştır ve ankette kuruluş için alınan her ölçüme bir satır düşer. distinct()’i kullanarak measure_cd ve measure_title için değerlerin tam kümesini görebiliriz:
cms_patient_experience |>
  distinct(measure_cd, measure_title)
#> # A tibble: 6 × 2
#>   measure_cd   measure_title
#>   <chr>        <chr>
#> 1 CAHPS_GRP_1  CAHPS for MIPS SSM: Getting Timely Care, Appointments, and In…
#> 2 CAHPS_GRP_2  CAHPS for MIPS SSM: How Well Providers Communicate
#> 3 CAHPS_GRP_3  CAHPS for MIPS SSM: Patient's Rating of Provider
#> 4 CAHPS_GRP_5  CAHPS for MIPS SSM: Health Promotion and Education
#> 5 CAHPS_GRP_8  CAHPS for MIPS SSM: Courteous and Helpful Office Staff
#> 6 CAHPS_GRP_12 CAHPS for MIPS SSM: Stewardship of Patient Resources
Bu sütunların ikisi de iyi bir değişken adı oluşturmaz: measure_cd değişkenin anlamına ilişkin ipucu vermez, measure_title ise boşluklar içeren uzun bir cümledir. Şimdilik yeni sütun adlarımız için kaynak olarak measure_cd’yi kullanacağız; ama gerçek bir analizde hem kısa hem anlamlı kendi değişken adlarınızı oluşturmak isteyebilirsiniz.
pivot_wider(), pivot_longer()’ın tersi bir arayüze sahiptir: yeni sütun adları seçmek yerine, değerleri (values_from) ve sütun adını (names_from) tanımlayan mevcut sütunları sağlamamız gerekir:
cms_patient_experience |>
  pivot_wider(
    names_from = measure_cd,
    values_from = prf_rate
  )
#> # A tibble: 500 × 9
#>   org_pac_id org_nm                   measure_title   CAHPS_GRP_1 CAHPS_GRP_2
#>   <chr>      <chr>                    <chr>                 <dbl>       <dbl>
#> 1 0446157747 USC CARE MEDICAL GROUP … CAHPS for MIPS…          63          NA
#> 2 0446157747 USC CARE MEDICAL GROUP … CAHPS for MIPS…          NA          87
#> 3 0446157747 USC CARE MEDICAL GROUP … CAHPS for MIPS…          NA          NA
#> 4 0446157747 USC CARE MEDICAL GROUP … CAHPS for MIPS…          NA          NA
#> 5 0446157747 USC CARE MEDICAL GROUP … CAHPS for MIPS…          NA          NA
#> 6 0446157747 USC CARE MEDICAL GROUP … CAHPS for MIPS…          NA          NA
#> # ℹ 494 more rows
#> # ℹ 4 more variables: CAHPS_GRP_3 <dbl>, CAHPS_GRP_5 <dbl>, …
Çıktı tam olarak doğru görünmüyor; hâlâ her kuruluş için birden fazla satır var gibi görünüyor. Bunun nedeni, pivot_wider()’a hangi sütunun veya sütunların her satırı benzersiz şekilde tanımlayan değerlere sahip olduğunu da söylememiz gerekmesidir; bu durumda bunlar "org" ile başlayan değişkenlerdir:
cms_patient_experience |>
  pivot_wider(
    id_cols = starts_with("org"),
    names_from = measure_cd,
    values_from = prf_rate
  )
#> # A tibble: 95 × 8
#>   org_pac_id org_nm           CAHPS_GRP_1 CAHPS_GRP_2 CAHPS_GRP_3 CAHPS_GRP_5
#>   <chr>      <chr>                  <dbl>       <dbl>       <dbl>       <dbl>
#> 1 0446157747 USC CARE MEDICA…          63          87          86          57
#> 2 0446162697 ASSOCIATION OF …          59          85          83          63
#> 3 0547164295 BEAVER MEDICAL …          49          NA          75          44
#> 4 0749333730 CAPE PHYSICIANS…          67          84          85          65
#> 5 0840104360 ALLIANCE PHYSIC…          66          87          87          64
#> 6 0840109864 REX HOSPITAL INC          73          87          84          67
#> # ℹ 89 more rows
#> # ℹ 2 more variables: CAHPS_GRP_8 <dbl>, CAHPS_GRP_12 <dbl>
Bu, aradığımız çıktıyı bize verir.
5.4.1 pivot_wider() nasıl çalışır?
pivot_wider()’ın nasıl çalıştığını anlamak için, yine çok basit bir veri kümesiyle başlayalım. Bu sefer id’leri A ve B olan iki hastamız var; hasta A üzerinde üç, hasta B üzerinde iki kan basıncı ölçümümüz var:
df <- tribble(
  ~id, ~measurement, ~value,
  "A",        "bp1",    100,
  "B",        "bp1",    140,
  "B",        "bp2",    115,
  "A",        "bp2",    120,
  "A",        "bp3",    105
)
Değerleri value sütunundan, adları ise measurement sütunundan alacağız:
df |>
  pivot_wider(
    names_from = measurement,
    values_from = value
  )
#> # A tibble: 2 × 4
#>   id      bp1   bp2   bp3
#>   <chr> <dbl> <dbl> <dbl>
#> 1 A       100   120   105
#> 2 B       140   115    NA
Süreci başlatmak için pivot_wider()’ın önce satırlara ve sütunlara ne gideceğini bulması gerekir. Yeni sütun adları, measurement’ın benzersiz değerleri olacaktır.
Varsayılan olarak, çıktıdaki satırlar, yeni adlara veya değerlere gitmeyen tüm değişkenler tarafından belirlenir. Bunlara id_cols denir. Burada yalnızca bir sütun var; ama genel olarak herhangi bir sayıda olabilir.
pivot_wider() daha sonra boş bir veri çerçevesi oluşturmak için bu sonuçları birleştirir:
Ardından, girdideki veriyi kullanarak tüm eksik değerleri doldurur. Bu durumda, hasta B için üçüncü bir kan basıncı ölçümü olmadığından, çıktıdaki her hücrenin girdide karşılık gelen bir değeri yoktur, bu yüzden o hücre eksik kalır. pivot_wider()’ın eksik değerler “yaratabileceği” bu fikre Bölüm 18 bölümünde geri döneceğiz.
Girdide, çıktıdaki bir hücreye karşılık gelen birden fazla satır varsa ne olacağını da merak edebilirsiniz. Aşağıdaki örnekte, id “A” ve measurement “bp1”e karşılık gelen iki satır vardır:
df <- tribble(
  ~id, ~measurement, ~value,
  "A",        "bp1",    100,
  "A",        "bp1",    102,
  "A",        "bp2",    120,
  "B",        "bp1",    140,
  "B",        "bp2",    115
)
Bunu pivotlamaya çalışırsak, Bölüm 23 bölümünde daha fazla bilgi edineceğiniz liste sütunları (list-columns) içeren bir çıktı elde ederiz:
df |>
  pivot_wider(
    names_from = measurement,
    values_from = value
  )
#> Warning: Values from `value` are not uniquely identified; output will contain
#> list-cols.
#> • Use `values_fn = list` to suppress this warning.
#> • Use `values_fn = {summary_fun}` to summarise duplicates.
#> • Use the following dplyr code to identify duplicates.
#>   {data} |>
#>   dplyr::summarise(n = dplyr::n(), .by = c(id, measurement)) |>
#>   dplyr::filter(n > 1L)
#> # A tibble: 2 × 3
#>   id    bp1       bp2
#>   <chr> <list>    <list>
#> 1 A     <dbl [2]> <dbl [1]>
#> 2 B     <dbl [1]> <dbl [1]>
Bu tür verilerle nasıl çalışılacağını henüz bilmediğinizden, sorunun nerede olduğunu anlamak için uyarıdaki ipucunu takip etmek isteyeceksiniz:
Ardından verilerinizde neyin yanlış gittiğini bulmak ve temel sorunu düzeltmek ya da her satır-sütun değeri birleşiminin yalnızca bir satıra karşılık gelmesini sağlamak için gruplama ve özetleme becerilerinizi kullanmanız gerekir.
5.5 Özet
Bu bölümde düzenli veri hakkında bilgi edindiniz: değişkenleri sütunlarda, gözlemleri satırlarda olan veri. Düzenli veri, tidyverse’de çalışmayı kolaylaştırır; çünkü çoğu fonksiyon tarafından anlaşılan tutarlı bir yapıdır; ana zorluk, veriyi hangi yapıda alırsanız alın, onu düzenli bir biçime dönüştürmektir. Bu amaçla, size pek çok düzensiz veri kümesini düzenlemenizi sağlayan pivot_longer() ve pivot_wider() hakkında bilgi edindiniz. Burada sunduğumuz örnekler vignette("pivot", package = "tidyr") belgesinden seçilmiştir. Bu bölümün çözemediği bir sorunla karşılaşırsanız söz konusu vinyet, bakmanız gereken iyi bir sonraki kaynaktır.
Bir başka zorluk da belirli bir veri kümesinin uzun veya geniş sürümünden hangisinin “düzenli” olduğunu belirlemenin bazen olanaksız olmasıdır. Bu, kısmen düzenli verinin tanımımızın bir yansımasıdır; düzenli verinin her sütunda bir değişkene sahip olduğunu söyledik, ama bir değişkenin ne olduğunu gerçekte tanımlamadık (ve bunu yapmak şaşırtıcı derecede zordur). Pragmatik davranıp değişkeni, analizinizi en kolay hâle getiren şey olarak tanımlamakta hiçbir sakınca yoktur. Dolayısıyla bir hesaplamayı nasıl yapacağınızı bulamıyorsanız verilerinizin düzenini değiştirmeyi düşünün; gerektiğinde verileri düzensizleştirmekten, dönüştürmekten ve yeniden düzenlemekten çekinmeyin!
Bu bölümden keyif aldıysanız ve altta yatan teori hakkında daha fazla bilgi edinmek istiyorsanız, Journal of Statistical Software’de yayınlanan Tidy Data makalesinde tarih ve teorik temeller hakkında daha fazla bilgi edinebilirsiniz.
Artık önemli miktarda R kodu yazdığınıza göre kodunuzu dosya ve dizinlerde düzenleme konusunda daha fazla bilgi edinme zamanı geldi. Bir sonraki bölümde scriptlerin ve projelerin avantajlarını, ayrıca yaşamınızı kolaylaştıran araçlarından bazılarını öğreneceksiniz.