18 Eksik değerler
18.1 Giriş
Kitabın önceki bölümlerinde eksik değerlerin temellerini öğrendiniz. Onlarla ilk olarak grafik oluştururken uyarıya yol açtıkları Bölüm 1 bölümünde ve özet istatistiklerin hesaplanmasını engelledikleri Bölüm 3.5.2 bölümünde karşılaştınız; bulaşıcı yapılarını ve varlıklarını nasıl denetleyeceğinizi ise Bölüm 12.2.2 bölümünde öğrendiniz. Şimdi ayrıntıları öğrenmek için eksik değerleri daha derinlemesine ele alacağız.
NA olarak kaydedilmiş eksik değerlerle çalışmaya yönelik bazı genel araçları ele alarak başlayacağız. Ardından verilerinizde hiç bulunmayan örtük eksik değerleri inceleyecek ve bunları açık hâle getirmek için kullanabileceğiniz bazı araçları göstereceğiz. Verilerde görünmeyen faktör düzeylerinin yol açtığı boş grupları ele alarak bitireceğiz.
18.1.1 Ön koşullar
Eksik verilerle çalışmaya yönelik fonksiyonların çoğu tidyverse’in temel üyeleri olan dplyr ve tidyr’dan gelir.
18.2 Açık eksik değerler
Başlangıç olarak açık eksik değerleri, yani NA gördüğünüz hücreleri oluşturmak veya ortadan kaldırmak için birkaç kullanışlı aracı inceleyelim.
18.2.1 Son gözlemi ileri taşıma
Eksik değerler çoğu zaman veri girişini kolaylaştırmak için kullanılır. Veriler elle girildiğinde eksik değerler bazen önceki satırdaki değerin yinelendiğini (ya da ileri taşındığını) belirtir:
treatment <- tribble(
  ~person,           ~treatment, ~response,
  "Derrick Whitmore", 1,         7,
  NA,                 2,         10,
  NA,                 3,         NA,
  "Katherine Burke",  1,         4
)
Bu eksik değerleri tidyr::fill() ile doldurabilirsiniz. Bir sütun kümesi alarak select() gibi çalışır:
treatment |>
  fill(everything())
#> # A tibble: 4 × 3
#>   person           treatment response
#>   <chr>                <dbl>    <dbl>
#> 1 Derrick Whitmore         1        7
#> 2 Derrick Whitmore         2       10
#> 3 Derrick Whitmore         3       10
#> 4 Katherine Burke          1        4
Bu işleme bazen “son gözlemi ileri taşıma” ya da kısaca locf denir. Daha sıra dışı yollarla oluşmuş eksik değerleri doldurmak için .direction argümanını kullanabilirsiniz.
18.2.2 Sabit değerler
Bazen eksik değerler sabit ve bilinen bir değeri, çoğunlukla 0’ı temsil eder. Bunları değiştirmek için dplyr::coalesce() kullanabilirsiniz:
Bazen de bunun tersiyle, belirli bir değerin gerçekte eksik değeri temsil ettiği sorunla karşılaşırsınız. Bu durum genellikle eksik değerleri doğru biçimde temsil edemeyen eski yazılımların ürettiği verilerde görülür; bu yazılımlar bunun yerine 99 veya -999 gibi özel bir değer kullanmak zorundadır.
Mümkünse bu durumu verileri okurken ele alın; örneğin readr::read_csv() fonksiyonunun na argümanını kullanın: read_csv(path, na = "99"). Sorunu daha sonra fark ederseniz ya da veri kaynağınız okuma sırasında ele alma olanağı sunmuyorsa dplyr::na_if() kullanabilirsiniz:
18.2.3 NaN
Devam etmeden önce zaman zaman karşılaşacağınız özel bir eksik değer türü vardır: NaN (“nan” diye okunur), yani sayı değil. Genellikle NA gibi davrandığından hakkında çok şey bilmeniz gerekmez:
Nadiren de olsa NA ile NaN değerini ayırt etmeniz gerekirse is.nan(x) kullanabilirsiniz.
Genellikle sonucu belirsiz bir matematiksel işlem yaptığınızda NaN ile karşılaşırsınız:
0 / 0
#> [1] NaN
0 * Inf
#> [1] NaN
Inf - Inf
#> [1] NaN
sqrt(-1)
#> Warning in sqrt(-1): NaNs produced
#> [1] NaN
18.3 Örtük eksik değerler
Şimdiye kadar açıkça eksik olan, yani verilerinizde NA olarak görebildiğiniz eksik değerlerden söz ettik. Ancak bir veri satırının tamamı verilerde bulunmadığında eksik değerler örtük de olabilir. Aradaki farkı, bir hissenin her çeyrekteki fiyatını kaydeden basit bir veri kümesiyle gösterelim:
Bu veri kümesinde iki eksik gözlem vardır:
2020’nin dördüncü çeyreğindeki
price, değeriNAolduğu için açıkça eksiktir.2021’in ilk çeyreğindeki
price, veri kümesinde hiç görünmediği için örtük olarak eksiktir.
Aradaki farkı şu Zen tarzı bilmeceyle düşünebilirsiniz:
Açık eksik değer, bir yokluğun varlığıdır.
Örtük eksik değer, bir varlığın yokluğudur.
Bazen üzerinde çalışabileceğiniz somut bir şey elde etmek için örtük eksikleri açık hâle getirmek istersiniz. Başka durumlarda verinin yapısı açık eksikleri size dayatır ve bunlardan kurtulmak istersiniz. Aşağıdaki bölümlerde örtük ve açık eksiklik arasında geçiş yapmaya yönelik bazı araçlar ele alınmaktadır.
18.3.1 Pivotlama
Örtük eksikleri açık, açık eksikleri de örtük hâle getirebilen bir aracı zaten gördünüz: pivotlama. Verileri genişletmek örtük eksik değerleri açık hâle getirebilir; çünkü satırlarla yeni sütunların her birleşiminin bir değeri olmalıdır. Örneğin quarter değerlerini sütunlara yerleştirmek için stocks verisini pivotlarsak iki eksik değer de açık hâle gelir:
stocks |>
  pivot_wider(
    names_from = qtr,
    values_from = price
  )
#> # A tibble: 2 × 5
#>    year   `1`   `2`   `3`   `4`
#>   <dbl> <dbl> <dbl> <dbl> <dbl>
#> 1  2020  1.88  0.59  0.35 NA
#> 2  2021 NA     0.92  0.17  2.66
Verileri uzatmak varsayılan olarak açık eksik değerleri korur; ancak bunlar yalnızca veriler düzenli olmadığı için var olan yapısal eksik değerlerse values_drop_na = TRUE ayarıyla kaldırabilir, yani örtük hâle getirebilirsiniz. Daha fazla ayrıntı için Bölüm 5.2 bölümündeki örneklere bakın.
18.3.2 Tamamlama
tidyr::complete(), var olması gereken satır birleşimlerini tanımlayan bir değişken kümesi sağlayarak açık eksik değerler üretmenize olanak tanır. Örneğin stocks verisinde tüm year ve qtr birleşimlerinin bulunması gerektiğini biliyoruz:
stocks |>
  complete(year, qtr)
#> # A tibble: 8 × 3
#>    year   qtr price
#>   <dbl> <dbl> <dbl>
#> 1  2020     1  1.88
#> 2  2020     2  0.59
#> 3  2020     3  0.35
#> 4  2020     4 NA
#> 5  2021     1 NA
#> 6  2021     2  0.92
#> # ℹ 2 more rows
Genellikle complete() fonksiyonunu mevcut değişkenlerin adlarıyla çağırıp eksik birleşimleri doldurursunuz. Ancak bazen ayrı değişkenlerin kendileri eksiktir; bu durumda kendi verilerinizi sağlayabilirsiniz. Örneğin stocks veri kümesinin 2019’dan 2021’e kadar uzanması gerektiğini biliyorsanız year için bu değerleri açıkça sağlayabilirsiniz:
stocks |>
  complete(year = 2019:2021, qtr)
#> # A tibble: 12 × 3
#>    year   qtr price
#>   <dbl> <dbl> <dbl>
#> 1  2019     1 NA
#> 2  2019     2 NA
#> 3  2019     3 NA
#> 4  2019     4 NA
#> 5  2020     1  1.88
#> 6  2020     2  0.59
#> # ℹ 6 more rows
Bir değişkenin aralığı doğru ancak tüm değerleri mevcut değilse min(x) ile max(x) arasındaki tüm değerleri 1 aralıkla üretmek için full_seq(x, 1) kullanabilirsiniz.
Bazı durumlarda gözlemlerin tam kümesi basit bir değişken birleşimiyle üretilemez. Bu durumda complete() fonksiyonunun yaptığı işi elle yapabilirsiniz: Var olması gereken tüm satırları içeren bir veri çerçevesi oluşturun (gereken teknik birleşimini kullanarak), ardından bunu dplyr::full_join() ile özgün veri kümenizle birleştirin.
18.3.3 Birleştirmeler
Bu bizi örtük olarak eksik gözlemleri ortaya çıkarmanın bir başka önemli yoluna getirir: birleştirmeler. Birleştirmeler hakkında Bölüm 19 bölümünde daha fazla bilgi edineceksiniz; ancak bir veri kümesindeki değerlerin eksik olduğunu çoğu zaman yalnızca başka bir veri kümesiyle karşılaştırdığınızda anlayabildiğiniz için burada kısaca söz etmek istedik.
dplyr::anti_join(x, y), x içinde olup y içinde eşleşmesi bulunmayan satırları seçtiği için burada özellikle yararlıdır. Örneğin iki anti_join() kullanarak flights içinde adı geçen dört havaalanı ve 722 uçak için bilgilerin eksik olduğunu ortaya çıkarabiliriz:
library(nycflights13)

flights |>
  distinct(faa = dest) |>
  anti_join(airports)
#> Joining with `by = join_by(faa)`
#> # A tibble: 4 × 1
#>   faa
#>   <chr>
#> 1 BQN
#> 2 SJU
#> 3 STT
#> 4 PSE

flights |>
  distinct(tailnum) |>
  anti_join(planes)
#> Joining with `by = join_by(tailnum)`
#> # A tibble: 722 × 1
#>   tailnum
#>   <chr>
#> 1 N3ALAA
#> 2 N3DUAA
#> 3 N542MQ
#> 4 N730MQ
#> 5 N9EAMQ
#> 6 N532UA
#> # ℹ 716 more rows
18.3.4 Alıştırmalar
- Hava yolu şirketi ile
planesiçinde eksik görünen satırlar arasında bir ilişki bulabilir misiniz?
18.4 Faktörler ve boş gruplar
Eksikliğin son bir türü, faktörlerle çalışırken ortaya çıkabilen ve hiç gözlem içermeyen boş gruptur. Örneğin kişiler hakkında bazı sağlık bilgileri içeren bir veri kümemiz olduğunu düşünün:
Sigara içenlerin sayısını dplyr::count() ile hesaplamak istiyoruz:
health |> count(smoker)
#> # A tibble: 1 × 2
#>   smoker     n
#>   <fct>  <int>
#> 1 no         5
Bu veri kümesi yalnızca sigara içmeyenleri içerir ancak sigara içenlerin var olduğunu biliyoruz; sigara içenler grubu boştur. .drop = FALSE kullanarak count() fonksiyonundan verilerde görülmeyenler dahil tüm grupları korumasını isteyebiliriz:
health |> count(smoker, .drop = FALSE)
#> # A tibble: 2 × 2
#>   smoker     n
#>   <fct>  <int>
#> 1 yes        0
#> 2 no         5
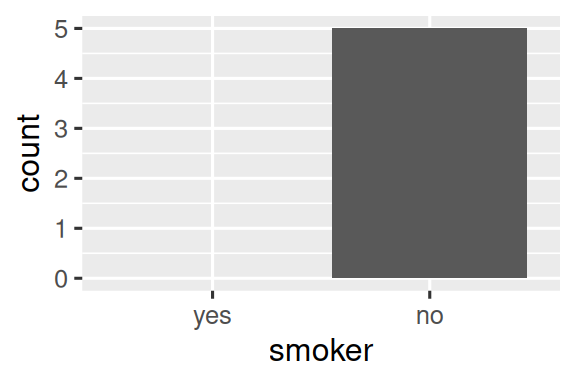
Aynı ilke, hiç değeri olmayan düzeyleri kaldıran ggplot2’nin kesikli eksenleri için de geçerlidir. İlgili kesikli eksene drop = FALSE sağlayarak bu düzeylerin görüntülenmesini zorunlu kılabilirsiniz:
ggplot(health, aes(x = smoker)) +
  geom_bar() +
  scale_x_discrete()

ggplot(health, aes(x = smoker)) +
  geom_bar() +
  scale_x_discrete(drop = FALSE)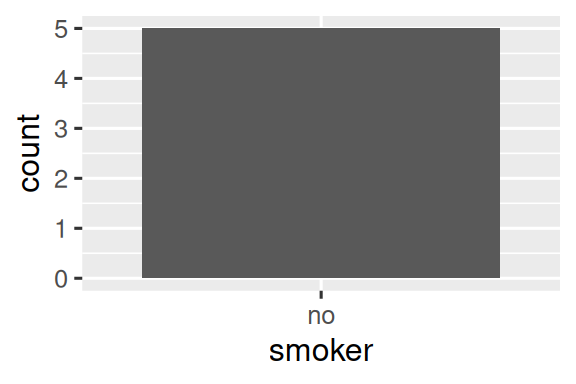
Aynı sorun daha genel olarak dplyr::group_by() ile de ortaya çıkar. Yine tüm faktör düzeylerini korumak için .drop = FALSE kullanabilirsiniz:
health |>
  group_by(smoker, .drop = FALSE) |>
  summarize(
    n = n(),
    mean_age = mean(age),
    min_age = min(age),
    max_age = max(age),
    sd_age = sd(age)
  )
#> # A tibble: 2 × 6
#>   smoker     n mean_age min_age max_age sd_age
#>   <fct>  <int>    <dbl>   <dbl>   <dbl>  <dbl>
#> 1 yes        0      NaN     Inf    -Inf   NA
#> 2 no         5       60      34      88   21.6
Burada ilginç sonuçlar elde ederiz; çünkü boş bir grup özetlenirken özet fonksiyonları sıfır uzunluklu vektörlere uygulanır. Uzunluğu 0 olan boş vektörler ile her birinin uzunluğu 1 olan eksik değerler arasında önemli bir ayrım vardır.
Tüm özet fonksiyonları sıfır uzunluklu vektörlerle çalışır ancak ilk bakışta şaşırtıcı sonuçlar döndürebilir. Burada mean(age) fonksiyonunun NaN döndürdüğünü görürüz; çünkü mean(age) = sum(age)/length(age) ve bu örnekte sonuç 0/0’dır. max() ve min() boş vektörler için -Inf ve Inf döndürür; dolayısıyla sonuçları boş olmayan yeni bir veri vektörüyle birleştirip yeniden hesaplarsanız yeni verilerin minimum veya maksimumunu elde edersiniz1.
Bazen daha basit bir yaklaşım, özeti hesaplayıp ardından örtük eksikleri complete() ile açık hâle getirmektir.
health |>
  group_by(smoker) |>
  summarize(
    n = n(),
    mean_age = mean(age),
    min_age = min(age),
    max_age = max(age),
    sd_age = sd(age)
  ) |>
  complete(smoker)
#> # A tibble: 2 × 6
#>   smoker     n mean_age min_age max_age sd_age
#>   <fct>  <int>    <dbl>   <dbl>   <dbl>  <dbl>
#> 1 yes       NA       NA      NA      NA   NA
#> 2 no         5       60      34      88   21.6
Bu yaklaşımın temel dezavantajı, sayımın sıfır olması gerektiğini bildiğiniz hâlde NA elde etmenizdir.
18.5 Özet
Eksik değerler tuhaftır! Bazen açık bir NA olarak kaydedilir, bazen de onları yalnızca yokluklarından fark edersiniz. Bu bölüm açık eksik değerlerle çalışmaya ve örtük eksik değerleri ortaya çıkarmaya yönelik araçlar sundu; ayrıca örtük eksiklerin nasıl açık, açık eksiklerin de nasıl örtük hâle gelebileceğini ele aldı.
Bir sonraki bölümde kitabın bu kısmındaki son konuyu ele alacağız: birleştirmeler. Bu, şimdiye kadarki bölümlerden biraz farklıdır; çünkü veri çerçevesinin içine koyduğunuz öğeler yerine veri çerçevelerinin bütünüyle çalışan araçları ele alacağız.
Başka bir deyişle
min(c(x, y))her zamanmin(min(x), min(y))değerine eşittir.↩︎