24 Web kazıma
24.1 Giriş
Bu bölümde rvest ile web kazımanın temellerini öğreneceksiniz. Web kazıma, web sayfalarından veri çıkarmak için çok kullanışlı bir araçtır. Bazı web siteleri, verileri JSON olarak döndüren yapılandırılmış HTTP istekleri kümesi olan bir API sunar; bu verileri Bölüm 23 bölümündeki tekniklerle işleyebilirsiniz. Mümkün olduğunda API’yi kullanmalısınız1; çünkü genellikle daha güvenilir veriler sağlar. Ne yazık ki web API’leriyle programlama bu kitabın kapsamı dışındadır. Bunun yerine, site API sunsun ya da sunmasın çalışan bir teknik olan web kazımayı öğretiyoruz.
Bu bölümde HTML’in temellerine geçmeden önce web kazımanın etik ve hukuki yönlerini ele alacağız. Ardından sayfadaki belirli öğeleri bulmak için CSS seçicilerinin temellerini ve HTML’deki metinlerle özniteliklerden R’a veri içe aktarmak için rvest fonksiyonlarını nasıl kullanacağınızı öğreneceksiniz. Sonrasında kazıdığınız sayfa için hangi CSS seçicisine ihtiyacınız olduğunu belirlemeye yarayan bazı teknikleri tartışacak; birkaç örnek olay ve dinamik web siteleri üzerine kısa bir değerlendirmeyle bitireceğiz.
24.1.1 Ön koşullar
Bu bölümde rvest’ın sağladığı araçlara odaklanacağız. rvest tidyverse’in bir üyesidir, ancak temel üyelerinden biri değildir; dolayısıyla onu açıkça yüklemeniz gerekir. Kazıdığımız verilerle çalışırken genel olarak yararlı olacağından tidyverse’in tamamını da yükleyeceğiz.
24.2 Web kazımanın etik ve hukuki yönleri
Web kazıma için gereken kodu ele almaya başlamadan önce bunu yapmanın hukuka ve etiğe uygun olup olmadığını konuşmamız gerekir. Genel olarak her iki açıdan da durum karmaşıktır.
Hukuki durum büyük ölçüde yaşadığınız yere bağlıdır. Bununla birlikte genel bir ilke olarak veriler herkese açık, kişisel olmayan ve olgusal ise büyük olasılıkla sorun yaşamazsınız2. Aşağıda ele alacağımız gibi bu üç etmen sitenin hüküm ve koşulları, kişisel olarak tanımlanabilir bilgiler ve telif hakkıyla bağlantılı olduğu için önemlidir.
Veriler herkese açık, kişisel olmayan ya da olgusal değilse veya özellikle para kazanmak amacıyla veri kazıyorsanız bir hukukçuyla görüşmeniz gerekir. Her durumda, kazıdığınız sayfaları barındıran sunucunun kaynaklarına saygılı olmalısınız. En önemlisi, çok sayıda sayfa kazıyorsanız her istek arasında biraz beklediğinizden emin olmalısınız. Bunu yapmanın kolay bir yolu Dmytro Perepolkin’in polite paketini kullanmaktır. Bu paket istekler arasında otomatik olarak bekler ve sonuçları önbelleğe alır; böylece aynı sayfayı hiçbir zaman iki kez istemezsiniz.
24.2.1 Hizmet koşulları
Dikkatle bakarsanız birçok web sitesinin sayfanın bir yerinde “hüküm ve koşullar” ya da “hizmet koşulları” bağlantısı içerdiğini görürsünüz. Bu sayfayı dikkatle okuduğunuzda çoğu zaman sitenin web kazımayı açıkça yasakladığını keşfedersiniz. Bu sayfalar, şirketlerin çok geniş iddialarda bulunduğu hukuki alan kapma girişimleri olma eğilimindedir. Mümkün olduğunda bu hizmet koşullarına uymak nezaket gereğidir; ancak ileri sürülen iddiaları ihtiyatla değerlendirin.
ABD mahkemeleri genel olarak hizmet koşullarını yalnızca web sitesinin alt bilgisine koymanın, kullanıcıyı bunlarla bağlı kılmaya yeterli olmadığına hükmetmiştir; örneğin HiQ Labs v. LinkedIn. Genellikle hizmet koşullarıyla bağlı olmanız için hesap oluşturmak ya da bir kutuyu işaretlemek gibi açık bir işlem yapmış olmanız gerekir. Verilerin herkese açık olup olmamasının önemli olmasının nedeni budur: Verilere erişmek için bir hesaba ihtiyacınız yoksa hizmet koşullarıyla bağlı olma olasılığınız düşüktür. Ancak Avrupa’da durumun oldukça farklı olduğunu unutmayın; mahkemeler açıkça kabul etmeseniz bile hizmet koşullarının uygulanabilir olduğuna hükmetmiştir.
24.2.2 Kişisel olarak tanımlanabilir bilgiler
Veriler herkese açık olsa bile adlar, e-posta adresleri, telefon numaraları ve doğum tarihleri gibi kişisel olarak tanımlanabilir bilgileri kazırken son derece dikkatli olmalısınız. Avrupa’da bu tür verilerin toplanması veya saklanması konusunda özellikle katı yasalar vardır (GDPR); nerede yaşarsanız yaşayın etik açıdan çetrefilli bir alana girmeniz olasıdır. Örneğin 2016’da bir araştırmacı grubu OkCupid adlı arkadaşlık sitesindeki 70.000 kişinin herkese açık profil bilgilerini (kullanıcı adı, yaş, cinsiyet ve konum gibi) kazımış ve anonimleştirmeye yönelik hiçbir girişimde bulunmadan bu verileri kamuya açıklamıştır. Araştırmacılar veriler zaten herkese açık olduğu için bunda yanlış bir şey olmadığını düşünse de bilgileri veri kümesinde yayımlanan kullanıcıların tanımlanabilirliğine ilişkin etik kaygılar nedeniyle çalışma geniş ölçüde kınanmıştır. Çalışmanız kişisel olarak tanımlanabilir bilgilerin kazınmasını içeriyorsa OkCupid çalışmasının3 yanı sıra bu tür bilgilerin edinilmesini ve yayımlanmasını içeren, araştırma etiği tartışmalı benzer çalışmaları okumanızı önemle öneririz.
24.2.3 Telif hakkı
Son olarak telif hakkı hukukunu da dikkate almanız gerekir. Telif hakkı hukuku karmaşıktır; ancak tam olarak neyin korunduğunu açıklayan ABD yasasına bakmak yararlıdır: “[…] herhangi bir somut ifade ortamına kaydedilmiş özgün eserler, […]”. Yasa daha sonra edebî eserler, müzik eserleri ve sinema filmleri gibi uygulandığı belirli kategorileri açıklar. Veriler ise dikkat çekici biçimde telif hakkı koruması kapsamı dışındadır. Bu, kazıma işleminizi olgularla sınırladığınız sürece telif hakkı korumasının uygulanmadığı anlamına gelir. (Ancak Avrupa’da veritabanlarını koruyan ayrı bir “sui generis” hak bulunduğunu unutmayın.)
Kısa bir örnek olarak ABD’de malzeme ve talimat listeleri telif hakkına konu olamaz; dolayısıyla bir tarifi korumak için telif hakkı kullanılamaz. Ancak bu tarif listesine önemli ölçüde özgün edebî içerik eşlik ediyorsa bu içerik telif hakkıyla korunabilir. İnternette bir tarif aradığınızda öncesinde her zaman bu kadar çok içerik bulunmasının nedeni budur.
Özgün içerik (metin veya görsel gibi) kazımanız gerekiyorsa adil kullanım doktrini kapsamında yine de korunabilirsiniz. Adil kullanım kesin bir kural değildir; bir dizi etmeni birlikte değerlendirir. Verileri araştırma ya da ticari olmayan amaçlarla topluyorsanız ve kazıdığınız içeriği yalnızca ihtiyacınız olanla sınırlıyorsanız uygulanma olasılığı daha yüksektir.
24.3 HTML temelleri
Web sayfalarını kazımak için önce web sayfalarını tanımlayan dil olan HTML hakkında biraz bilgi edinmeniz gerekir. HTML, HyperText Markup Language ifadesinin kısaltmasıdır ve kabaca şöyle görünür:
<html>
<head>
<title>Sayfa başlığı</title>
</head>
<body>
<h1 id='first'>Bir başlık</h1>
<p>Biraz metin & <b>biraz kalın metin.</b></p>
<img src='myimg.png' width='100' height='100'>
</body>HTML; başlangıç etiketi (ör. <tag>), isteğe bağlı öznitelikler (id='first'), bitiş etiketi4 (</tag> gibi) ve içerikten (başlangıç ve bitiş etiketleri arasındaki her şey) oluşan öğelerin meydana getirdiği hiyerarşik bir yapıya sahiptir.
< ve > başlangıç ve bitiş etiketleri için kullanıldığından bunları doğrudan yazamazsınız. Bunun yerine > (büyüktür) ve < (küçüktür) HTML kaçışlarını kullanmanız gerekir. Bu kaçışlar & kullandığı için gerçek bir ve işareti yazmak isterseniz onu & olarak kaçırmanız gerekir. Çok çeşitli HTML kaçışları vardır; ancak rvest bunları sizin için otomatik olarak işlediğinden üzerlerinde fazla düşünmeniz gerekmez.
Web kazıma mümkündür; çünkü kazımak istediğiniz verileri içeren sayfaların çoğu genellikle tutarlı bir yapıya sahiptir.
24.3.1 Öğeler
100’den fazla HTML öğesi vardır. En önemlilerinden bazıları şunlardır:
Her HTML sayfası bir
<html>öğesi içinde olmalı ve iki çocuğa sahip olmalıdır: Sayfa başlığı gibi belge üst verilerini içeren<head>ve tarayıcıda gördüğünüz içeriği barındıran<body>.<h1>(1. düzey başlık),<section>(bölüm),<p>(paragraf) ve<ol>(sıralı liste) gibi blok etiketleri sayfanın genel yapısını oluşturur.<b>(kalın),<i>(italik) ve<a>(bağlantı) gibi satır içi etiketler blok etiketlerinin içindeki metni biçimlendirir.
Daha önce hiç görmediğiniz bir etiketle karşılaşırsanız biraz Google araması yaparak ne işe yaradığını öğrenebilirsiniz. Web programlamanın neredeyse her yönünü açıklayan MDN Web Belgeleri de başlamak için iyi bir yerdir.
Çoğu öğe başlangıç ve bitiş etiketleri arasında içerik barındırabilir. Bu içerik metin ya da başka öğeler olabilir. Örneğin aşağıdaki HTML, bir sözcüğü kalın yazılmış bir metin paragrafı içerir.
<p>
  Merhaba! Benim <b>adım</b> Hadley.
</p>Çocuklar, bir öğenin içerdiği öğelerdir; dolayısıyla yukarıdaki <p> öğesinin <b> adlı bir çocuğu vardır. <b> öğesinin çocuğu yoktur, ancak içeriği vardır ("adım" metni).
24.3.2 Öznitelikler
Etiketler name1='value1' name2='value2' biçiminde görünen adlandırılmış özniteliklere sahip olabilir. En önemli özniteliklerden ikisi, sayfanın görsel görünümünü denetlemek üzere CSS (Basamaklı Stil Sayfaları) ile birlikte kullanılan id ve class öznitelikleridir. Bunlar bir sayfadan veri kazırken çoğu zaman kullanışlıdır. Öznitelikler bağlantıların hedefini (<a> öğelerinin href özniteliği) ve görsellerin kaynağını (<img> öğesinin src özniteliği) kaydetmek için de kullanılır.
24.4 Veri çıkarma
Kazımaya başlamak için kazımak istediğiniz sayfanın URL’sine ihtiyacınız vardır; bunu genellikle web tarayıcınızdan kopyalayabilirsiniz. Ardından bu sayfanın HTML’ini read_html() ile R’a okumanız gerekir. Bu fonksiyon, daha sonra rvest fonksiyonlarıyla işleyeceğiniz bir xml_document5 nesnesi döndürür:
html <- read_html("http://rvest.tidyverse.org/")
html
#> {html_document}
#> <html lang="en">
#> [1] <head>\n<meta http-equiv="Content-Type" content="text/html; charset=UT ...
#> [2] <body>\n    <a href="#container" class="visually-hidden-focusable">Ski ...
rvest ayrıca HTML’i satır içinde yazmanızı sağlayan bir fonksiyon içerir. Çeşitli rvest fonksiyonlarının nasıl çalıştığını basit örneklerle öğretirken bu bölümde onu sıkça kullanacağız.
html <- minimal_html("
  <p>Bu bir paragraftır</p>
  <ul>
    <li>Bu bir madde işaretli listedir</li>
  </ul>
")
html
#> {html_document}
#> <html>
#> [1] <head>\n<meta http-equiv="Content-Type" content="text/html; charset=UT ...
#> [2] <body>\n<p>Bu bir paragraftır</p>\n  <ul>\n<li>Bu bir madde işaretli l ...
HTML artık R’da olduğuna göre ilgilendiğimiz verileri çıkarma zamanı geldi. Önce ilgilendiğiniz öğeleri belirlemenizi sağlayan CSS seçicilerini ve bu öğelerden veri çıkarmak için kullanabileceğiniz rvest fonksiyonlarını öğreneceksiniz. Ardından özel araçlara sahip HTML tablolarını kısaca ele alacağız.
24.4.1 Öğeleri bulma
CSS, cascading style sheets (basamaklı stil sayfaları) ifadesinin kısaltmasıdır ve HTML belgelerinin görsel stilini tanımlamaya yarayan bir araçtır. CSS, bir sayfadaki öğeleri seçmek için kullanılan CSS seçicileri adlı küçük bir dil içerir. CSS seçicileri HTML öğelerini bulmaya yönelik örüntüler tanımlar ve hangi öğeleri çıkarmak istediğinizi kısa yoldan açıklamanızı sağladığı için kazıma açısından kullanışlıdır.
CSS seçicilerine Bölüm 24.5 bölümünde daha ayrıntılı döneceğiz; ancak neyse ki yalnızca üç seçiciyle epey ilerleyebilirsiniz:
p, tüm<p>öğelerini seçer..title,classdeğeri"title"olan tüm öğeleri seçer.#title,idözniteliği"title"değerine eşit olan öğeyi seçer. Id öznitelikleri belge içinde benzersiz olmalıdır; dolayısıyla bu her zaman yalnızca tek bir öğe seçer.
Bu seçicileri basit bir örnekle deneyelim:
html <- minimal_html("
  <h1>Bu bir başlıktır</h1>
  <p id='first'>Bu bir paragraftır</p>
  <p class='important'>Bu önemli bir paragraftır</p>
")
Seçiciyle eşleşen tüm öğeleri bulmak için html_elements() kullanın:
html |> html_elements("p")
#> {xml_nodeset (2)}
#> [1] <p id="first">Bu bir paragraftır</p>
#> [2] <p class="important">Bu önemli bir paragraftır</p>
html |> html_elements(".important")
#> {xml_nodeset (1)}
#> [1] <p class="important">Bu önemli bir paragraftır</p>
html |> html_elements("#first")
#> {xml_nodeset (1)}
#> [1] <p id="first">Bu bir paragraftır</p>
Bir başka önemli fonksiyon, her zaman girdilerle aynı sayıda çıktı döndüren html_element() fonksiyonudur. Onu belgenin tamamına uygularsanız ilk eşleşmeyi verir:
html |> html_element("p")
#> {html_node}
#> <p id="first">
Hiçbir öğeyle eşleşmeyen bir seçici kullandığınızda html_element() ile html_elements() arasında önemli bir fark vardır. html_elements() sıfır uzunluklu bir vektör, html_element() ise eksik değer döndürür. Bu fark birazdan önemli olacaktır.
html |> html_elements("b")
#> {xml_nodeset (0)}
html |> html_element("b")
#> {xml_missing}
#> <NA>
24.4.2 Seçimleri iç içe yerleştirme
Çoğu durumda html_elements() ve html_element() fonksiyonlarını birlikte kullanırsınız. Genellikle gözlem olacak öğeleri belirlemek için html_elements(), değişken olacak öğeleri bulmak içinse html_element() kullanılır. Bunu basit bir örnek üzerinde görelim. Burada her liste öğesinin (<li>) Star Wars’taki dört karakter hakkında bazı bilgiler içerdiği sırasız bir listemiz (<ul>) vardır:
html <- minimal_html("
  <ul>
    <li><b>C-3PO</b>, <span class='weight'>167 kg</span> ağırlığında bir <i>droid</i></li>
    <li><b>R4-P17</b> bir <i>droid</i></li>
    <li><b>R2-D2</b>, <span class='weight'>96 kg</span> ağırlığında bir <i>droid</i></li>
    <li><b>Yoda</b> <span class='weight'>66 kg</span> ağırlığındadır</li>
  </ul>
  ")
Her öğesi farklı bir karaktere karşılık gelen bir vektör oluşturmak için html_elements() kullanabiliriz:
characters <- html |> html_elements("li")
characters
#> {xml_nodeset (4)}
#> [1] <li>\n<b>C-3PO</b>, <span class="weight">167 kg</span> ağırlığında bir ...
#> [2] <li>\n<b>R4-P17</b> bir <i>droid</i>\n</li>
#> [3] <li>\n<b>R2-D2</b>, <span class="weight">96 kg</span> ağırlığında bir  ...
#> [4] <li>\n<b>Yoda</b> <span class="weight">66 kg</span> ağırlığındadır</li>
Her karakterin adını çıkarmak için html_element() kullanırız; çünkü html_elements() çıktısına uygulandığında her öğe için bir yanıt döndürmesi garantidir:
characters |> html_element("b")
#> {xml_nodeset (4)}
#> [1] <b>C-3PO</b>
#> [2] <b>R4-P17</b>
#> [3] <b>R2-D2</b>
#> [4] <b>Yoda</b>
html_element() ile html_elements() arasındaki ayrım ad için önemli değildir, ancak ağırlık için önemlidir. Bir ağırlık <span> öğesi bulunmasa bile her karakter için bir ağırlık almak istiyoruz. html_element() tam olarak bunu yapar:
characters |> html_element(".weight")
#> {xml_nodeset (4)}
#> [1] <span class="weight">167 kg</span>
#> [2] NA
#> [3] <span class="weight">96 kg</span>
#> [4] <span class="weight">66 kg</span>html_elements(), characters öğelerinin çocukları olan tüm ağırlık <span> öğelerini bulur. Bunlardan yalnızca üç tane olduğundan adlarla ağırlıklar arasındaki bağlantıyı kaybederiz:
characters |> html_elements(".weight")
#> {xml_nodeset (3)}
#> [1] <span class="weight">167 kg</span>
#> [2] <span class="weight">96 kg</span>
#> [3] <span class="weight">66 kg</span>
İlgilendiğiniz öğeleri seçtiğinize göre verileri metin içeriğinden ya da bazı özniteliklerden çıkarmanız gerekir.
24.4.3 Metin ve öznitelikler
html_text2()6, bir HTML öğesinin düz metin içeriğini çıkarır:
characters |>
  html_element("b") |>
  html_text2()
#> [1] "C-3PO"  "R4-P17" "R2-D2"  "Yoda"

characters |>
  html_element(".weight") |>
  html_text2()
#> [1] "167 kg" NA       "96 kg"  "66 kg"
Tüm kaçışların otomatik olarak işleneceğini unutmayın; HTML kaçışlarını rvest’ın döndürdüğü verilerde değil, yalnızca kaynak HTML’de görürsünüz.
html_attr() özniteliklerden veri çıkarır:
html <- minimal_html("
  <p><a href='https://en.wikipedia.org/wiki/Cat'>kediler</a></p>
  <p><a href='https://en.wikipedia.org/wiki/Dog'>köpekler</a></p>
")

html |>
  html_elements("p") |>
  html_element("a") |>
  html_attr("href")
#> [1] "https://en.wikipedia.org/wiki/Cat" "https://en.wikipedia.org/wiki/Dog"
html_attr() her zaman bir karakter dizisi döndürür; dolayısıyla sayı ya da tarih çıkarıyorsanız sonradan bazı işlemler yapmanız gerekir.
24.4.4 Tablolar
Şanslıysanız verileriniz zaten bir HTML tablosunda saklanıyordur ve tek yapmanız gereken onları bu tablodan okumaktır. Tarayıcıda bir tabloyu tanımak genellikle kolaydır: Satır ve sütunlardan oluşan dikdörtgensel bir yapıya sahiptir ve onu Excel gibi bir araca kopyalayıp yapıştırabilirsiniz.
HTML tabloları dört temel öğeden oluşur: <table>, <tr> (tablo satırı), <th> (tablo başlığı) ve <td> (tablo verisi). İşte iki sütunlu ve üç veri satırlı basit bir HTML tablosu:
html <- minimal_html("
  <table class='mytable'>
    <tr><th>x</th>   <th>y</th></tr>
    <tr><td>1.5</td> <td>2.7</td></tr>
    <tr><td>4.9</td> <td>1.3</td></tr>
    <tr><td>7.2</td> <td>8.1</td></tr>
  </table>
  ")
rvest bu tür verileri nasıl okuyacağını bilen bir fonksiyon sağlar: html_table(). Sayfada bulunan her tablo için bir tibble içeren liste döndürür. Çıkarmak istediğiniz tabloyu belirlemek için html_element() kullanın:
html |>
  html_element(".mytable") |>
  html_table()
#> # A tibble: 3 × 2
#>       x     y
#>   <dbl> <dbl>
#> 1   1.5   2.7
#> 2   4.9   1.3
#> 3   7.2   8.1
x ve y sütunlarının otomatik olarak sayıya dönüştürüldüğüne dikkat edin. Bu otomatik dönüşüm her zaman çalışmaz; dolayısıyla daha karmaşık durumlarda convert = FALSE ile onu kapatıp dönüşümü kendiniz yapmak isteyebilirsiniz.
24.5 Doğru seçicileri bulma
Verileriniz için gereken seçiciyi belirlemek genellikle problemin en zor kısmıdır. Hem özgül (yani ilgilenmediğiniz şeyleri seçmeyen) hem duyarlı (yani ilgilendiğiniz her şeyi seçen) bir seçici bulmak için çoğu zaman denemeler yapmanız gerekir. Çok sayıda deneme yanılma sürecin olağan bir parçasıdır! Bu süreçte size yardımcı olabilecek iki temel araç vardır: SelectorGadget ve tarayıcınızın geliştirici araçları.
SelectorGadget, sağladığınız olumlu ve olumsuz örneklere göre otomatik olarak CSS seçicileri üreten bir JavaScript yer imidir. Her zaman çalışmaz; ama çalıştığında sihir gibidir! SelectorGadget’ı nasıl kurup kullanacağınızı https://rvest.tidyverse.org/articles/selectorgadget.html adresini okuyarak ya da Mine’ın https://www.youtube.com/watch?v=PetWV5g1Xsc adresindeki videosunu izleyerek öğrenebilirsiniz.
Her modern tarayıcı geliştiriciler için bazı araçlar sunar; ancak günlük tarayıcınız olmasa bile Chrome’u öneriyoruz. Web geliştirici araçları en iyiler arasındadır ve hemen kullanılabilir. Sayfadaki bir öğeye sağ tıklayıp İncele seçeneğine tıklayın. Bu, tıkladığınız öğeyi merkeze alan ve genişletilebilen eksiksiz HTML sayfası görünümünü açar. Sayfayı incelemek ve hangi seçicilerin işe yarayabileceği hakkında fikir edinmek için bunu kullanabilirsiniz. Sayfanın görsel yapısını oluşturmak için sıklıkla kullanılan ve dolayısıyla aradığınız verileri çıkarmada iyi araçlar olan class ve id özniteliklerine özellikle dikkat edin.
Öğeler görünümünde bir öğeye sağ tıklayıp Seçici olarak kopyala seçeneğini belirleyerek ilgilendiğiniz öğeyi benzersiz biçimde tanımlayan bir seçici de üretebilirsiniz.
SelectorGadget veya Chrome Geliştirici Araçları anlamadığınız bir CSS seçicisi ürettiyse CSS seçicilerini sade İngilizceye çeviren Selectors Explained aracını deneyin. Bunu sık sık yapıyorsanız genel olarak CSS seçicileri hakkında daha fazla bilgi edinmek isteyebilirsiniz. Eğlenceli CSS dinner öğreticisiyle başlamanızı, ardından MDN web belgelerine başvurmanızı öneririz.
24.6 Her şeyi bir araya getirme
Bazı web sitelerini kazımak için tüm bunları bir araya getirelim. Bu örnekleri çalıştırdığınızda artık çalışmama olasılıkları vardır. Web kazımanın temel zorluğu budur: Sitenin yapısı değişirse kazıma kodunuzu da değiştirmeniz gerekir.
24.6.1 Star Wars
rvest, vignette("starwars") içinde çok basit bir örnek içerir. Bu, az miktarda HTML içeren basit bir sayfadır; dolayısıyla başlamak için iyi bir yerdir. Şimdi bu sayfaya gitmenizi ve bir Star Wars filminin başlığı olan başlıklardan birini “Öğeyi İncele” ile incelemenizi öneririz. HTML hiyerarşisini klavye veya fareyle keşfedin ve her filmin kullandığı ortak yapıyı anlamaya çalışın.
Her filmin aşağıdakine benzer ortak bir yapıya sahip olduğunu görebilmelisiniz:
<section>
  <h2 data-id="1">The Phantom Menace</h2>
  <p>Released: 1999-05-19</p>
  <p>Director: <span class="director">George Lucas</span></p>

  <div class="crawl">
    <p>...</p>
    <p>...</p>
    <p>...</p>
  </div>
</section>
Amacımız bu verileri title, year, director ve intro değişkenlerini içeren 7 satırlı bir veri çerçevesine dönüştürmektir. HTML’i okuyup tüm <section> öğelerini çıkararak başlayacağız:
url <- "https://rvest.tidyverse.org/articles/starwars.html"
html <- read_html(url)

section <- html |> html_elements("section")
section
#> {xml_nodeset (7)}
#> [1] <section><h2 data-id="1">\nThe Phantom Menace\n</h2>\n<p>\nReleased: 1 ...
#> [2] <section><h2 data-id="2">\nAttack of the Clones\n</h2>\n<p>\nReleased: ...
#> [3] <section><h2 data-id="3">\nRevenge of the Sith\n</h2>\n<p>\nReleased:  ...
#> [4] <section><h2 data-id="4">\nA New Hope\n</h2>\n<p>\nReleased: 1977-05-2 ...
#> [5] <section><h2 data-id="5">\nThe Empire Strikes Back\n</h2>\n<p>\nReleas ...
#> [6] <section><h2 data-id="6">\nReturn of the Jedi\n</h2>\n<p>\nReleased: 1 ...
#> [7] <section><h2 data-id="7">\nThe Force Awakens\n</h2>\n<p>\nReleased: 20 ...
Bu, sayfadaki yedi filmle eşleşen yedi öğe getirir ve section ifadesini seçici olarak kullanmanın uygun olduğunu gösterir. Veriler her zaman metinde bulunduğundan tek tek öğeleri çıkarmak kolaydır. Yalnızca doğru seçiciyi bulmak gerekir:
section |> html_element("h2") |> html_text2()
#> [1] "The Phantom Menace"      "Attack of the Clones"
#> [3] "Revenge of the Sith"     "A New Hope"
#> [5] "The Empire Strikes Back" "Return of the Jedi"
#> [7] "The Force Awakens"

section |> html_element(".director") |> html_text2()
#> [1] "George Lucas"     "George Lucas"     "George Lucas"
#> [4] "George Lucas"     "Irvin Kershner"   "Richard Marquand"
#> [7] "J. J. Abrams"
Bunu her bileşen için yaptıktan sonra tüm sonuçları bir tibble içinde bir araya getirebiliriz:
tibble(
  title = section |>
    html_element("h2") |>
    html_text2(),
  released = section |>
    html_element("p") |>
    html_text2() |>
    str_remove("Released: ") |>
    parse_date(),
  director = section |>
    html_element(".director") |>
    html_text2(),
  intro = section |>
    html_element(".crawl") |>
    html_text2()
)
#> # A tibble: 7 × 4
#>   title                   released   director         intro
#>   <chr>                   <date>     <chr>            <chr>
#> 1 The Phantom Menace      1999-05-19 George Lucas     "Turmoil has engulfed …
#> 2 Attack of the Clones    2002-05-16 George Lucas     "There is unrest in th…
#> 3 Revenge of the Sith     2005-05-19 George Lucas     "War! The Republic is …
#> 4 A New Hope              1977-05-25 George Lucas     "It is a period of civ…
#> 5 The Empire Strikes Back 1980-05-17 Irvin Kershner   "It is a dark time for…
#> 6 Return of the Jedi      1983-05-25 Richard Marquand "Luke Skywalker has re…
#> # ℹ 1 more row
Çözümlememizin ilerleyen aşamalarında kolayca kullanabileceğimiz bir değişken elde etmek için released üzerinde biraz daha işlem yaptık.
24.6.2 IMDb’nin en iyi filmleri
Sonraki görevimizde biraz daha zor bir işlemi ele alacak ve İnternet Film Veritabanı’ndaki (IMDb) en iyi 250 filmi çıkaracağız. Bu bölümü yazdığımız sırada sayfa Şekil 24.1 gibi görünüyordu.
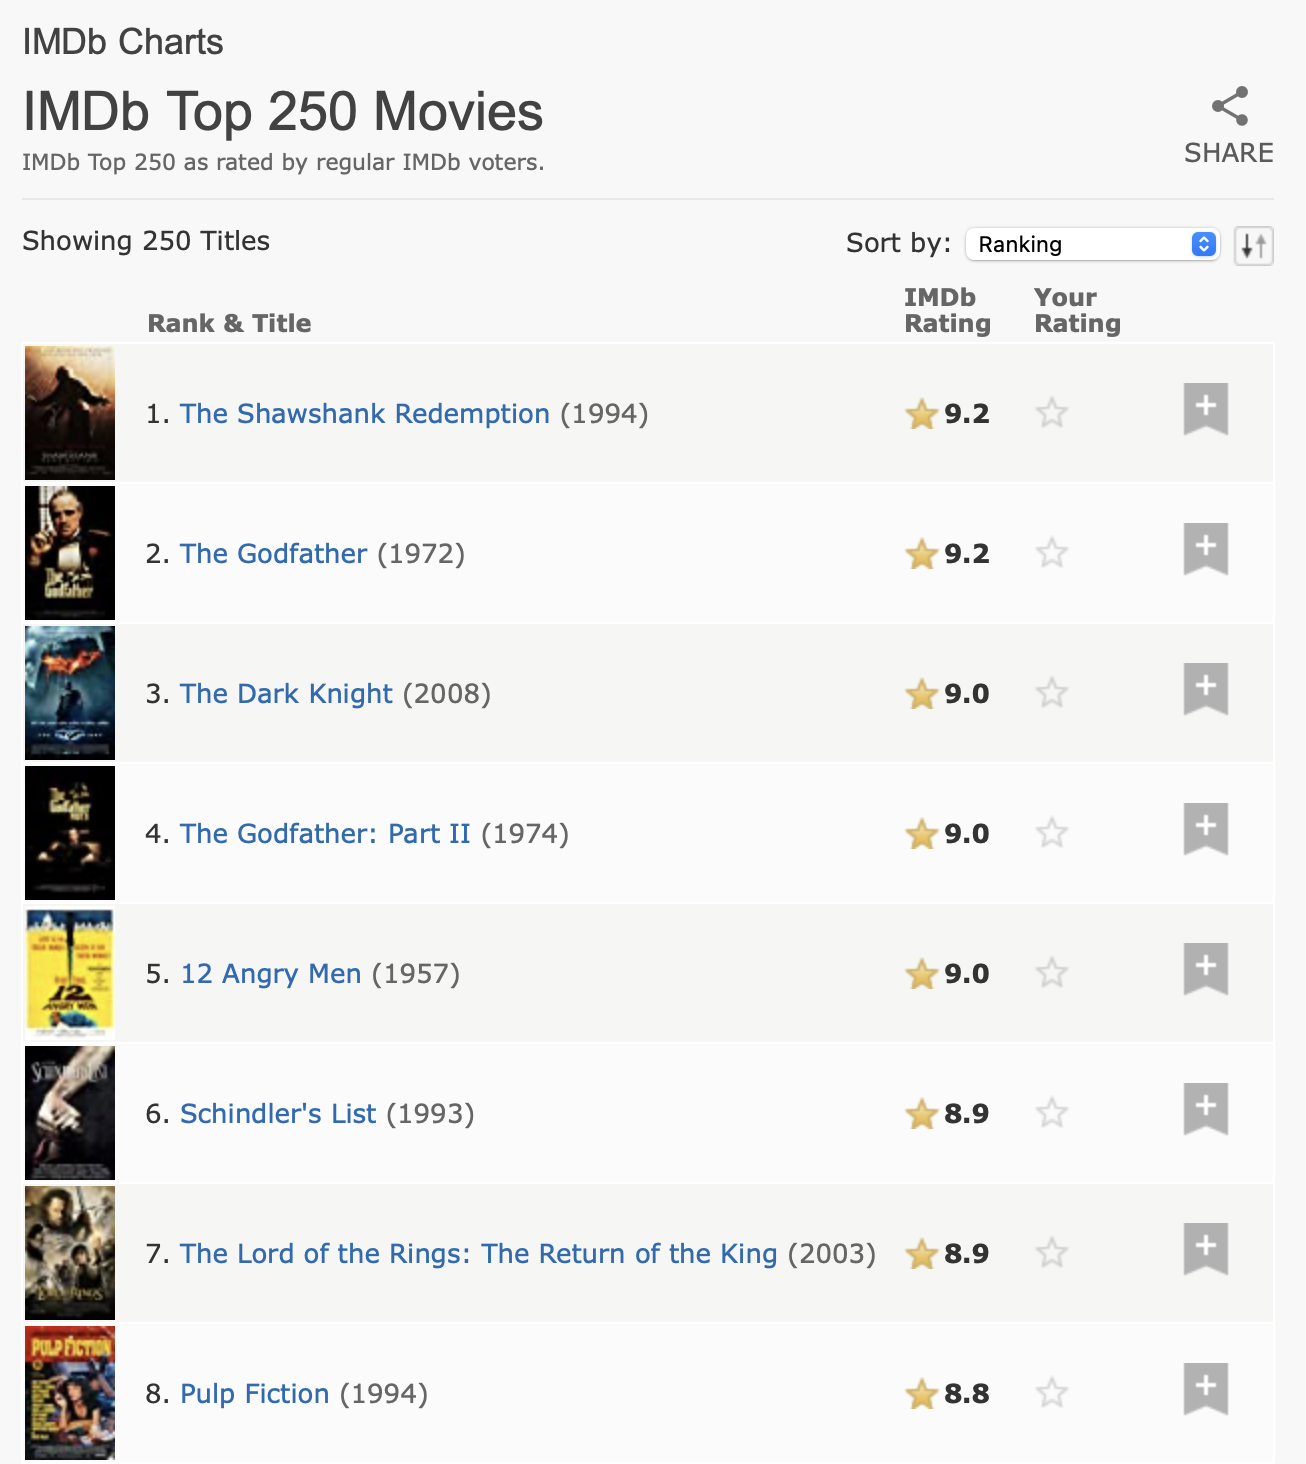
Bu veriler açık bir tablo yapısına sahip olduğundan html_table() ile başlamak uygundur:
url <- "https://web.archive.org/web/20220201012049/https://www.imdb.com/chart/top/"
html <- read_html(url)

table <- html |>
  html_element("table") |>
  html_table()
table
#> # A tibble: 250 × 5
#>   ``    `Rank & Title`                    `IMDb Rating` `Your Rating`   ``
#>   <lgl> <chr>                                     <dbl> <chr>           <lgl>
#> 1 NA    "1.\n      The Shawshank Redempt…           9.2 "12345678910\n… NA
#> 2 NA    "2.\n      The Godfather\n      …           9.1 "12345678910\n… NA
#> 3 NA    "3.\n      The Godfather: Part I…           9   "12345678910\n… NA
#> 4 NA    "4.\n      The Dark Knight\n    …           9   "12345678910\n… NA
#> 5 NA    "5.\n      12 Angry Men\n       …           8.9 "12345678910\n… NA
#> 6 NA    "6.\n      Schindler's List\n   …           8.9 "12345678910\n… NA
#> # ℹ 244 more rows
Bu sonuç birkaç boş sütun içerir, ancak genel olarak tablodaki bilgileri yakalama işini iyi yapar. Yine de kullanımı kolaylaştırmak için biraz daha işlem yapmamız gerekir. Önce sütunları daha kolay çalışılacak biçimde yeniden adlandıracak, sıra ve başlıktaki gereksiz boşlukları kaldıracağız. Yalnızca bu iki sütunu seçme ve yeniden adlandırma işlemlerini tek adımda yapmak için bunu rename() yerine select() ile yapacağız. Ardından yeni satırları ve fazla boşlukları kaldıracak, başlığı, yılı ve sırayı kendi değişkenlerine çıkarmak için separate_wider_regex() (Bölüm 15.3.4 bölümünden) uygulayacağız.
ratings <- table |>
  select(
    rank_title_year = `Rank & Title`,
    rating = `IMDb Rating`
  ) |>
  mutate(
    rank_title_year = str_replace_all(rank_title_year, "\n +", " ")
  ) |>
  separate_wider_regex(
    rank_title_year,
    patterns = c(
      rank = "\\d+", "\\. ",
      title = ".+", " +\\(",
      year = "\\d+", "\\)"
    )
  )
ratings
#> # A tibble: 250 × 4
#>   rank  title                    year  rating
#>   <chr> <chr>                    <chr>  <dbl>
#> 1 1     The Shawshank Redemption 1994     9.2
#> 2 2     The Godfather            1972     9.1
#> 3 3     The Godfather: Part II   1974     9
#> 4 4     The Dark Knight          2008     9
#> 5 5     12 Angry Men             1957     8.9
#> 6 6     Schindler's List         1993     8.9
#> # ℹ 244 more rows
Verilerin çoğunun tablo hücrelerinden geldiği bu durumda bile ham HTML’e bakmak yararlıdır. Bunu yaptığınızda özniteliklerden birini kullanarak biraz ek veri ekleyebileceğimizi keşfedersiniz. Sayfanın kaynağını biraz araştırmaya değer olmasının nedenlerinden biri budur: Ek veriler ya da biraz daha kolay bir ayrıştırma yolu bulabilirsiniz.
html |>
  html_elements("td strong") |>
  head() |>
  html_attr("title")
#> [1] "9.2 based on 2,536,415 user ratings"
#> [2] "9.1 based on 1,745,675 user ratings"
#> [3] "9.0 based on 1,211,032 user ratings"
#> [4] "9.0 based on 2,486,931 user ratings"
#> [5] "8.9 based on 749,563 user ratings"
#> [6] "8.9 based on 1,295,705 user ratings"
Bunu tablo verileriyle birleştirebilir ve ilgilendiğimiz veri bölümünü çıkarmak için yeniden separate_wider_regex() uygulayabiliriz:
ratings |>
  mutate(
    rating_n = html |> html_elements("td strong") |> html_attr("title")
  ) |>
  separate_wider_regex(
    rating_n,
    patterns = c(
      "[0-9.]+ based on ",
      number = "[0-9,]+",
      " user ratings"
    )
  ) |>
  mutate(
    number = parse_number(number)
  )
#> # A tibble: 250 × 5
#>   rank  title                    year  rating  number
#>   <chr> <chr>                    <chr>  <dbl>   <dbl>
#> 1 1     The Shawshank Redemption 1994     9.2 2536415
#> 2 2     The Godfather            1972     9.1 1745675
#> 3 3     The Godfather: Part II   1974     9   1211032
#> 4 4     The Dark Knight          2008     9   2486931
#> 5 5     12 Angry Men             1957     8.9  749563
#> 6 6     Schindler's List         1993     8.9 1295705
#> # ℹ 244 more rows
24.7 Dinamik siteler
Şimdiye kadar html_elements() fonksiyonunun tarayıcıda gördüklerinizi döndürdüğü web sitelerine odaklandık; döndürdüğü verilerin nasıl ayrıştırılacağını ve bu bilgilerin düzenli veri çerçevelerinde nasıl düzenleneceğini ele aldık. Ancak zaman zaman html_elements() ve benzerlerinin tarayıcıda gördüklerinize hiç benzemeyen sonuçlar döndürdüğü bir siteyle karşılaşırsınız. Çoğu durumda bunun nedeni, sayfa içeriğini JavaScript ile dinamik olarak üreten bir web sitesini kazımaya çalışmanızdır. rvest ham HTML’i indirip JavaScript çalıştırmadığından bu yaklaşım şu anda rvest ile çalışmaz.
Bu tür siteleri kazımak yine de mümkündür; ancak rvest’ın tüm JavaScript’i çalıştırmak dahil web tarayıcısını bütünüyle benzeten, daha maliyetli bir süreç kullanması gerekir. Bu işlev bu satırlar yazılırken kullanılabilir değildir; ancak üzerinde etkin olarak çalışıyoruz ve siz bu satırları okurken kullanıma sunulmuş olabilir. Arka planda Chrome tarayıcısını gerçekten çalıştıran chromote paketini kullanır ve bir insanın metin yazması ya da düğmelere tıklaması gibi siteyle etkileşim kurmak için ek araçlar sağlar. Daha fazla ayrıntı için rvest web sitesine bakın.
24.8 Özet
Bu bölümde web sayfalarından veri kazımanın nedenlerini, neden yapılmaması gerekebileceğini ve nasıl yapılacağını öğrendiniz. Önce HTML’in temellerini ve belirli öğelere başvurmak için CSS seçicilerini kullanmayı, ardından HTML’den R’a veri içe aktarmak için rvest paketini kullanmayı öğrendiniz. Sonra web kazımayı iki örnek olayla gösterdik: rvest paketinin web sitesinden Star Wars filmleri hakkındaki verileri kazıdığımız daha basit bir durum ve IMDb’deki en iyi 250 filmi kazıdığımız daha karmaşık bir durum.
Özellikle dinamik siteler söz konusu olduğunda web’den veri kazımanın teknik ayrıntıları karmaşık olabilir; ancak hukuki ve etik değerlendirmeler daha da karmaşık olabilir. Veri kazımaya başlamadan önce bu iki konuda da kendinizi bilgilendirmeniz önemlidir.
Böylece kitabın içe aktarma kısmının sonuna geldik. Bu kısımda verileri bulundukları yerden (hesap çizelgeleri, veritabanları, JSON dosyaları ve web siteleri) alıp R’da düzenli bir biçime getirme tekniklerini öğrendiniz. Artık yeni bir konuya yönelme zamanı: Bir programlama dili olarak R’dan en iyi biçimde yararlanmak.
Ayrıca birçok popüler API’yi sarmalayan CRAN paketleri zaten vardır; bu nedenle işe biraz araştırma yaparak başlayın!↩︎
Elbette hukukçu değiliz ve bu bir hukuki tavsiye değildir. Ancak konu hakkında çok şey okuduktan sonra sunabildiğimiz en iyi özet budur.↩︎
OkCupid çalışması üzerine yazılmış makalelerden biri Wired tarafından yayımlanmıştır: https://www.wired.com/2016/05/okcupid-study-reveals-perils-big-data-science.↩︎
Bazı etiketler (
<p>ve<li>dahil) bitiş etiketi gerektirmez; ancak HTML’in yapısını görmeyi biraz kolaylaştırdığı için bunları eklemenin en iyisi olduğunu düşünüyoruz.↩︎Bu sınıf xml2 paketinden gelir. xml2, rvest’ın üzerine kurulduğu düşük düzeyli bir pakettir.↩︎
rvest
html_text()fonksiyonunu da sağlar; ancak iç içe HTML’i metne dönüştürme işini daha iyi yaptığı için neredeyse her zamanhtml_text2()kullanmalısınız.↩︎