16 Faktörler
16.1 Giriş
Faktörler, olası değerleri sabit ve bilinen kategorik değişkenler için kullanılır. Karakter vektörlerini alfabetik olmayan bir sırada görüntülemek istediğinizde de yararlıdır.
Önce veri analizinde faktörlere neden ihtiyaç duyulduğunu1 ve factor() ile nasıl oluşturulduklarını açıklayacağız. Ardından, üzerinde denemeler yapabileceğiniz birçok kategorik değişken içeren gss_cat veri kümesini tanıtacağız. Sonrasında bu veri kümesini kullanarak faktörlerin sırasını ve değerlerini değiştirme alıştırmaları yapacak, bölümü sıralı faktörleri ele alarak bitireceğiz.
16.1.1 Ön koşullar
Temel R, faktörleri oluşturmak ve işlemek için bazı temel araçlar sağlar. Bunları, temel tidyverse’in bir parçası olan forcats paketiyle tamamlayacağız. Bu paket, faktörlerle çalışmaya yönelik çok çeşitli yardımcılar aracılığıyla kategorik değişkenleri ele alan araçlar sunar. Adı, İngilizce categorical sözcüğündeki cat bölümüne gönderme yapar ve aynı zamanda factors sözcüğünün anagramıdır!
16.2 Faktörlerin temelleri
Ay bilgisini kaydeden bir değişkeniniz olduğunu düşünün:
x1 <- c("Dec", "Apr", "Jan", "Mar")Bu değişkeni bir karakter dizisiyle kaydetmenin iki sorunu vardır:
-
Yalnızca on iki olası ay vardır ancak yazım hatası yapmanızı önleyen hiçbir şey yoktur:
x2 <- c("Dec", "Apr", "Jam", "Mar") -
Yararlı bir biçimde sıralanmaz:
sort(x1)
#> [1] "Apr" "Dec" "Jan" "Mar"
Bu iki sorunu da bir faktörle çözebilirsiniz. Faktör oluşturmak için önce geçerli düzeylerin bir listesini oluşturmalısınız:
month_levels <- c(
  "Jan", "Feb", "Mar", "Apr", "May", "Jun",
  "Jul", "Aug", "Sep", "Oct", "Nov", "Dec"
)
Artık bir faktör oluşturabilirsiniz:
Düzeylerde bulunmayan değerler herhangi bir uyarı verilmeden NA’ya dönüştürülür:
y2 <- factor(x2, levels = month_levels)
y2
#> [1] Dec  Apr  <NA> Mar
#> Levels: Jan Feb Mar Apr May Jun Jul Aug Sep Oct Nov Dec
Bu riskli göründüğünden bunun yerine forcats::fct() kullanmak isteyebilirsiniz:
y2 <- fct(x2, levels = month_levels)
#> Error in `fct()`:
#> ! All values of `x` must appear in `levels` or `na`
#> ℹ Missing level: "Jam"
Düzeyleri belirtmezseniz verilerden alfabetik sırayla alınırlar:
factor(x1)
#> [1] Dec Apr Jan Mar
#> Levels: Apr Dec Jan Mar
Her bilgisayar karakter dizilerini aynı şekilde sıralamayacağı için alfabetik sıralama biraz risklidir. Bu nedenle forcats::fct() ilk görünme sırasını kullanır:
fct(x1)
#> [1] Dec Apr Jan Mar
#> Levels: Dec Apr Jan Mar
Geçerli düzeyler kümesine doğrudan erişmeniz gerekirse levels() kullanabilirsiniz:
levels(y2)
#>  [1] "Jan" "Feb" "Mar" "Apr" "May" "Jun" "Jul" "Aug" "Sep" "Oct" "Nov" "Dec"
Verilerinizi readr ile okurken col_factor() kullanarak da faktör oluşturabilirsiniz:
csv <- "
month,value
Jan,12
Feb,56
Mar,12"

df <- read_csv(csv, col_types = cols(month = col_factor(month_levels)))
#> Warning: The `file` argument of `read_csv()` should use `I()` for literal data as of
#> readr 2.2.0.
#>
#>   # Bad (for example):
#>   read_csv("x,y\n1,2")
#>
#>   # Good:
#>   read_csv(I("x,y\n1,2"))
df$month
#> [1] Jan Feb Mar
#> Levels: Jan Feb Mar Apr May Jun Jul Aug Sep Oct Nov Dec
16.3 Genel Sosyal Araştırma
Bu bölümün geri kalanında forcats::gss_cat veri kümesini kullanacağız. Bu, Chicago Üniversitesindeki bağımsız araştırma kuruluşu NORC tarafından uzun süredir yürütülen ABD merkezli General Social Survey araştırmasından alınmış bir veri örneğidir. Araştırma binlerce soru içerdiğinden Hadley, faktörlerle çalışırken karşılaşacağınız bazı yaygın güçlükleri gösterecek küçük bir bölümü gss_cat için seçmiştir.
gss_cat
#> # A tibble: 21,483 × 9
#>    year marital         age race  rincome        partyid
#>   <int> <fct>         <int> <fct> <fct>          <fct>
#> 1  2000 Never married    26 White $8000 to 9999  Ind,near rep
#> 2  2000 Divorced         48 White $8000 to 9999  Not str republican
#> 3  2000 Widowed          67 White Not applicable Independent
#> 4  2000 Never married    39 White Not applicable Ind,near rep
#> 5  2000 Divorced         25 White Not applicable Not str democrat
#> 6  2000 Married          25 White $20000 - 24999 Strong democrat
#> # ℹ 21,477 more rows
#> # ℹ 3 more variables: relig <fct>, denom <fct>, tvhours <int>
(Bu veri kümesi bir paket tarafından sağlandığı için değişkenler hakkında ?gss_cat ile daha fazla bilgi alabileceğinizi unutmayın.)
Faktörler bir tibble’da saklandığında düzeylerini kolayca göremezsiniz. Bunları görüntülemenin bir yolu count() kullanmaktır:
gss_cat |>
  count(race)
#> # A tibble: 3 × 2
#>   race      n
#>   <fct> <int>
#> 1 Other  1959
#> 2 Black  3129
#> 3 White 16395
Faktörlerle çalışırken en sık yapılan iki işlem, düzeylerin sırasını ve değerlerini değiştirmektir. Bu işlemler aşağıdaki bölümlerde açıklanmaktadır.
16.3.1 Alıştırmalar
rincome(bildirilen gelir) dağılımını inceleyin. Varsayılan çubuk grafiği anlamayı zorlaştıran nedir? Grafiği nasıl iyileştirebilirsiniz?Bu araştırmada en yaygın
relignedir? En yaygınpartyidnedir?denom(mezhep) hangireligiçin geçerlidir? Bunu bir tabloyla nasıl bulabilirsiniz? Bir görselleştirmeyle nasıl bulabilirsiniz?
16.4 Faktör sırasını değiştirme
Bir görselleştirmede faktör düzeylerinin sırasını değiştirmek çoğu zaman yararlıdır. Örneğin dinlere göre günde ortalama kaç saat televizyon izlendiğini incelemek istediğinizi düşünün:
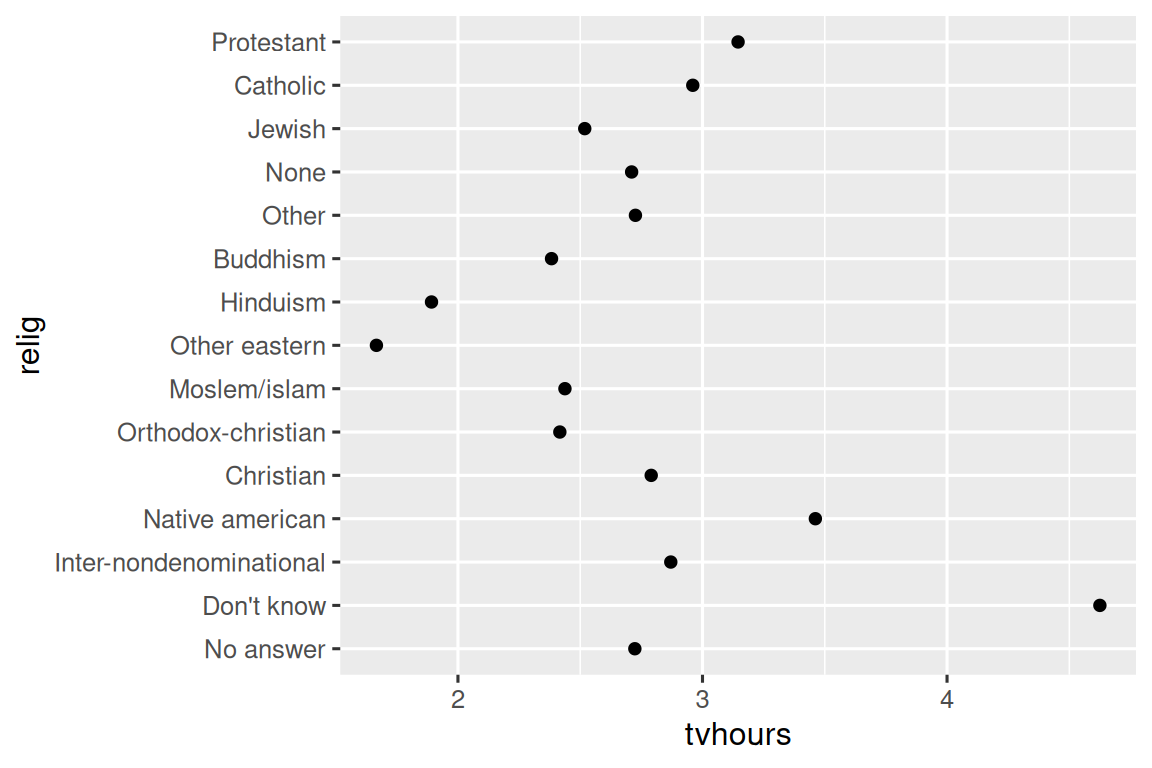
Genel bir örüntü olmadığı için bu grafiği okumak zordur. fct_reorder() kullanarak relig düzeylerini yeniden sıralayıp grafiği iyileştirebiliriz. fct_reorder() üç argüman alır:
-
.f: Düzeylerini değiştirmek istediğiniz faktör. -
.x: Düzeyleri yeniden sıralamak için kullanmak istediğiniz sayısal vektör. - İsteğe bağlı
.fun: Her.fdeğeri için birden çok.xdeğeri varsa kullanılan fonksiyon. Varsayılan değerimedian’dır.
ggplot(relig_summary, aes(x = tvhours, y = fct_reorder(relig, tvhours))) +
  geom_point()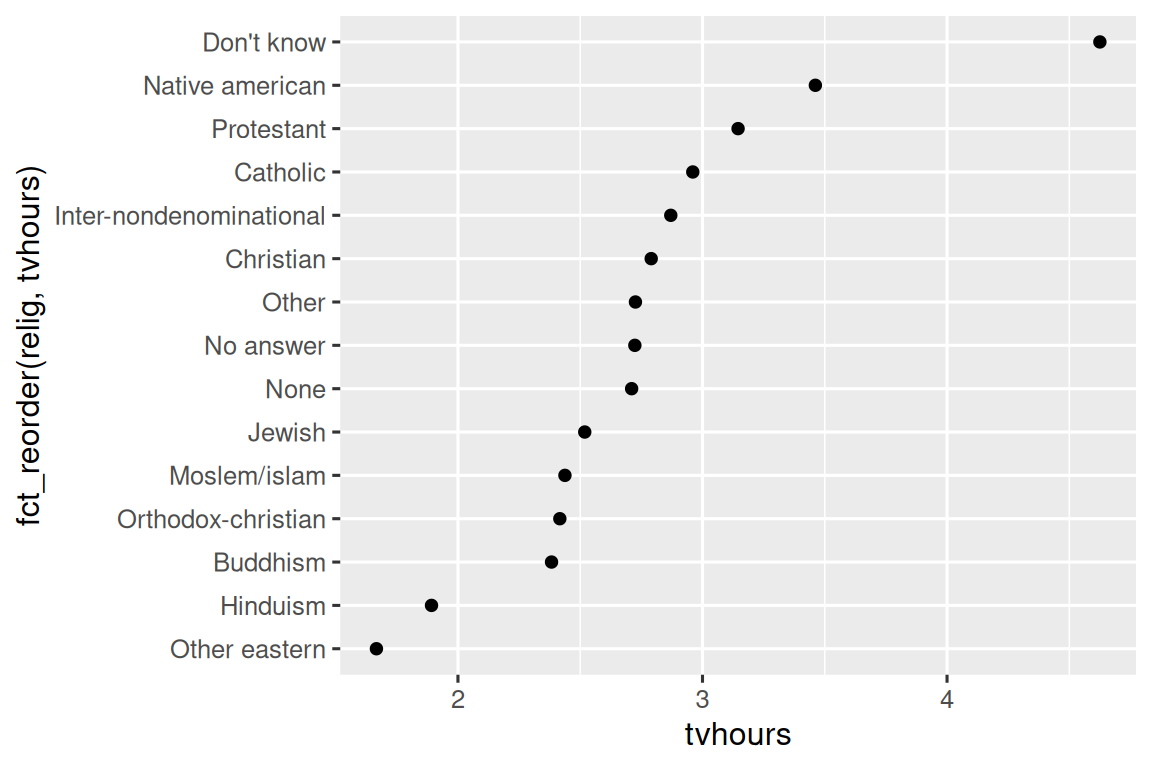
Dinleri yeniden sıralamak, “Don’t know” kategorisindeki kişilerin çok daha fazla; Hinduizm ve diğer Doğu dinlerindeki kişilerin ise çok daha az televizyon izlediğini görmeyi kolaylaştırır.
Daha karmaşık dönüşümler yapmaya başladığınızda bunları aes() dışına, ayrı bir mutate() adımına taşımanızı öneririz. Örneğin yukarıdaki grafiği şöyle yeniden yazabilirsiniz:
relig_summary |>
  mutate(
    relig = fct_reorder(relig, tvhours)
  ) |>
  ggplot(aes(x = tvhours, y = relig)) +
  geom_point()
Bildirilen gelir düzeylerine göre ortalama yaşın nasıl değiştiğini gösteren benzer bir grafik oluştursak ne olur?
rincome_summary <- gss_cat |>
  group_by(rincome) |>
  summarize(
    age = mean(age, na.rm = TRUE),
    n = n()
  )

ggplot(rincome_summary, aes(x = age, y = fct_reorder(rincome, age))) +
  geom_point()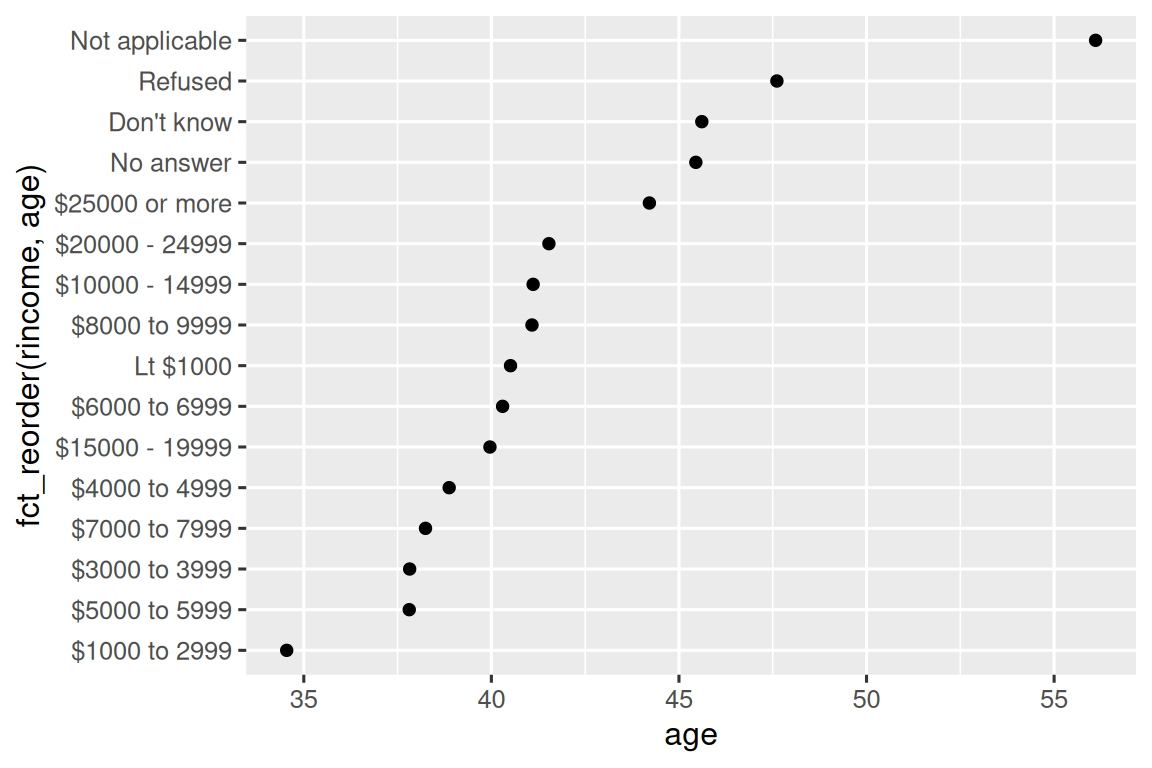
Burada düzeyleri gelişigüzel yeniden sıralamak iyi bir fikir değildir! Çünkü rincome zaten bozmamamız gereken anlamlı bir sıraya sahiptir. fct_reorder() fonksiyonunu düzeyleri gelişigüzel sıralanmış faktörler için kullanın.
Ancak “Not applicable” düzeyini diğer özel düzeylerle birlikte öne almak anlamlıdır. Bunun için fct_relevel() kullanabilirsiniz. Bu fonksiyon bir .f faktörü ve ardından sıranın önüne taşımak istediğiniz herhangi bir sayıda düzey alır.
ggplot(rincome_summary, aes(x = age, y = fct_relevel(rincome, "Not applicable"))) +
  geom_point()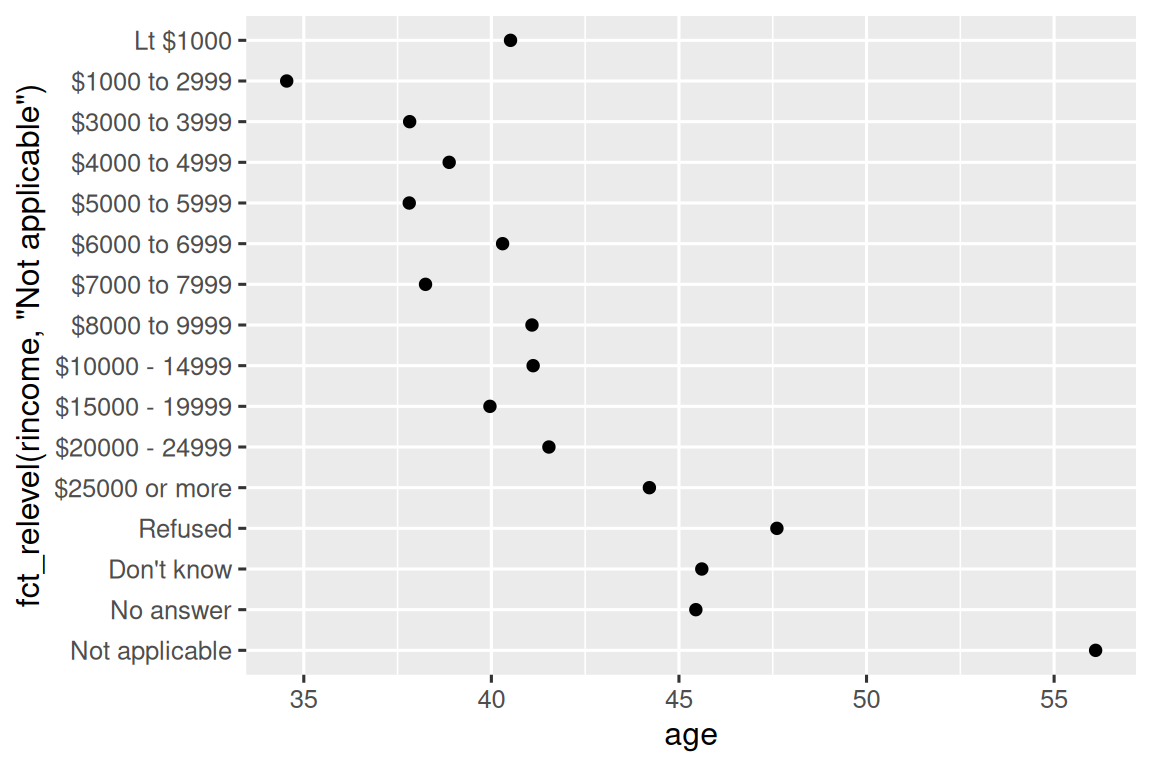
“Not applicable” için ortalama yaşın neden bu kadar yüksek olduğunu düşünüyorsunuz?
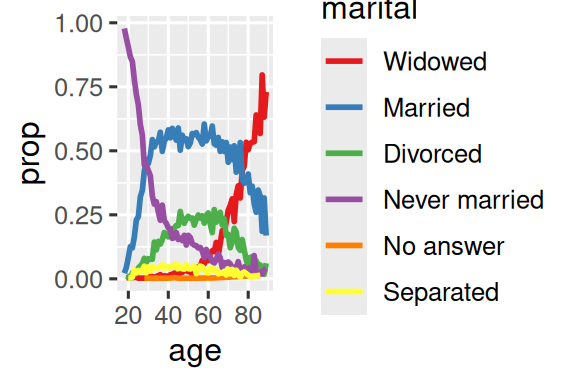
Bir grafikteki çizgileri renklendirirken başka bir yeniden sıralama türü yararlıdır. fct_reorder2(.f, .x, .y), .f faktörünü en büyük .x değerleriyle ilişkili .y değerlerine göre yeniden sıralar. Grafiğin en sağındaki çizgilerin renkleri göstergeyle eşleşeceği için bu, grafiğin okunmasını kolaylaştırır.
by_age <- gss_cat |>
  filter(!is.na(age)) |>
  count(age, marital) |>
  group_by(age) |>
  mutate(
    prop = n / sum(n)
  )

ggplot(by_age, aes(x = age, y = prop, color = marital)) +
  geom_line(linewidth = 1) +
  scale_color_brewer(palette = "Set1")

ggplot(by_age, aes(x = age, y = prop, color = fct_reorder2(marital, age, prop))) +
  geom_line(linewidth = 1) +
  scale_color_brewer(palette = "Set1") +
  labs(color = "marital")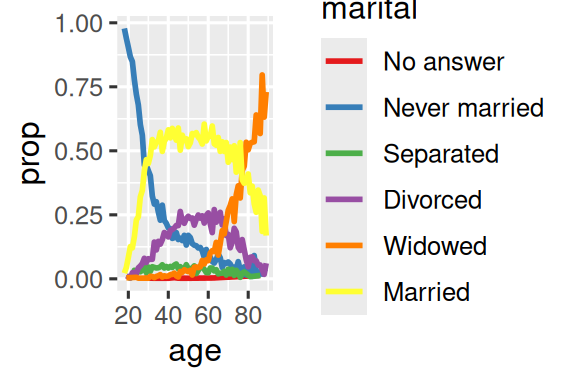
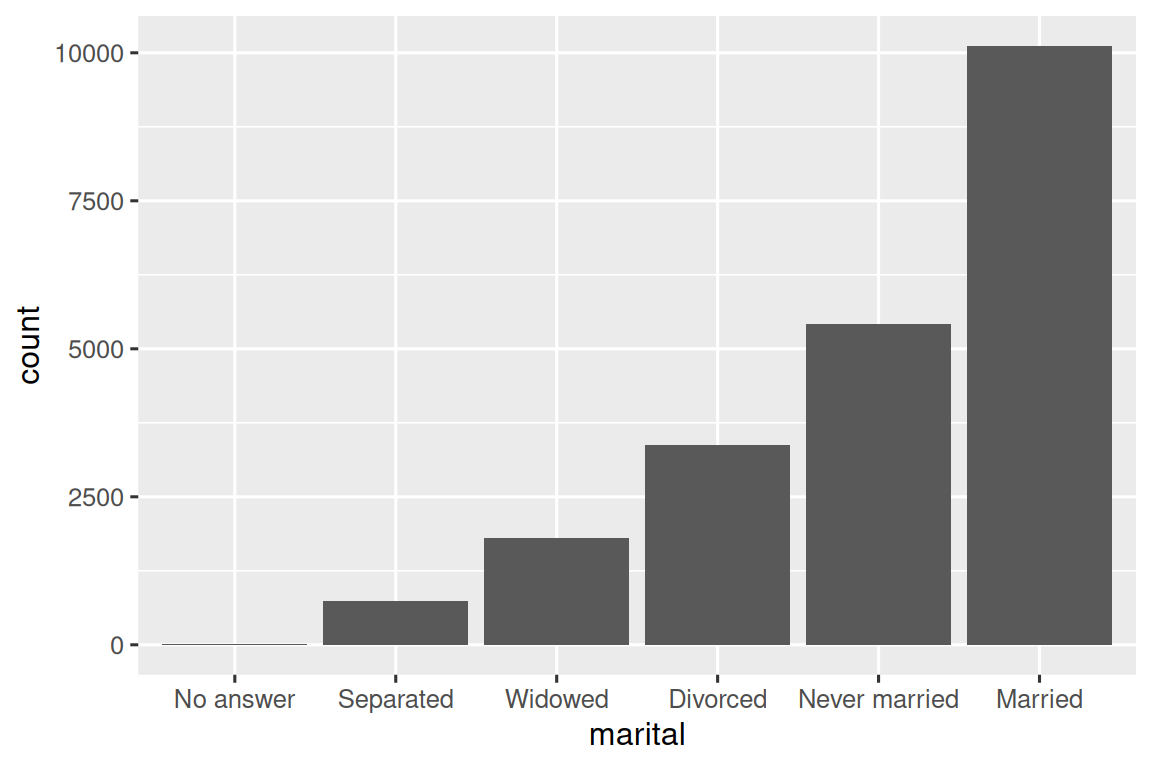
Son olarak çubuk grafiklerde düzeyleri azalan sıklığa göre sıralamak için fct_infreq() kullanabilirsiniz. Ek bir değişken gerektirmediği için bu, en basit yeniden sıralama türüdür. Çubuk grafikte en büyük değerlerin solda değil sağda yer alması için düzeyleri artan sıklığa göre sıralamak istiyorsanız bunu fct_rev() ile birleştirin.
16.4.1 Alıştırmalar
tvhoursiçinde kuşku uyandıracak kadar yüksek bazı sayılar vardır. Ortalama iyi bir özet midir?gss_catiçindeki her faktör için düzey sırasının gelişigüzel mi yoksa anlamlı mı olduğunu belirleyin.“Not applicable” düzeyini sıranın önüne taşımak neden grafiğin en altına taşıdı?
16.5 Faktör düzeylerini değiştirme
Düzeylerin sırasını değiştirmekten daha güçlü olan işlem, değerlerini değiştirmektir. Bu işlem yayımlama için etiketleri netleştirmenize ve üst düzey gösterimler için düzeyleri birleştirmenize olanak tanır. En genel ve güçlü araç fct_recode() fonksiyonudur. Her düzeyin değerini yeniden kodlamanızı, yani değiştirmenizi sağlar. Örneğin gss_cat veri çerçevesindeki partyid değişkenini ele alalım:
gss_cat |> count(partyid)
#> # A tibble: 10 × 2
#>   partyid                n
#>   <fct>              <int>
#> 1 No answer            154
#> 2 Don't know             1
#> 3 Other party          393
#> 4 Strong republican   2314
#> 5 Not str republican  3032
#> 6 Ind,near rep        1791
#> # ℹ 4 more rows
Düzeyler kısa ve tutarsızdır. Bunları daha uzun ve paralel bir yapıda olacak biçimde düzenleyelim. tidyverse’teki çoğu yeniden adlandırma ve kodlama fonksiyonunda olduğu gibi yeni değerler sola, eski değerler sağa yazılır:
gss_cat |>
  mutate(
    partyid = fct_recode(partyid,
      "Republican, strong"    = "Strong republican",
      "Republican, weak"      = "Not str republican",
      "Independent, near rep" = "Ind,near rep",
      "Independent, near dem" = "Ind,near dem",
      "Democrat, weak"        = "Not str democrat",
      "Democrat, strong"      = "Strong democrat"
    )
  ) |>
  count(partyid)
#> # A tibble: 10 × 2
#>   partyid                   n
#>   <fct>                 <int>
#> 1 No answer               154
#> 2 Don't know                1
#> 3 Other party             393
#> 4 Republican, strong     2314
#> 5 Republican, weak       3032
#> 6 Independent, near rep  1791
#> # ℹ 4 more rowsfct_recode(), açıkça belirtilmeyen düzeyleri olduğu gibi bırakır ve yanlışlıkla var olmayan bir düzeye başvurursanız sizi uyarır.
Grupları birleştirmek için birden çok eski düzeyi aynı yeni düzeye atayabilirsiniz:
gss_cat |>
  mutate(
    partyid = fct_recode(partyid,
      "Republican, strong"    = "Strong republican",
      "Republican, weak"      = "Not str republican",
      "Independent, near rep" = "Ind,near rep",
      "Independent, near dem" = "Ind,near dem",
      "Democrat, weak"        = "Not str democrat",
      "Democrat, strong"      = "Strong democrat",
      "Other"                 = "No answer",
      "Other"                 = "Don't know",
      "Other"                 = "Other party"
    )
  )
Bu tekniği dikkatle kullanın: Gerçekten farklı kategorileri bir araya getirirseniz yanıltıcı sonuçlar elde edersiniz.
Çok sayıda düzeyi birleştirmek istiyorsanız fct_collapse(), fct_recode() fonksiyonunun yararlı bir çeşididir. Her yeni değişken için eski düzeylerden oluşan bir vektör sağlayabilirsiniz:
gss_cat |>
  mutate(
    partyid = fct_collapse(partyid,
      "other" = c("No answer", "Don't know", "Other party"),
      "rep" = c("Strong republican", "Not str republican"),
      "ind" = c("Ind,near rep", "Independent", "Ind,near dem"),
      "dem" = c("Not str democrat", "Strong democrat")
    )
  ) |>
  count(partyid)
#> # A tibble: 4 × 2
#>   partyid     n
#>   <fct>   <int>
#> 1 other     548
#> 2 rep      5346
#> 3 ind      8409
#> 4 dem      7180
Bazen bir grafiği ya da tabloyu basitleştirmek için yalnızca küçük grupları bir araya getirmek istersiniz. Bu, fct_lump_*() fonksiyon ailesinin görevidir. fct_lump_lowfreq(), en küçük grup kategorilerini aşamalı olarak “Other” altında birleştiren ve “Other”ı her zaman en küçük kategori olarak tutan basit bir başlangıç noktasıdır.
gss_cat |>
  mutate(relig = fct_lump_lowfreq(relig)) |>
  count(relig)
#> # A tibble: 2 × 2
#>   relig          n
#>   <fct>      <int>
#> 1 Protestant 10846
#> 2 Other      10637
Bu durumda pek yararlı değildir: Araştırmadaki Amerikalıların çoğunluğunun Protestan olduğu doğrudur ancak muhtemelen biraz daha ayrıntı görmek isteriz! Bunun yerine tam olarak 10 grup istediğimizi belirtmek için fct_lump_n() kullanabiliriz:
gss_cat |>
  mutate(relig = fct_lump_n(relig, n = 10)) |>
  count(relig, sort = TRUE)
#> # A tibble: 10 × 2
#>   relig          n
#>   <fct>      <int>
#> 1 Protestant 10846
#> 2 Catholic    5124
#> 3 None        3523
#> 4 Christian    689
#> 5 Other        458
#> 6 Jewish       388
#> # ℹ 4 more rows
Başka durumlarda yararlı olan fct_lump_min() ve fct_lump_prop() hakkında bilgi edinmek için belgelendirmeyi okuyun.
16.5.1 Alıştırmalar
Kendini Demokrat, Cumhuriyetçi ve Bağımsız olarak tanımlayan kişilerin oranları zaman içinde nasıl değişmiştir?
rincomedeğişkenini az sayıda kategori altında nasıl birleştirebilirsiniz?Yukarıdaki
fct_lumpörneğinde other dışında 9 grup olduğuna dikkat edin. Neden 10 değil? (İpucu:?fct_lumpyazın veother_levelargümanının varsayılan değerinin “Other” olduğunu bulun.)
16.6 Sıralı faktörler
Devam etmeden önce özel bir faktör türünden kısaca söz etmek önemlidir: sıralı faktörler. ordered() fonksiyonuyla oluşturulan sıralı faktörler, düzeyler arasında kesin bir sıra bulunduğunu belirtir ancak düzeyler arasındaki farkların büyüklüğü hakkında bilgi vermez. Düzeylerin sıralı olduğunu bildiğiniz ancak kesin bir sayısal sıralamanın bulunmadığı durumlarda sıralı faktörleri kullanırsınız.
Yazdırılan bir sıralı faktörü, faktör düzeyleri arasında < işaretleri kullanmasından tanıyabilirsiniz:
Hem temel R’da hem de tidyverse’te sıralı faktörler normal faktörlere çok benzer davranır. Farklı davranışı yalnızca iki yerde fark edebilirsiniz:
- Sıralı bir faktörü ggplot2’de renk veya dolguya eşlerseniz varsayılan olarak sıralama belirten bir renk ölçeği olan
scale_color_viridis()/scale_fill_viridis()kullanılır. - Doğrusal bir modelde sıralı bir yordayıcı kullanırsanız model “polinom karşıtlıklarını” kullanır. Bunlar bir ölçüde yararlıdır ancak istatistik doktoranız yoksa adlarını duymuş olmanız pek olası değildir; doktoranız olsa bile muhtemelen bunları düzenli olarak yorumlamıyorsunuzdur. Daha fazla bilgi edinmek için Lisa DeBruine’in
vignette("contrasts", package = "faux")belgesini öneririz.
Bu kitabın amaçları açısından normal ve sıralı faktörleri doğru ayırt etmek özellikle önemli değildir. Ancak daha genel olarak bazı alanlar, özellikle sosyal bilimler, sıralı faktörleri yaygın biçimde kullanır. Bu bağlamlarda diğer analiz paketlerinin uygun davranışı sunabilmesi için onları doğru tanımlamak önemlidir.
16.7 Özet
Bu bölüm faktörlerle çalışmaya yönelik kullanışlı forcats paketini tanıttı ve en sık kullanılan fonksiyonları ele aldı. forcats burada ele almaya yer bulamadığımız çok çeşitli başka yardımcılar da içerir. Bu nedenle daha önce karşılaşmadığınız bir faktör analizi problemiyle uğraşırken sorununuzu çözmeye yardımcı olacak hazır bir fonksiyon bulunup bulunmadığını görmek için referans dizinine göz atmanızı önemle öneririz.
Bu bölümü okuduktan sonra faktörler hakkında daha fazla bilgi edinmek isterseniz Amelia McNamara ve Nicholas Horton’ın Wrangling categorical data in R makalesini öneririz. Bu makale stringsAsFactors: An unauthorized biography ile stringsAsFactors = <sigh> yazılarında ele alınan tarihçenin bir bölümünü aktarır ve bu kitapta açıklanan kategorik verilere yönelik tidy yaklaşımlarını temel R yöntemleriyle karşılaştırır. Makalenin erken bir sürümü forcats paketinin gerekçesini ve kapsamını belirlemeye yardımcı oldu; teşekkürler Amelia ve Nick!
Bir sonraki bölümde yön değiştirip R’da tarih ve saatleri öğrenmeye başlayacağız. Tarih ve saatler aldatıcı biçimde basit görünür; ancak birazdan göreceğiniz gibi onlar hakkında daha fazla şey öğrendikçe daha karmaşık hâle gelirler!
Faktörler modelleme için de çok önemlidir.↩︎