27 Temel R için bir alan kılavuzu
27.1 Giriş
Programlama kısmını tamamlamak için kitapta başka bir yerde ele almadığımız en önemli temel R fonksiyonlarını kısaca tanıtacağız. Bu araçlar daha fazla programlama yaptıkça özellikle kullanışlı olacak ve doğal ortamında karşılaşacağınız kodları okumanıza yardımcı olacaktır.
Veri bilimi problemlerini çözmenin tek yolunun tidyverse olmadığını hatırlatmak için burası iyi bir yerdir. Bu kitapta tidyverse’i öğretiyoruz; çünkü tidyverse paketleri ortak bir tasarım felsefesini paylaşarak fonksiyonlar arasındaki tutarlılığı artırır ve her yeni fonksiyon ya da paketi öğrenip kullanmayı biraz kolaylaştırır. Temel R’ı kullanmadan tidyverse’i kullanmak mümkün değildir; dolayısıyla size aslında birçok temel R fonksiyonunu zaten öğrettik: Paketleri yükleyen library(), sayısal özetler için sum() ve mean(), faktör, tarih ve POSIXct veri türleri ve elbette +, -, /, *, |, & ve ! gibi tüm temel işleçler. Şimdiye kadar temel R iş akışlarına odaklanmadık; bu nedenle bu bölümde bunlardan birkaçını öne çıkaracağız.
Bu kitabı okuduktan sonra aynı problemlere temel R, data.table ve diğer paketleri kullanan başka yaklaşımlar öğreneceksiniz. Başkalarının yazdığı R kodlarını okumaya başladığınızda, özellikle Stack Overflow kullanıyorsanız bu diğer yaklaşımlarla kuşkusuz karşılaşacaksınız. Yaklaşımların karışımını kullanan kod yazmak kesinlikle uygundur; kimsenin size aksini söylemesine izin vermeyin!
Bu bölümde dört büyük konuya odaklanacağız: [ ile alt kümeleme, [[ ve $ ile alt kümeleme, apply fonksiyon ailesi ve for döngüleri. Son olarak iki temel grafik fonksiyonunu kısaca ele alacağız.
27.1.1 Ön koşullar
Bu bölüm temel R’a odaklandığı için gerçek bir ön koşulu yoktur; ancak bazı farkları açıklamak amacıyla tidyverse’i yükleyeceğiz.
27.2 [ ile birden çok öğe seçme
[, vektörlerden ve veri çerçevelerinden alt bileşenler çıkarmak için kullanılır ve x[i] ya da x[i, j] biçiminde çağrılır. Bu kısımda önce vektörlerle nasıl kullanabileceğinizi, ardından aynı ilkelerin veri çerçeveleri gibi iki boyutlu yapılara nasıl doğrudan genişlediğini göstererek [ işlecinin gücünü tanıtacağız. Sonra çeşitli dplyr fiillerinin [ işlecinin özel durumları olduğunu göstererek bu bilgiyi pekiştirmenize yardımcı olacağız.
27.2.1 Vektörleri alt kümeleme
Bir vektörü alt kümelemek için kullanabileceğiniz, yani x[i] içindeki i olabilecek beş temel tür vardır:
-
Pozitif tam sayılar vektörü. Pozitif tam sayılarla alt kümeleme, bu konumlardaki öğeleri korur:
Bir konumu yineleyerek girdiden daha uzun bir çıktı oluşturabilirsiniz; bu da “alt kümeleme” terimini biraz yanıltıcı kılar.
x[c(1, 1, 5, 5, 5, 2)] #> [1] "bir" "bir" "beş" "beş" "beş" "iki" -
Negatif tam sayılar vektörü. Negatif değerler belirtilen konumlardaki öğeleri çıkarır:
x[c(-1, -3, -5)] #> [1] "iki" "dört" -
Mantıksal vektör. Mantıksal vektörle alt kümeleme,
TRUEdeğerine karşılık gelen tüm değerleri korur. Bu en çok karşılaştırma fonksiyonlarıyla birlikte kullanıldığında yararlıdır.filter()fonksiyonundan farklı olarakNAdizinleri çıktıyaNAolarak dahil edilir. -
Karakter vektörü. Adlandırılmış bir vektörünüz varsa onu karakter vektörüyle alt kümelerine ayırabilirsiniz:
Pozitif tam sayılarla alt kümelemede olduğu gibi tek tek girdileri çoğaltmak için karakter vektörü kullanabilirsiniz.
Hiçbir şey. Son alt kümeleme türü,
xnesnesinin tamamını döndüren boşx[]ifadesidir. Vektörleri alt kümelemek için kullanışlı değildir; ancak birazdan göreceğimiz gibi tibble’lar gibi iki boyutlu yapıları alt kümelemek için yararlıdır.
27.2.2 Veri çerçevelerini alt kümeleme
[ işlecini bir veri çerçevesiyle kullanmanın epey farklı yolu vardır1; ancak en önemli kullanım, df[rows, cols] ile satır ve sütunları birbirinden bağımsız seçmektir. Burada rows ve cols, yukarıda açıklanan türde vektörlerdir. Örneğin df[rows, ] ve df[, cols], diğer boyutu korumak için boş alt küme kullanarak yalnızca satırları ya da sütunları seçer.
İşte birkaç örnek:
df <- tibble(
  x = 1:3,
  y = c("a", "e", "f"),
  z = runif(3)
)

# İlk satırı ve ikinci sütunu seç
df[1, 2]
#> # A tibble: 1 × 1
#>   y
#>   <chr>
#> 1 a

# Tüm satırlarla x ve y sütunlarını seç
df[, c("x" , "y")]
#> # A tibble: 3 × 2
#>       x y
#>   <int> <chr>
#> 1     1 a
#> 2     2 e
#> 3     3 f

# `x` değerinin 1'den büyük olduğu satırlarla tüm sütunları seç
df[df$x > 1, ]
#> # A tibble: 2 × 3
#>       x y         z
#>   <int> <chr> <dbl>
#> 1     2 e     0.834
#> 2     3 f     0.601
$ işlecine birazdan döneceğiz; ancak df$x ifadesinin ne yaptığını bağlamdan tahmin edebilmelisiniz: x değişkenini df içinden çıkarır. [ tidy evaluation kullanmadığından burada onu kullanmamız gerekir; dolayısıyla x değişkeninin kaynağını açıkça belirtmelisiniz.
[ söz konusu olduğunda tibble’larla veri çerçeveleri arasında önemli bir fark vardır. Bu kitapta çoğunlukla veri çerçevesi olan, ancak yaşamınızı biraz kolaylaştırmak için bazı davranışları değiştiren tibble’ları kullandık. Çoğu yerde “tibble” ve “veri çerçevesi” ifadelerini birbirinin yerine kullanabilirsiniz; dolayısıyla R’ın yerleşik veri çerçevesine özellikle dikkat çekmek istediğimizde data.frame yazacağız. df bir data.frame ise df[, cols], cols tek sütun seçtiğinde vektör, birden çok sütun seçtiğinde veri çerçevesi döndürür. df bir tibble ise [ her zaman tibble döndürür.
df1 <- data.frame(x = 1:3)
df1[, "x"]
#> [1] 1 2 3

df2 <- tibble(x = 1:3)
df2[, "x"]
#> # A tibble: 3 × 1
#>       x
#>   <int>
#> 1     1
#> 2     2
#> 3     3
data.frame nesnelerinde bu belirsizlikten kaçınmanın bir yolu drop = FALSE ayarını açıkça belirtmektir:
df1[, "x" , drop = FALSE]
#>   x
#> 1 1
#> 2 2
#> 3 3
27.2.3 dplyr karşılıkları
Birçok dplyr fiili [ işlecinin özel durumudur:
-
filter(), eksik değerleri dışarıda bırakmaya dikkat ederek satırları mantıksal bir vektörle alt kümelemeye eşdeğerdir:Doğal ortamında karşınıza çıkan kodlarda bir başka yaygın teknik, eksik değerleri çıkarma yan etkisi için
which()kullanmaktır:df[which(df$x > 1), ]. -
arrange(), satırları genellikleorder()ile oluşturulan tam sayı vektörüyle alt kümelemeye eşdeğerdir:Tüm sütunları azalan sırada sıralamak için
order(decreasing = TRUE), sütunları ayrı ayrı azalan sırada sıralamak için-rank(col)kullanabilirsiniz. -
Hem
select()hemrelocate(), sütunları karakter vektörüyle alt kümelemeye benzer:
Temel R ayrıca filter() ve select() fonksiyonlarının özelliklerini birleştiren subset() adlı bir fonksiyon sağlar2:
Bu fonksiyon dplyr sözdiziminin büyük bölümüne esin kaynağı olmuştur.
27.2.4 Alıştırmalar
-
Girdi olarak bir vektör alan ve aşağıdakileri döndüren fonksiyonlar oluşturun:
- Çift numaralı konumlardaki öğeler.
- Son değer dışındaki tüm öğeler.
- Yalnızca çift değerler (eksik değer olmadan).
x[-which(x > 0)]nedenx[x <= 0]ile aynı değildir? Bunu anlamak içinwhich()belgelerini okuyun ve bazı denemeler yapın.
27.3 $ ve [[ ile tek bir öğe seçme
Birden çok öğe seçen [, tek bir öğe çıkaran [[ ve $ ile eşleşir. Bu kısımda veri çerçevelerinden sütun çıkarmak için [[ ve $ kullanmayı gösterecek, data.frames nesneleriyle tibble’lar arasındaki birkaç farkı daha ele alacak ve listelerle kullanıldıklarında [ ile [[ arasındaki bazı önemli farkları vurgulayacağız.
27.3.1 Veri çerçeveleri
[[ ve $, bir veri çerçevesinden sütun çıkarmak için kullanılabilir. [[ konuma ya da ada göre erişebilir; $ ise ada göre erişim için özelleşmiştir:
Ayrıca mutate() fonksiyonunun temel R karşılığı olarak yeni sütunlar oluşturmak için de kullanılabilirler:
tb$z <- tb$x + tb$y
tb
#> # A tibble: 4 × 3
#>       x     y     z
#>   <int> <dbl> <dbl>
#> 1     1    10    11
#> 2     2     4     6
#> 3     3     1     4
#> 4     4    21    25
Yeni sütunlar oluşturmak için transform(), with() ve within() dahil başka temel R yaklaşımları da vardır. Hadley birkaç örneği https://gist.github.com/hadley/1986a273e384fb2d4d752c18ed71bedf adresinde toplamıştır.
Hızlı özetler yaparken $ işlecini doğrudan kullanmak elverişlidir. Örneğin yalnızca en büyük elmasın boyutunu ya da cut değişkeninin olası değerlerini bulmak istiyorsanız summarize() kullanmanıza gerek yoktur:
dplyr ayrıca Bölüm 3 bölümünde değinmediğimiz bir [[/$ karşılığı sağlar: pull(). pull() bir değişken adı ya da konumu alır ve yalnızca o sütunu döndürür. Bu, yukarıdaki kodu pipe operatörünü kullanacak biçimde yeniden yazabileceğimiz anlamına gelir:
27.3.2 Tibble’lar
$ söz konusu olduğunda tibble’larla temel data.frame nesneleri arasında birkaç önemli fark vardır. Veri çerçeveleri herhangi bir değişken adının önekiyle (kısmi eşleşme denen davranışla) eşleşir ve bir sütun yoksa şikâyet etmez:
df <- data.frame(x1 = 1)
df$x
#> [1] 1
df$z
#> NULL
Tibble’lar daha katıdır: Değişken adlarıyla yalnızca tam olarak eşleşir ve erişmeye çalıştığınız sütun yoksa uyarı üretirler:
tb <- tibble(x1 = 1)

tb$x
#> Warning: Unknown or uninitialised column: `x`.
#> NULL
tb$z
#> Warning: Unknown or uninitialised column: `z`.
#> NULL
Bu nedenle bazen tibble’ların tembel ve huysuz olduklarıyla ilgili şaka yaparız: Daha az iş yapar, daha çok şikâyet ederler.
27.3.3 Listeler
[[ ve $ listelerle çalışmak için de çok önemlidir; [ işlecinden nasıl farklı olduklarını anlamak gerekir. Farkları l adlı bir listeyle gösterelim:
-
[bir alt liste çıkarır. Kaç öğe çıkardığınız önemli değildir; sonuç her zaman liste olur.Vektörlerde olduğu gibi mantıksal, tam sayı ya da karakter vektörüyle alt kümeleme yapabilirsiniz.
-
[[ve$bir listeden tek bir bileşen çıkarır. Listeden bir hiyerarşi düzeyini kaldırırlar.
[ ile [[ arasındaki fark listeler için özellikle önemlidir; çünkü [[ listenin içine inerken [ yeni ve daha küçük bir liste döndürür. Farkı hatırlamanıza yardımcı olması için Şekil 27.1 içindeki sıra dışı karabiberliğe bakın. Bu karabiberlik pepper listenizse pepper[1], tek bir karabiber paketi içeren karabiberliktir. pepper[2] aynı görünür ancak ikinci paketi içerir. pepper[1:2] iki karabiber paketi içeren karabiberlik olur. pepper[[1]] ise karabiber paketinin kendisini çıkarır.
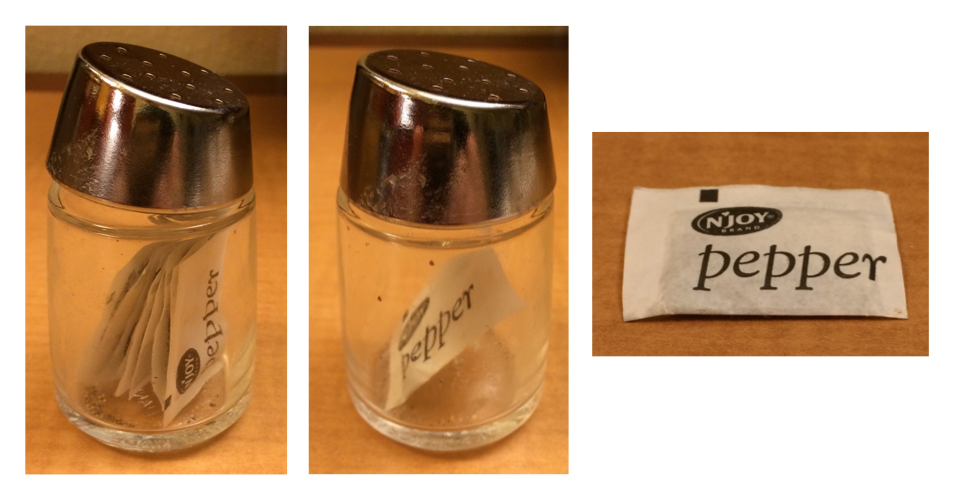
pepper[1]. (Sağda) pepper[[1]].
Aynı ilke [ işlecini veri çerçevesiyle tek boyutlu kullandığınızda da geçerlidir: df["x"] tek sütunlu bir veri çerçevesi, df[["x"]] ise vektör döndürür.
27.3.4 Alıştırmalar
[[işlecini vektörün uzunluğundan büyük pozitif bir tam sayıyla kullandığınızda ne olur? Var olmayan bir adla alt kümeleme yaptığınızda ne olur?pepper[[1]][1]ne olur? Peki yapepper[[1]][[1]]?
27.4 Apply ailesi
Bölüm 26 bölümünde dplyr::across() ve map fonksiyon ailesi gibi tidyverse iterasyon tekniklerini öğrendiniz. Bu kısımda bunların temel R karşılıkları olan apply ailesini öğreneceksiniz. Bu bağlamda apply ve map eş anlamlıdır; çünkü “bir fonksiyonu vektörün her öğesine eşlemek”, “bir fonksiyonu vektörün her öğesine uygulamak” demenin başka bir yoludur. Doğal ortamında karşılaştığınızda tanıyabilmeniz için burada bu aileyi kısaca tanıtacağız.
Bu ailenin en önemli üyesi, purrr::map() fonksiyonuna çok benzeyen lapply() fonksiyonudur3. Hatta map() fonksiyonunun gelişmiş özelliklerinden hiçbirini kullanmadığımız için Bölüm 26 bölümündeki her map() çağrısını lapply() ile değiştirebilirsiniz.
across() fonksiyonunun tam bir temel R karşılığı yoktur; ancak [ ile lapply() kullanarak benzer bir sonuç elde edebilirsiniz. Bu çalışır; çünkü perde arkasında veri çerçeveleri sütun listeleridir. Dolayısıyla bir veri çerçevesinde lapply() çağırmak fonksiyonu her sütuna uygular.
df <- tibble(a = 1, b = 2, c = "a", d = "b", e = 4)

# Önce sayısal sütunları bul
num_cols <- sapply(df, is.numeric)
num_cols
#>     a     b     c     d     e
#>  TRUE  TRUE FALSE FALSE  TRUE

# Ardından her sütunu lapply() ile dönüştürüp özgün değerleri değiştir
df[, num_cols] <- lapply(df[, num_cols, drop = FALSE], \(x) x * 2)
df
#> # A tibble: 1 × 5
#>       a     b c     d         e
#>   <dbl> <dbl> <chr> <chr> <dbl>
#> 1     2     4 a     b         8
Yukarıdaki kod yeni bir fonksiyon, sapply(), kullanır. lapply() fonksiyonuna benzer; ancak sonucu her zaman sadeleştirmeye çalışır, adındaki s buradan gelir. Burada liste yerine mantıksal vektör üretir. Sadeleştirme başarısız olup beklenmedik bir tür verebileceğinden programlamada kullanmanızı önermiyoruz; ancak etkileşimli kullanım için genellikle uygundur. purrr’ın Bölüm 26 bölümünde değinmediğimiz map_vec() adlı benzer bir fonksiyonu vardır.
Temel R, sapply() fonksiyonunun vector apply ifadesinin kısaltması olan daha katı vapply() sürümünü sağlar. Beklenen türü belirten ek bir argüman alarak girdiden bağımsız biçimde sadeleştirmenin aynı yolla gerçekleşmesini güvence altına alır. Örneğin yukarıdaki sapply() çağrısını, is.numeric() fonksiyonunun 1 uzunluğunda mantıksal vektör döndürmesini beklediğimizi belirttiğimiz bu vapply() çağrısıyla değiştirebiliriz:
sapply() ile vapply() arasındaki ayrım bir fonksiyonun içindeyken çok önemlidir (çünkü fonksiyonun olağan dışı girdilere karşı sağlamlığında büyük fark yaratır), ancak veri analizinde genellikle önemli değildir.
Apply ailesinin bir başka önemli üyesi, tek bir gruplanmış özet hesaplayan tapply() fonksiyonudur:
diamonds |>
  group_by(cut) |>
  summarize(price = mean(price))
#> # A tibble: 5 × 2
#>   cut       price
#>   <ord>     <dbl>
#> 1 Fair      4359.
#> 2 Good      3929.
#> 3 Very Good 3982.
#> 4 Premium   4584.
#> 5 Ideal     3458.

tapply(diamonds$price, diamonds$cut, mean)
#>      Fair      Good Very Good   Premium     Ideal
#>  4358.758  3928.864  3981.760  4584.258  3457.542
Ne yazık ki tapply() sonuçlarını adlandırılmış vektörde döndürür; birden çok özeti ve gruplama değişkenini bir veri çerçevesinde toplamak isterseniz biraz uğraşmanız gerekir. (Bunu yapmayıp bağımsız vektörlerle çalışmak elbette mümkündür; ancak deneyimlerimize göre bu yalnızca işi erteler.) Başka gruplanmış özetler oluşturmak için tapply() veya diğer temel R tekniklerini nasıl kullanabileceğinizi görmek isterseniz Hadley birkaç tekniği bir gist içinde toplamıştır.
Apply ailesinin son üyesi, matrisler ve dizilerle çalışan ve aileye adını veren apply() fonksiyonudur. Özellikle lapply(df, something) işlemini yapmanın yavaş ve potansiyel olarak tehlikeli bir yolu olan apply(df, 2, something) kullanımına dikkat edin. Genellikle matrislerle değil veri çerçeveleriyle çalıştığımız için bu, veri biliminde nadiren karşımıza çıkar.
27.5 for döngüleri
for döngüleri hem apply hem map ailelerinin perde arkasında kullandığı temel iterasyon yapı taşıdır. for döngüleri, daha deneyimli bir R programcısı olurken öğrenmeniz önemli olan güçlü ve genel araçlardır. Bir for döngüsünün temel yapısı şöyledir:
for (element in vector) {
  # element ile bir işlem yap
}
for döngülerinin en doğrudan kullanımı walk() ile aynı etkiyi elde etmektir: Bir listenin her öğesinde yan etkisi olan bir fonksiyon çağırmak. Örneğin Bölüm 26.4.1 bölümünde walk() kullanmak yerine:
paths |> walk(append_file)Bir for döngüsü kullanabilirdik:
for (path in paths) {
  append_file(path)
}
for döngüsünün çıktısını kaydetmek isterseniz işler biraz zorlaşır; örneğin Bölüm 26 bölümünde yaptığımız gibi bir dizindeki tüm Excel dosyalarını okumak:
paths <- dir("data/gapminder", pattern = "\\.xlsx$", full.names = TRUE)
files <- map(paths, readxl::read_excel)
Kullanabileceğiniz birkaç farklı teknik vardır; ancak çıktının nasıl görüneceğini baştan açıkça belirtmenizi öneririz. Bu durumda paths ile aynı uzunlukta bir liste isteyeceğiz; bunu vector() ile oluşturabiliriz:
Ardından paths öğeleri üzerinde iterasyon yapmak yerine her öğe için bir dizin üretmek üzere seq_along() kullanarak dizinleri üzerinde iterasyon yapacağız:
seq_along(paths)
#>  [1]  1  2  3  4  5  6  7  8  9 10 11 12
Dizinleri kullanmak önemlidir; çünkü girdideki her konumu çıktıdaki karşılık gelen konuma bağlamamızı sağlar:
for (i in seq_along(paths)) {
  files[[i]] <- readxl::read_excel(paths[[i]])
}
Tibble listesini tek bir tibble’da birleştirmek için do.call() + rbind() kullanabilirsiniz:
do.call(rbind, files)
#> # A tibble: 1,704 × 5
#>   country     continent lifeExp      pop gdpPercap
#>   <chr>       <chr>       <dbl>    <dbl>     <dbl>
#> 1 Afghanistan Asia         28.8  8425333      779.
#> 2 Albania     Europe       55.2  1282697     1601.
#> 3 Algeria     Africa       43.1  9279525     2449.
#> 4 Angola      Africa       30.0  4232095     3521.
#> 5 Argentina   Americas     62.5 17876956     5911.
#> 6 Australia   Oceania      69.1  8691212    10040.
#> # ℹ 1,698 more rows
Liste oluşturup sonuçları ilerledikçe kaydetmek yerine veri çerçevesini parça parça oluşturmak daha basit bir yaklaşımdır:
out <- NULL
for (path in paths) {
  out <- rbind(out, readxl::read_excel(path))
}
Vektör çok uzun olduğunda oldukça yavaşlayabildiği için bu örüntüden kaçınmanızı öneririz. for döngülerinin yavaş olduğuna ilişkin kalıcı söylentinin kaynağı budur: Döngüler yavaş değildir, ancak bir vektörü iterasyonla büyütmek yavaştır.
27.6 Grafikler
tidyverse’i başka türlü kullanmayan birçok R kullanıcısı, mantıklı varsayılanlar, otomatik göstergeler ve modern görünüm gibi kullanışlı özellikleri nedeniyle grafik çizmek için ggplot2’yi tercih eder. Ancak temel R grafik fonksiyonları çok kısa oldukları için yine de kullanışlı olabilir; temel bir keşif grafiği çizmek için çok az yazmak yeterlidir.
Doğal ortamında karşınıza çıkan kodlarda iki temel R grafik türü görürsünüz: Sırasıyla plot() ve hist() ile üretilen dağılım grafikleri ve histogramlar. İşte diamonds veri kümesinden kısa bir örnek:
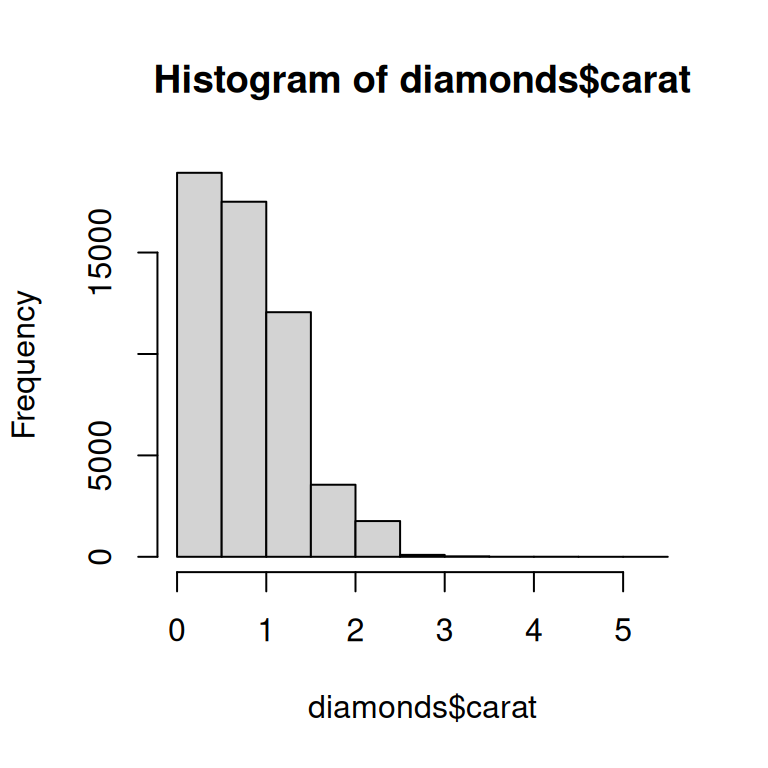
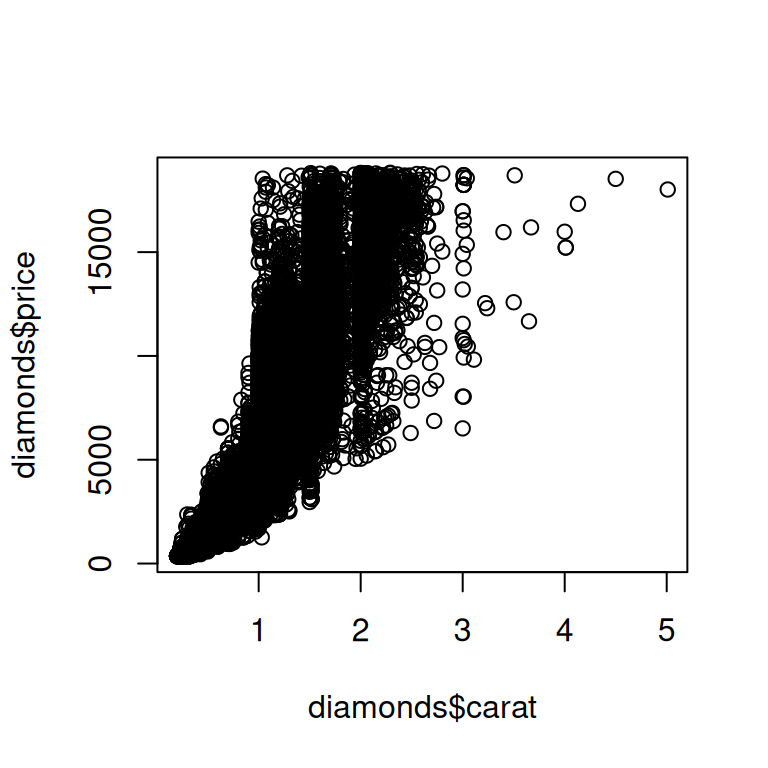
Temel R grafik fonksiyonlarının vektörlerle çalıştığına dikkat edin; dolayısıyla sütunları $ ya da başka bir teknikle veri çerçevesinden çıkarmanız gerekir.
27.7 Özet
Bu bölümde alt kümeleme ve iterasyon için kullanışlı bazı temel R fonksiyonlarını gösterdik. Kitabın başka yerlerinde ele alınan yaklaşımlarla karşılaştırıldığında bu fonksiyonlar “veri çerçevesi” yaklaşımından çok “vektör” yaklaşımına sahiptir; çünkü temel R fonksiyonları genellikle veri çerçevesi ve bazı sütun belirtimleri yerine tek tek vektörler alır. Bu, programlama sırasında yaşamı çoğu zaman kolaylaştırır; dolayısıyla daha fazla fonksiyon yazdıkça ve kendi paketlerinizi oluşturmaya başladıkça önem kazanır.
Bu bölüm kitabın programlama kısmını tamamlar. Yalnızca R kullanan değil, R’da programlama yapabilen bir veri bilimci olma yolculuğunuza sağlam bir başlangıç yaptınız. Bu bölümlerin programlamaya ilginizi artırdığını ve kitabın dışında daha fazlasını öğrenmeyi sabırsızlıkla beklediğinizi umuyoruz.
Bir veri çerçevesini tek boyutlu bir nesne gibi veya matrisle nasıl alt kümeleyebileceğinizi görmek için https://adv-r.hadley.nz/subsetting.html#subset-multiple adresini okuyun.↩︎
Ancak gruplanmış veri çerçevelerini farklı biçimde ele almaz ve
starts_with()gibi seçim yardımcılarını desteklemez.↩︎Yalnızca ilerleme çubukları ve hata durumunda probleme hangi öğenin neden olduğunu bildirme gibi kullanışlı özelliklerden yoksundur.↩︎